从单卡瓶颈到千亿参数:大模型分布式并行6大关键问题
从单卡计算本质出发,拆解大模型分布式并行的六个关键问题与学习路径。
本文基于B站教程,系统梳理了大模型从单卡到千亿参数分布式扩展的认知框架。文章首先回归计算本质:大模型采用decoder-only架构,逐token生成,核心运算是数据X乘以参数W得到Y,而X和W都需加载到GPU,单卡显存装不下千亿参数是分布式的根本动机。随后,文章将分布式并行拆解为六个关键问题:为何分布式、数据与参数如何切分、张量并行、流水线并行、专家并行与混合并行、通信与显存优化。最后,结合私有化部署场景,指出分布式是绕不开的工程问题,KV Cache会加剧显存压力,并建议按“单卡推理→数据并行→张量并行→流水线并行→混合并行”的顺序学习。
当私有化部署和模型训练成为刚需,单卡GPU的显存与算力瓶颈就再也绕不过去。B站这期教程从最基础的“大模型如何生成一个token”讲起,把分布式并行的核心问题拆成了六个可理解的模块。本文基于视频内容做一次系统梳理,帮你建立从单卡到千亿参数扩展的认知框架。
大模型的计算本质:X乘以W得到Y
要理解分布式,先得回到单卡上发生了什么。据B站教程中的讲解,大模型本质上是一个神经网络,当前主流架构是decoder-only(仅解码器)结构——它源自Transformer,但只保留了decoder部分,GPT系列就是典型代表。
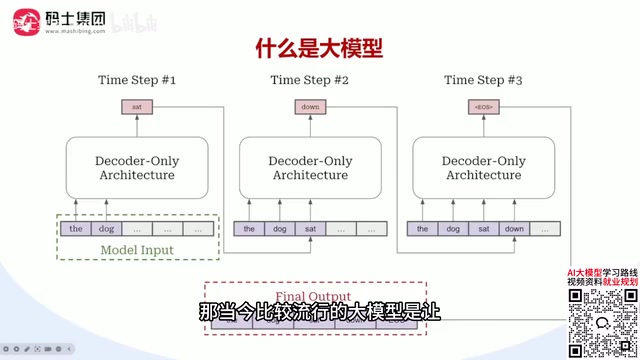
模型的运行方式是逐token生成:给定输入“the dog”,第一时刻输出“sat”,再把“sat”作为输入,得到下一时刻输出,如此循环,直到拼出完整句子。这个过程在数学上可以简化为一次矩阵运算:数据X乘以模型参数W,得到结果Y。
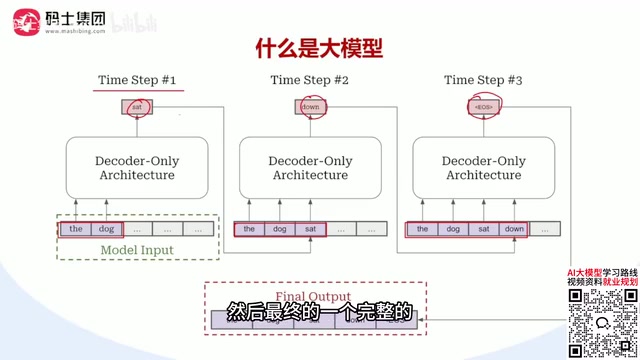
关键点在于,X和W都必须加载到GPU中才能完成计算。GPU是当前神经网络加速的主力硬件,但教程也提到NPU以及部分国产硬件同样可以承担计算任务。问题随之而来:当W的体量达到千亿参数级别时,单张GPU的显存放不下,分布式就成了唯一出路。
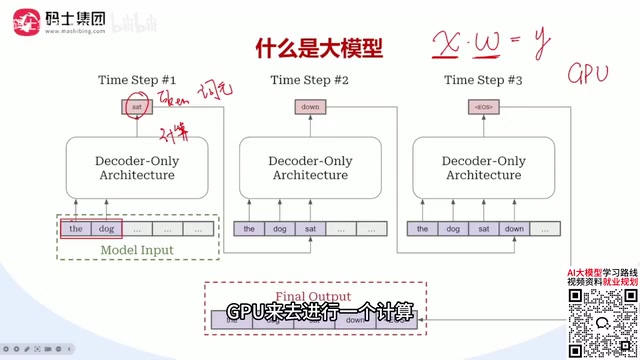
Decoder-only架构是Transformer的一种变体,去掉了原始Transformer中的encoder部分,仅保留decoder堆叠。每一层decoder包含自注意力(self-attention)和前馈网络(FFN),并通过残差连接和层归一化保持训练稳定。与encoder-decoder架构不同,decoder-only在生成时采用因果掩码(causal mask),确保每个token只能关注其左侧的上下文,从而实现自回归的逐token生成。GPT系列、LLaMA等主流大模型均采用此结构,其优势在于结构简洁、易于扩展,且在大规模预训练中展现出强大的涌现能力。理解decoder-only的层内计算(尤其是注意力与FFN的矩阵乘法)是后续分析张量并行切分点的基础。
KV Cache是自回归推理中的关键优化技术。在逐token生成时,模型需要缓存历史token的Key和Value矩阵,避免重复计算,从而将注意力计算复杂度从O(n²)降至O(n)。然而,KV Cache的显存占用随序列长度和批大小线性增长,对于长上下文场景(如32K tokens),单卡显存可能被KV Cache大量挤占。在分布式部署中,KV Cache的切分策略(如按头切分或按层切分)直接影响显存均衡和通信开销,是推理并行化必须考虑的工程细节。
六个关键问题串联起分布式并行全貌
视频标题点明了“6个关键问题”,虽然原始素材只展开了前两个问题的基础部分,但从教程脉络可以清晰看到分布式并行的核心议题框架。这六个问题通常对应着从单卡到多卡的完整扩展路径:
问题一:模型为什么必须分布式? 单卡显存装不下千亿参数,单卡算力也撑不起训练吞吐。这是最直接的动机。
问题二:数据和参数分别怎么切分? 这引出了数据并行与模型并行的基本分野——数据并行切分输入X,模型并行切分参数W。
问题三:张量并行如何拆解单层计算? 把矩阵乘法拆到多张卡上,层内并行,通信频繁但单卡负载降低。
问题四:流水线并行如何跨层切分? 按层把模型分成多个阶段,不同卡负责不同层,需要处理流水线气泡问题。
问题五:专家并行与混合并行怎么组合? 面向MoE架构和超大规模场景,多种并行策略叠加使用。
问题六:分布式训练中的通信与显存如何优化? 包括梯度同步、通信重叠、显存碎片管理等工程细节。
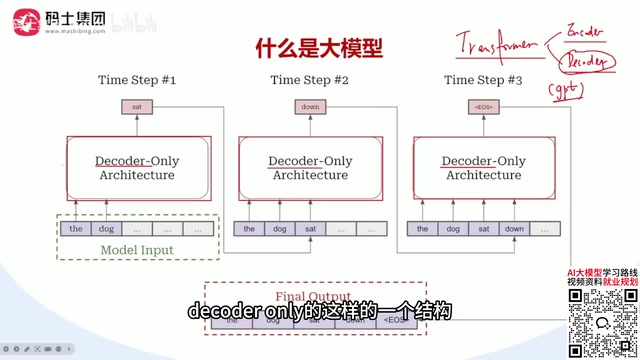
教程从decoder-only架构的逐token生成讲起,实际上是在为后续的并行切分做铺垫:理解了每一步计算发生在哪里,才能理解切分点该选在哪里。
张量并行(Tensor Parallelism)将单层内的矩阵乘法沿特定维度切分到多张GPU上。以Transformer的FFN层为例,第一个线性层的权重矩阵可按列切分,第二个线性层按行切分,从而在保持数学等价的同时降低单卡显存占用。但张量并行需要频繁的All-Reduce通信来同步中间结果,因此通常限制在节点内(NVLink互联)使用。流水线并行(Pipeline Parallelism)则按层将模型划分为多个阶段,不同GPU负责不同层的计算,通过微批次(micro-batch)调度隐藏流水线气泡。两者常结合使用:张量并行处理层内大矩阵,流水线并行处理层间划分,共同支撑千亿参数模型的分布式训练与推理。
私有化部署场景下的现实意义
教程开篇提到一个很实际的背景:无论是做智能体开发,还是做私有化部署,背后都会调用某个大模型完成交互。在线API是一种选择,但私有化部署在数据安全和成本控制上往往更受企业青睐。
一旦选择私有化,分布式部署就成为绕不开的工程问题。千亿参数模型对显存的需求远超单卡容量,而推理场景下的KV Cache又会进一步挤占显存。分布式并行不是学术概念,而是部署落地时必须回答的工程题。
从单卡瓶颈出发理解并行策略,比直接啃分布式训练的论文要直观得多——你知道每一步计算原本发生在哪里,就知道把它拆到多张卡上时,通信开销和负载均衡的代价在哪里。
数据并行(Data Parallelism)是最基础的分布式策略:每张GPU持有完整的模型副本,但处理不同的数据批次,通过梯度All-Reduce同步参数更新。其优势是实现简单、通信模式规整,但要求单卡能容纳完整模型。当模型规模超出单卡容量时,需引入模型并行(Model Parallelism),包括上述的张量并行和流水线并行。专家并行(Expert Parallelism)则面向MoE(混合专家)架构,将不同专家网络分布到不同GPU上,通过路由机制动态分配token。实际部署中,往往采用数据并行、张量并行、流水线并行和专家并行的混合策略(如3D并行),以在显存、算力和通信之间取得平衡。
学习路径建议
对刚接触这个领域的开发者,建议按“单卡推理→数据并行→张量并行→流水线并行→混合并行”的顺序推进。先跑通单卡上的模型生成流程,理解X和W的加载与计算,再逐步引入切分策略。教程中反复强调的decoder-only结构和逐token生成机制,是理解一切并行方案的基石。
这期B站教程的价值在于把分布式这个听起来庞大的话题,拆解成了从计算本质出发的渐进式路径,适合作为系统学习的入口。
相关推荐

Hermes Agent零基础教程:自进化AI智能体实战
Hermes Agent零基础教程:详解这个GitHub两月获41.7K星的开源自进化AI智能体,从Harness Engineering核心理念、学习循环、三层记忆系统到WSL安装与实战配置,小白也能轻松上手。
AI Agent落地实战:用WorkBuddy打造智能办公助理
本文通过实战案例演示如何用腾讯WorkBuddy完成文件批量转换与归档,对比聊天大模型与AI Agent的能力差异,分析WorkBuddy的积分体系、适用场景与产品定位,为办公自动化选型提供参考。
AI新物种FDE落地实战:三大职责与就业指南
从B站直播实战演示出发,解析AI新物种FDE(前沿部署工程师)的三大核心职责、团队角色分工与就业学习路径,帮助开发者理解这一介于算法与业务之间的新岗位。