从DQI到C-DQI:LLM自动生成编码手册评估议会话语质量

研究提出用LLM生成并评估议会辩论编码手册的完整协议,数据驱动方案一致性更优。
该研究针对议会辩论话语质量评估中人工编码手册僵化、成本高、主观偏差大的问题,提出从DQI到C-DQI的完整协议。研究对比了LLM生成编码手册的三种策略:理论驱动的自上而下、数据驱动的自下而上以及混合方法。在100份以色列议会记录上的实验表明,数据驱动的归纳式方案在模型间一致性(IMA)上优于理论驱动方案,同时未牺牲有效性。研究还设计了外部代理指标结合人工标注验证效度,并利用不同LLM的偏差差异构建IMA作为低成本可靠性信号。该框架将自动化推进到测量工具本身的生成环节,为大规模、跨语境政治话语分析提供了可扩展工具。
当议会辩论遇上大语言模型:话语质量评估的新范式
评估议会辩论的话语质量,传统上依赖专家依据理论编码手册进行人工打分。这种方法虽然严谨,却存在明显的瓶颈:编码手册僵化、标注成本高昂,且难以避免专家主观偏差。来自学术预印本平台的一篇研究提出了从DQI(话语质量指数)到C-DQI(计算话语质量指数)的完整协议,试图用大语言模型(LLM)同时解决“编码手册从哪来”和“标注是否可靠”两个难题。
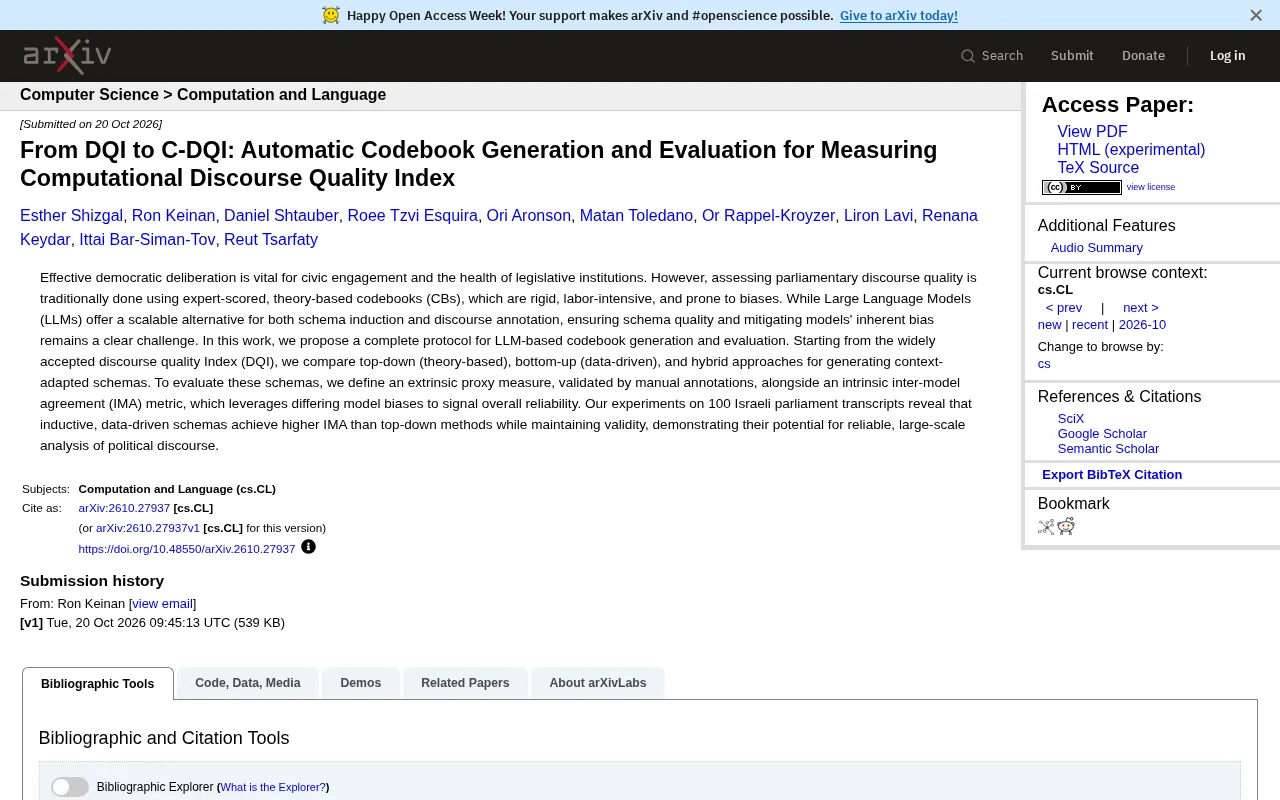
话语质量指数(DQI) 是政治传播与审议民主研究中广泛使用的一套理论框架,用于系统评估议会或公共辩论的质量。它通常将话语质量分解为多个维度,例如论证的合理性(是否基于证据与逻辑)、尊重性(是否避免人身攻击)、建设性(是否提出替代方案)以及立场清晰度等。研究者依据这些维度编写编码手册,由人工对辩论文本逐条打分。DQI的价值在于将“好辩论”这一模糊概念操作化为可测量的指标,但其维度设定源于特定理论传统,可能无法完全覆盖不同国家议会文化中的独特话语习惯,这也正是后续计算化改造的动因。
三种生成路径:自上而下、自下而上与混合
研究以广泛使用的DQI框架为起点,对比了三种LLM生成编码手册的策略:
- 自上而下(理论驱动):让模型直接依据DQI的理论维度生成评估条目;
- 自下而上(数据驱动):从100份以色列议会记录中归纳出语境适配的评估体系;
- 混合方法:结合理论框架与数据特征进行生成。
这种设计背后有一个关键洞察:理论驱动的编码手册可能遗漏特定议会语境下的重要维度,而纯数据驱动的方案又可能偏离公认的评估标准。研究结果表明,归纳式、数据驱动的编码方案在保持有效性的同时,获得了更高的模型间一致性(IMA),这提示我们:让模型从真实语料中“长出”评估标准,可能比直接套用理论模板更贴合实际需求。
模型间一致性(IMA) 借鉴了集成学习与多标注者一致性研究的思路。其核心假设是:不同大语言模型由于训练数据、架构和微调策略的差异,会带有不同的系统性偏差。如果多个模型依据同一份编码手册对同一批语料进行标注,而结果高度一致,则说明该手册的条目表述足够清晰、可操作,不易被单一模型的偏差所扭曲。IMA通常以模型两两之间标注结果的一致性比例或统计量(如Krippendorff's alpha)来度量。它提供了一种无需人工标注即可快速估计编码手册可靠性的代理信号,但高一致性并不自动等同于高效度——多个模型可能共享同一种偏差。
如何判断一份自动生成的编码手册好不好?
生成的编码手册是否可靠,不能只看模型自己怎么说。研究设计了两条评估路径:
外部代理指标:定义一个可量化的外在效标,并通过人工标注进行验证,确保自动评估与人类判断方向一致。
模型间一致性(IMA):利用不同LLM的偏差差异,让多个模型对同一批语料进行标注,通过它们之间的一致性程度来信号化整体可靠性。这个思路相当巧妙——如果多个具有不同“偏见”的模型都能得出相近结论,那么该编码手册的可靠性就更值得信任。
据论文报告,在100份以色列议会记录上的实验显示,数据驱动方案在IMA上优于理论驱动方案,同时未牺牲有效性。这意味着LLM生成编码手册的路线具备大规模政治话语分析的潜力。
外部代理指标 在测量学中是指与目标构念相关、但更易观测或更客观的替代变量。在本研究中,研究者需要验证自动生成的编码手册是否真的在测量“话语质量”,而非模型自行其是的某种模式。做法是选取一个与话语质量理论相关的外部变量(例如辩论的某种可观测结果或专家整体评分),检验基于自动编码手册得到的评分是否与该外部变量存在预期方向的相关性,并辅以人工标注进行交叉验证。这种方法不能完全替代严格的人工效度检验,但能在大规模自动评估中提供一道必要的效度防线,防止编码手册在模型间高度一致却偏离真实构念。
为什么这件事值得关注
议会话语质量评估的意义不止于学术。有效的民主审议是公民参与和立法机构健康运转的基础,而可扩展、低偏差的评估工具能让研究者、媒体和公众更系统地审视政治辩论的质量。
LLM在这里扮演的角色不是简单的“自动打分器”,而是编码手册的设计参与者和评估协议的组成部分。这种“用模型生成标准,再用模型间分歧检验标准”的双层思路,为计算社会科学中的测量问题提供了一个可复用的框架。当然,模型间一致性只是可靠性的代理信号,不能替代人工效度验证;数据驱动方案的有效性也仍需在更多语料和语境中检验。
对于关注AI在社会科学中应用的读者,这项工作的价值在于它把“自动化”推进到了测量工具本身的生成环节,而不仅仅是标注环节。当编码手册可以随语料自适应生成时,大规模、跨语境的政治话语比较研究才真正变得可行。
相关推荐
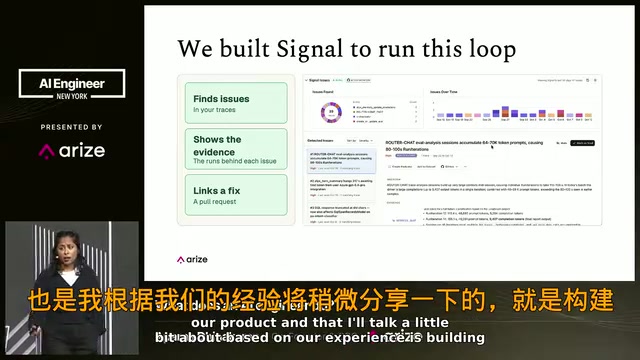
AI工程师的职责变了:从写代码到构建智能体工厂
Arize AI的Aparna Dhinakaran在AI Engineer大会分享AI工程师角色转变:从写功能到构建智能体循环,详解Signal始终在线智能体的触发、沙箱、记忆与评估器评估机制,以及追踪一切的数据飞轮。
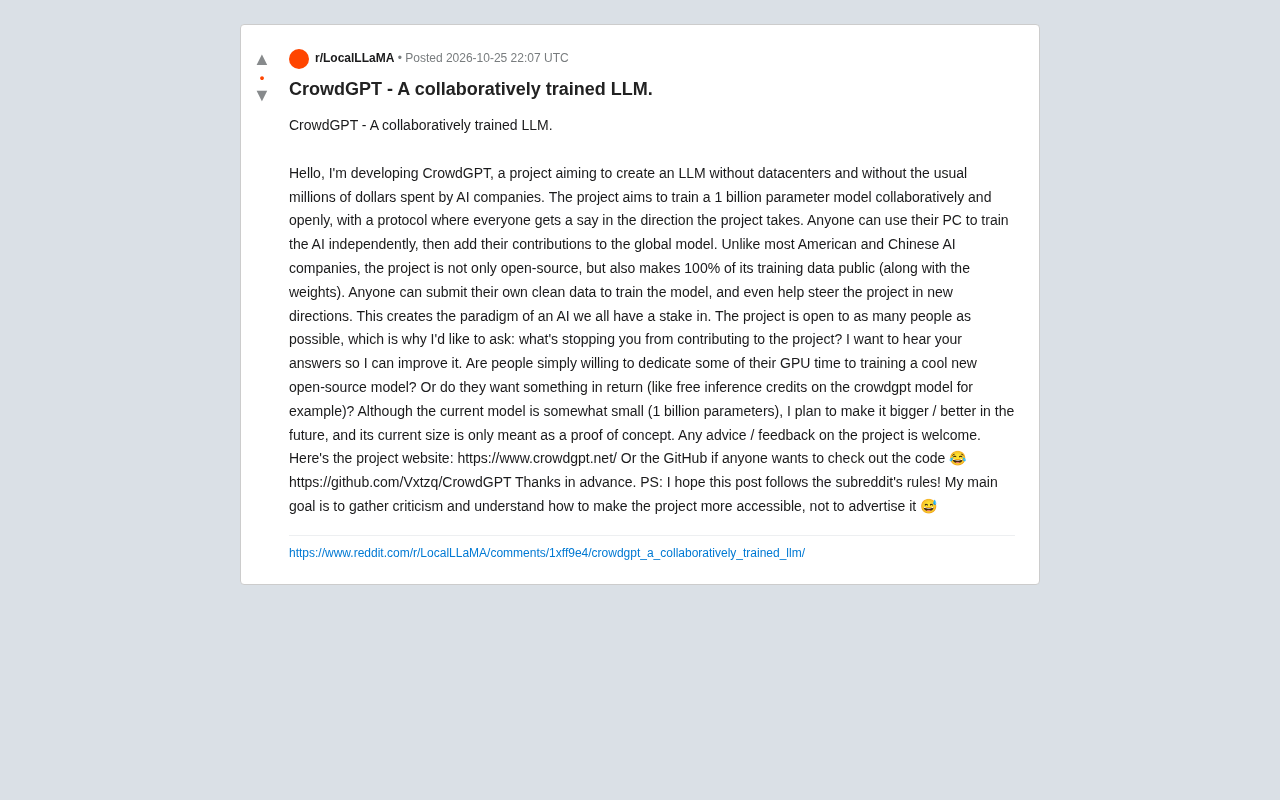
CrowdGPT:去中心化协作训练LLM的野心与挑战
CrowdGPT项目试图通过全球志愿者协作训练10亿参数开源LLM,公开全部训练数据和权重。本文分析其去中心化训练模式的技术挑战、社区激励机制及与主流开源模型的差异。
Apollo报告:AI在科技业外“零财务回报”
Apollo研究指出AI在科技行业之外尚未带来可量化的财务回报。本文分析资本开支与收益错配、组织变革滞后、财务计量盲区三大原因,并探讨对企业和AI从业者的启示。