从零实现带记忆的AI Agent:Python+Flask+DeepSeek全栈实战
用Python+Flask为AI Agent实现跨会话长期记忆,模型自主判断存储关键信息并按需召回。
本文介绍了一个入门级AI Agent项目:通过Python+Flask后端与原生前端,为大语言模型构建长期记忆机制。项目的核心设计是让模型自主判断哪些对话内容值得记忆,并将其持久化到文件系统;当用户新开会话再次触及相关话题时,系统自动读取记忆、拼接进上下文后一并发送给模型,从而实现跨会话的对话连贯性。技术栈刻意保持轻量,不引入复杂框架,使记忆机制的每个环节都清晰可见。文章同时指出了这套最小可用方案的扩展路径:以向量数据库替换文件存储可实现语义检索,以更精细的规则或模型打分可提升记忆质量,为构建更复杂的智能体记忆系统奠定基础。
为什么AI Agent需要记忆机制
大语言模型本身是无状态的——每次对话结束,模型并不会记住你说过什么。这也是为什么很多聊天机器人在新开一个会话后,就完全「忘记」了之前提到的项目背景、技术偏好或关键决定。要让AI真正像助手一样理解用户,就需要在应用层为它构建一套记忆机制(Memory)。
这个项目的核心思路,正是通过代码为智能体实现长期记忆。它的巧妙之处在于:模型会自主判断哪些内容值得记住。当对话中提到项目背景、技术要点、关键决策等信息时,模型会自行决定是否将其存储下来。等到用户新建会话或重新打开页面,再次提及相关话题时,系统会自动读取此前保存的记忆内容并展示出来。
这种「自主判断存储 + 按需读取」的设计,比简单地把所有历史对话全部塞进上下文要高效得多,也更接近人类记忆的运作方式——只记住重要的东西。
从技术实现角度,AI Agent 的记忆系统通常被分为四类:短期记忆(In-Context Memory)即当前对话窗口内的信息;长期记忆(External Memory)即持久化到外部存储的信息;情节记忆(Episodic Memory)即具体事件的记录;以及语义记忆(Semantic Memory)即抽象化的知识与偏好。本项目实现的是最实用的长期记忆——将关键信息写出模型上下文窗口之外,存入文件系统,从而突破大语言模型「上下文长度有限 + 会话结束即遗忘」的双重限制。这也是当前主流 Agent 框架(如 LangChain 的 Memory 模块、MemGPT)都着力解决的核心问题。
项目技术栈拆解
整个项目采用前后端分离的全栈架构,用到的技术栈相当基础,适合作为入门 AI Agent 开发的练手项目。
后端部分以 Python 为核心,搭配轻量级 Web 框架 Flask 处理请求与路由。模型能力上,项目同时支持调用 OpenAI 与 DeepSeek 的 API,开发者可以根据成本和需求灵活切换。记忆的持久化则通过文件读写来实现,无需引入复杂的数据库,降低了上手门槛。
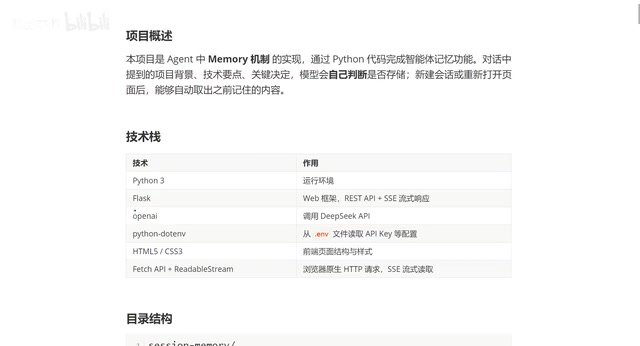
前端部分使用原生三件套 HTML + CSS + JavaScript,并通过原生 Fetch 请求与后端通信。没有引入 React、Vue 等重型框架,让整个数据流转的逻辑更加透明,便于理解请求发送、响应处理与页面渲染的完整链路。
对于想要理解 Agent 底层原理的学习者来说,这种「去框架化」的技术选型反而是优点——你能清楚看到记忆机制的每一个环节是如何拼接起来的。
实验效果:记忆如何工作
打开浏览器页面后,界面被清晰地划分为两部分。左侧是常规的历史会话记录,展示当前对话流;右侧则是这个项目的亮点所在——由大模型根据自身判断生成的长期记忆。
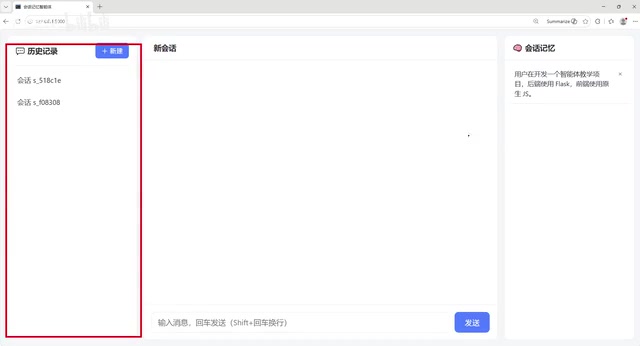
演示流程很直观:先向模型发送一句「你好」,等待它回复完毕。随后提问「有什么历史消息」,此时系统会触发一个读取记忆的功能。这一步实际上是在调用内部方法,把此前存储的记忆内容取出。
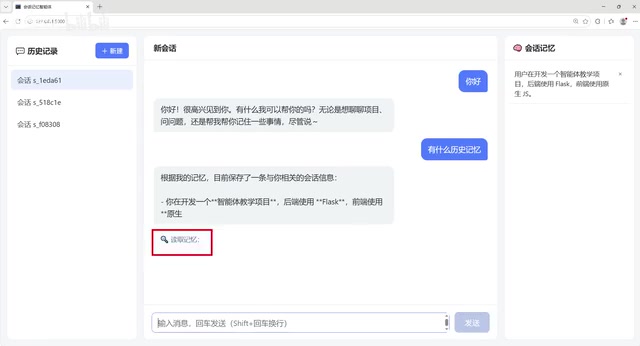
读取完成后,系统会将记忆内容与用户当前的这句提问一起打包发送给大模型。模型拿到完整的上下文后,就能给出结合历史信息的回复。这个「读取记忆 → 拼接上下文 → 请求模型」的闭环,正是整个记忆机制的核心逻辑。
关键在于,即便是重新打开页面、开启全新会话,只要涉及此前记录过的话题,系统依然能自动召回相关记忆,让对话保持连贯。
记忆机制的设计价值
从工程角度看,这个项目虽然实现简单,却演示了 AI Agent 记忆系统的几个关键设计点。
选择性存储是第一个要点。让模型自行判断哪些信息值得记忆,而非机械地保存全部对话,这既节省了存储与上下文成本,也提升了记忆的信噪比。按需召回是第二个要点——只有当用户提及相关话题时才读取记忆,避免每次都把冗长的历史信息塞进请求,从而控制 token 消耗。
跨会话持久化则解决了模型无状态的根本痛点。通过文件存储,记忆不会随会话结束而丢失,用户重新进入时依然能获得延续性的体验。
这套思路可以进一步拓展:文件存储换成向量数据库即可实现语义检索;简单的关键词判断换成更精细的规则或模型打分,则能提升记忆质量。掌握了这个最小可用版本,就为构建更复杂的智能体记忆系统打下了基础。
向量数据库(Vector Database)是记忆系统进阶的关键组件,值得单独说明。与文件存储按关键词匹配不同,向量数据库将文本转换为高维数值向量(Embedding),通过计算向量之间的余弦相似度来检索语义相近的内容。这意味着即使用户的提问措辞与存储记忆的原文不同,系统也能找到相关信息——例如用户问「上次说的框架」,系统能召回存储为「偏好使用 FastAPI」的记忆。常见的向量数据库包括 Chroma、Pinecone、Weaviate 等。在生产级 Agent 中,记忆的存取往往结合 Embedding 检索与关键词过滤双重机制,以兼顾语义覆盖率与精确性。
适合谁来学习
这个教程面向有一定 Python 基础、希望入门 AI Agent 开发的学习者。它不追求技术栈的花哨,而是用最直白的方式把记忆机制这一抽象概念落地为可运行的代码。跟着一步步实现,你不仅能得到一个会记忆的聊天智能体,更能真正理解 Agent 记忆背后的工作原理。
相关推荐
AI超级员工系统实测:智能获客与Agent搭建功能拆解
本文基于B站教程拆解AI超级员工系统的三大核心功能:AI智能获客、企业智能体Agent搭建与微信私域自动化管理,客观分析其能力边界与合规风险,帮助创业者理性判断是否值得尝试。
WorkBuddy入门实战:腾讯AI智能体如何重塑职场办公
WorkBuddy是腾讯推出的AI智能体桌面工具,能读取本地文件、执行多步骤任务、定时自动运行。本文详解WorkBuddy入门用法及其与传统AI工具的核心区别,帮助职场人快速掌握Agent办公提效技巧。
WorkBuddy入门指南:让AI从聊天机器人变成办公员工
WorkBuddy 是一款桌面 AI 智能体,能直接操作本地电脑完成办公任务。本文详解 WorkBuddy 是什么、与 Codex 的差异、三个常见认知误区及文件管理等实战应用,帮你从 AI 提问者进化为 AI 管理者。