从评分到检索:一本面向初学者的推荐系统实战书籍与免费代码
一本覆盖推荐系统全技术栈、代码可复现的免费开源实战书籍。
一位开发者历时数月编写了《Recommender Systems: From Ratings to Retrieval》,共13章,系统覆盖从经典评分预测到双塔检索、SASRec序列推荐、图神经网络直至LLM时代推荐系统的完整技术演进路径,面向有Python基础的初学者。书中所有数字均通过在MovieLens-100K数据集上实际运行代码得出,强调可复现性,作者还在编写过程中修复了真实bug并将踩坑经验沉淀进书中。完整代码仓库在GitHub免费开源,另提供含前两章的免费样章,是一份从理论到动手实践门槛极低的系统性学习资源。
一本贯穿推荐系统全景的实战书籍
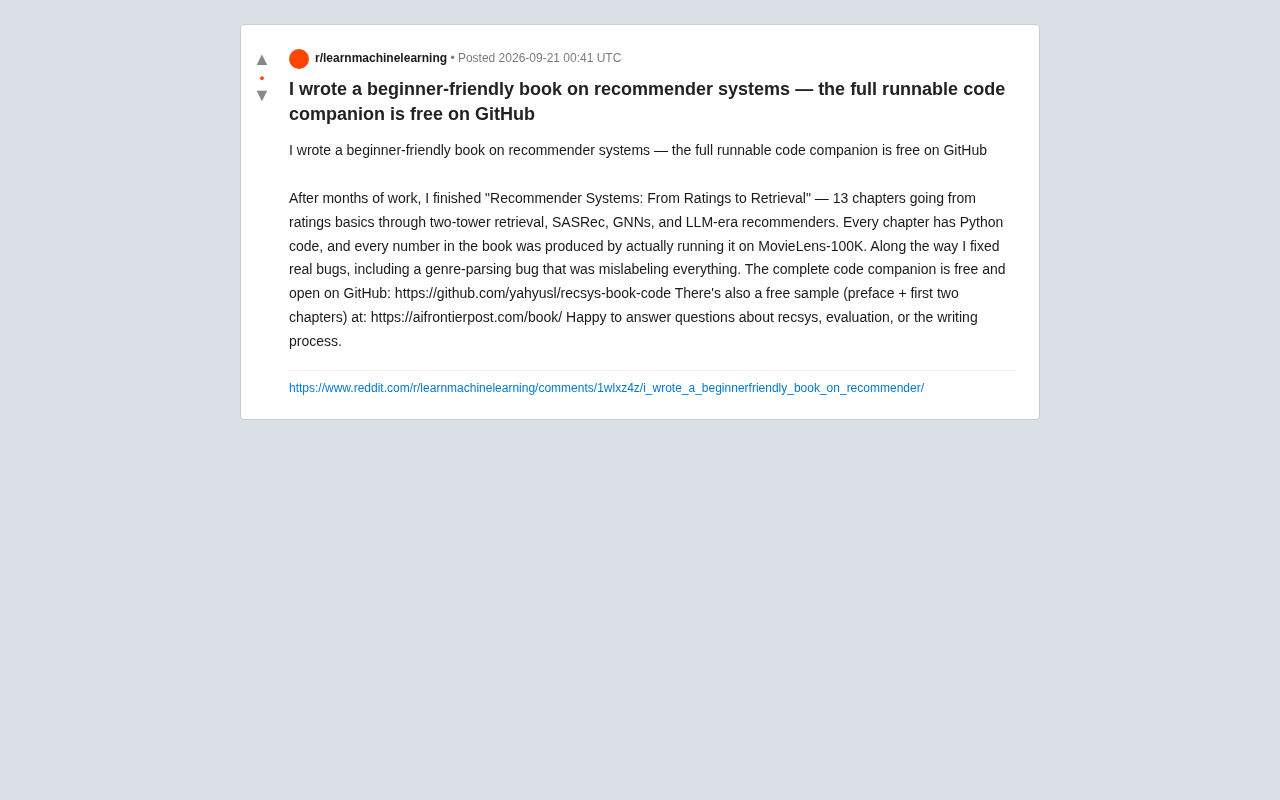
一位开发者在 Reddit 上分享了他历时数月完成的作品——《Recommender Systems: From Ratings to Retrieval》。这本书面向初学者,共 13 章,覆盖从最基础的评分预测,一路延伸到双塔检索(two-tower retrieval)、SASRec 序列推荐、图神经网络(GNN),直至 LLM 时代的推荐系统。
对于想系统性入门推荐系统的人来说,这样一条从传统方法到前沿架构的完整学习路径并不常见。多数教程要么停留在协同过滤等经典算法,要么直接跳进深度模型,缺少一条能把知识点串起来的主线。而这本书试图在同一叙事框架下把这些技术连接起来。
双塔检索(Two-Tower Retrieval)是工业级推荐系统中处理大规模候选集的主流召回架构。其核心思路是用两个独立的神经网络分别将用户和物品编码为低维稠密向量(embedding),然后通过向量内积或余弦相似度来衡量匹配程度。由于用户塔和物品塔解耦,物品向量可以离线预计算并建立近似最近邻索引(如 FAISS),从而在毫秒级完成亿级候选的快速检索。SASRec(Self-Attentive Sequential Recommendation)则是序列推荐领域的代表性模型,它用 Transformer 的自注意力机制对用户历史交互序列建模,捕捉不同时间步之间的依赖关系,相比早期的 RNN/GRU 方案在精度和训练效率上均有显著提升。图神经网络(GNN)在推荐中的应用则侧重于对用户-物品交互图进行消息传递,能够挖掘高阶协同信号,典型代表包括 LightGCN 等模型。理解这几类方法在技术演进中的位置,有助于把握全书的整体脉络。
每一个数字都来自真实运行的代码
这本书最值得关注的一点,是作者强调的"可复现性"。书中每一章都配有 Python 代码,而书里出现的每一个数字,都是通过在 MovieLens-100K 数据集上实际运行代码得出的,而非凭经验估算或直接照搬他处结果。
作者提到,在编写过程中他修复了若干真实存在的 bug,其中包括一个会导致所有电影类型(genre)被错误标注的解析错误。这类细节往往是纸面教程里被忽略的坑,却恰恰是初学者在自己动手时最容易卡住的地方。把踩坑与修复过程沉淀进书中,对读者而言是额外的价值。
MovieLens-100K 作为推荐系统领域的经典基准数据集,规模适中、易于上手,非常适合作为教学与实验的载体,也便于读者在自己的机器上快速跑通全部实验。
MovieLens-100K 是由明尼苏达大学 GroupLens 研究组发布的公开推荐系统基准数据集,包含 943 位用户对 1682 部电影的约 10 万条评分记录(1-5 星),以及用户的基本人口属性和电影的类型标签。由于规模适中(全量数据仅几 MB),在普通笔记本上即可秒级完成模型训练,是学术论文和教学场景中使用最广泛的基准之一。与此同时,GroupLens 还提供了更大规模的 MovieLens-1M、10M 和 25M 版本,供有更高计算资源的研究者使用。选择 100K 版本作为全书统一实验平台,意味着读者无需 GPU 即可复现书中全部结果,大幅降低了上手门槛。
完整代码免费开源,另有免费样章
作者将完整的代码配套仓库免费开源在 GitHub 上(recsys-book-code),读者可以直接克隆下来运行、对照书中内容学习。这种"书+可运行代码"的组合,降低了从理论到实践的门槛。
此外,作者还提供了免费试读样章,包含前言与前两章,托管在 aifrontierpost.com/book。想先评估内容深度与写作风格的读者,可以先看样章再决定。
谁适合读这本书
从内容结构看,这本书适合具备一定 Python 基础、希望系统学习推荐系统的开发者和学生。它的价值不在于某个单一算法的深挖,而在于把评分预测、检索召回、序列建模、图建模到 LLM 推荐这一条技术演进脉络铺陈清楚,并且全程可动手验证。
作者也在帖子中表示,欢迎就推荐系统、评估方法或写作过程进行交流。对于正在构建推荐系统或准备转向该方向的人来说,这样一份免费、可运行、覆盖前沿的资源值得收藏。
说明:本文基于作者在 Reddit 上的单一来源分享整理,书籍内容质量与代码完整度请读者结合免费样章与开源仓库自行评估。
相关推荐

Workbuddy零基础入门:桌面AI智能体如何落地工作流
Workbuddy桌面AI智能体零基础教程解读:从安装、积分领取到文件管理与自动化工作流搭建,对比CodeX的适用场景与成本差异,帮助职场人完成从AI提问者到AI管理者的思维转变。
OpenAI智能体新栈:计算机操作、决策API与超速工作流
OpenAI Dev Day发布智能体新栈:Computer Use操作速度超越普通人,Decisions API基于Luna实现极低延迟分类,Agents API开放同源计算机操作能力,GPT-6.1 Sol成本仅为Astra七分之一。本文梳理核心更新、实测数据与开发者落地要点。
梁文峰开源推理框架DeepInfo,硬刚美国禁令
DeepSeek在开源模型后再开源推理框架DeepInfo,包含GPU/CPU交叉流水线、小模型预判大模型复核、华为昇腾与英伟达芯片全面适配等技术,直面美国联邦禁令。本文解析其对AI产业落地的意义与开源策略。