从芯片到Token经济学:AI推理基础设施的全栈优化

AI行业焦点从训练转向推理,全栈Token成本优化成为商业竞争新核心。
本文围绕SemiAnalysis创始人Dylan Patel受邀出席Fireworks Forge活动这一信息,展开了对AI推理经济学的深度解析。文章指出,随着大模型进入大规模部署阶段,行业关注点已从一次性的训练成本转移至持续产生的推理运营成本。"从芯片到应用层"的全栈视角意味着,每生成一个Token的真实成本,是芯片架构、系统集群、推理引擎与服务调度四个层次共同决定的综合结果。对于构建AI产品的企业而言,单Token成本直接关乎商业模式能否盈利,理解完整的成本链条已从硬件工程师的专业领域,上升为产品与战略决策的必要认知。
一场关于AI推理成本的对话
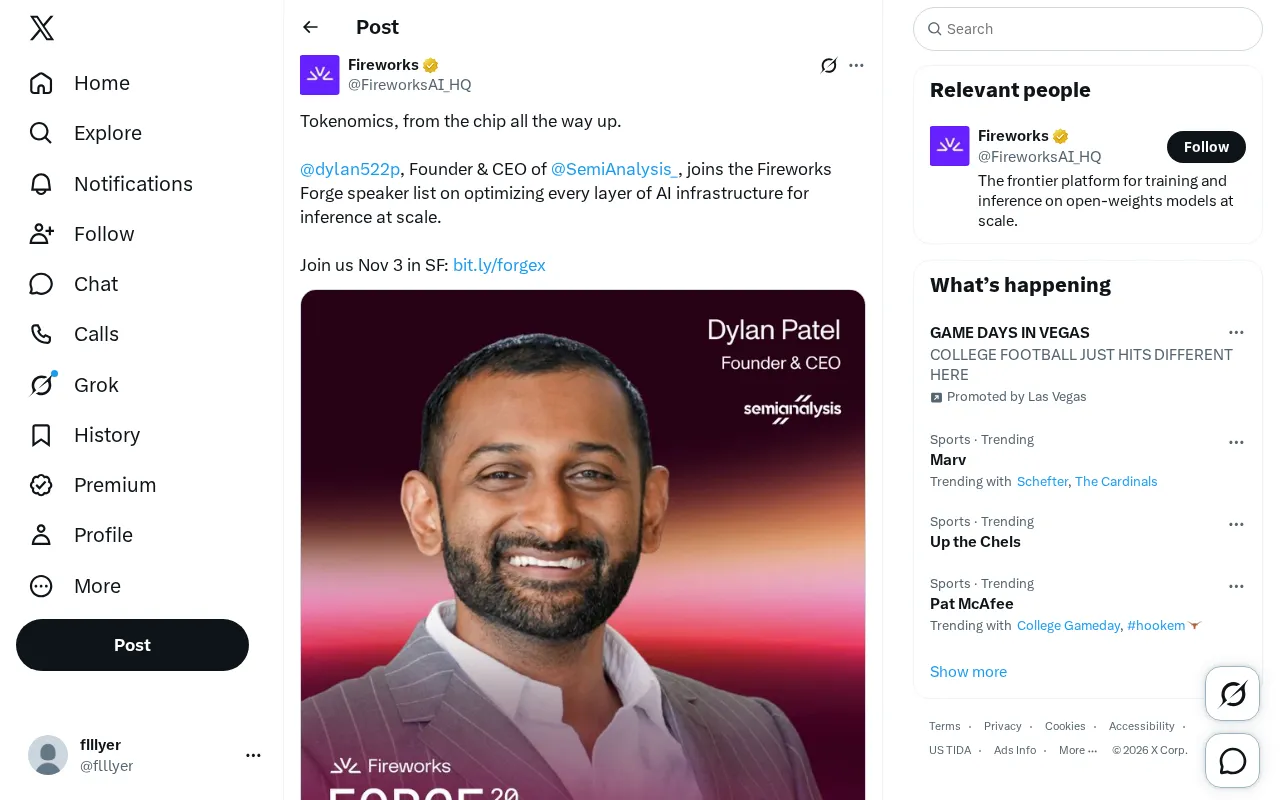
SemiAnalysis创始人兼CEO Dylan Patel(@dylan522p)即将加入Fireworks Forge活动的演讲者阵容,主题聚焦于一个日益关键的议题——如何从芯片层到应用层,优化AI基础设施的每一个环节,以支撑大规模推理。活动将于11月3日在旧金山举办。
这条简短的活动预告背后,指向了当前AI行业最核心的成本命题:Tokenomics(Token经济学)。随着大模型从训练阶段进入大规模部署与推理阶段,衡量AI服务的经济效率不再只看算力峰值,而是看每生成一个Token的真实成本。
什么是"从芯片到上层"的Token经济学
"Tokenomics, from the chip all the way up"这句口号精炼地概括了一种全栈视角。AI推理的成本并非由单一因素决定,而是从底层硬件一路堆叠到软件服务的综合结果:
- 芯片层:GPU/加速器的架构、内存带宽、互联能力直接决定了单位算力的功耗与吞吐。
- 系统层:服务器集群的网络拓扑、散热与供电效率影响整体利用率。
- 推理引擎层:批处理(batching)、KV缓存管理、量化等技术决定了硬件能被压榨到何种程度。
- 服务层:调度策略、负载均衡与多租户隔离决定了实际交付给用户的每Token成本。
Dylan Patel所创立的SemiAnalysis长期专注于半导体与AI硬件的深度产业分析,正是从芯片这一最底层出发,自下而上地拆解整个AI基础设施的成本结构。这种视角对于理解当下推理经济学的瓶颈尤为重要。
KV缓存是推理引擎层中尤为关键的技术机制,值得单独说明。大语言模型在生成每个新Token时,需要反复访问之前所有Token的注意力键值对(Key-Value pairs)。KV缓存将这些中间计算结果保存在GPU显存中,避免重复计算,从而大幅提升吞吐量。然而,KV缓存对显存的占用随上下文长度线性增长,在长对话或长文档场景下会迅速耗尽显存,成为推理成本的重要瓶颈之一。PagedAttention等技术正是为了更高效地管理KV缓存的显存分配而被提出,是当前推理引擎(如vLLM)优化的核心方向之一。
为什么推理优化成为行业焦点
行业的注意力正从训练转向推理。训练是一次性的巨额投入,而推理是持续、海量、与收入直接挂钩的运营支出。当模型被数以百万计的用户频繁调用时,每一分钱的单Token成本都会被放大为巨大的运营开销。
这也是Fireworks这类推理服务平台将活动命名为"Forge"(锻造)的隐含意义——真正的价值在于把原始的硬件算力,锻造成高效、低成本、可规模化交付的推理服务。优化每一层基础设施,意味着在相同硬件投入下服务更多请求,或在相同服务质量下降低资本与能源开支。
从成本结构来看,训练与推理的经济逻辑存在根本差异。训练是高度并行的批处理任务,可以充分利用GPU的计算密度(FLOP/s);而推理,尤其是在线实时推理,通常是小批量甚至单条请求的低延迟任务,瓶颈往往不是算力,而是内存带宽——每生成一个Token都需要将数百亿参数从显存中反复读取。这意味着衡量推理效率的核心指标不是峰值TFLOPS,而是内存带宽利用率(Memory Bandwidth Utilization)与有效批大小(effective batch size)。这也解释了为什么针对推理的硬件设计(如专注带宽的HBM优化)和软件调度策略,与训练场景有着截然不同的优化目标。
全栈优化的现实意义
对于构建AI产品的企业而言,推理成本直接决定了商业模式能否成立。一个无法控制单Token成本的服务,很难在竞争中实现可持续的盈利。因此,理解从芯片到应用的完整成本链条,已经从硬件工程师的专业话题,变成了产品决策者必须关注的战略问题。
邀请像Dylan Patel这样兼具半导体产业洞察与AI系统分析能力的专家,恰恰说明了行业对"全栈成本认知"的渴求。单纯堆砌GPU已不足以构建竞争优势,真正的护城河来自对每一层效率的精细打磨。
小结
这场于11月3日在旧金山举办的活动,虽然只是一则简短预告,却折射出AI行业从"算力竞赛"向"效率竞赛"的转变。当推理成为AI服务的核心成本中心,"从芯片一路向上"的Token经济学,正在成为衡量一家AI公司技术与商业成熟度的关键标尺。
注:本文基于一条活动预告整理,关于演讲的具体技术细节有待活动正式举办后进一步披露。
相关推荐
FlyEnv 插件实测:可视化运行 llama.cpp 与 GGUF 模型管理
FlyEnv 推出 llama.cpp 官方插件,提供多个 Metal 运行时并存管理、公共 GGUF 仓库索引与模型文件类型标注,以及上下文、线程、GPU 层数等推理参数可视化配置,支持模板与投机解码随模型保存,一键启动本地 LLM 推理服务。
前端如何进阶AI智能体开发?从OpenClaw拆解系统级Agent架构
从B站公开课演示的OpenClaw出发,拆解系统级AI智能体的三层架构与通用公式,分析前端开发者基于TypeScript切入Agent开发的路径、插件化设计与安全记忆层难点,附面试回答框架。
WorkBuddy实战:AI Agent如何自动批量转换与归档文件
通过B站UP主珊瑶老师的实测,对比豆包与WorkBuddy在文件批量转换任务中的表现,解析AI Agent如何从“给方案”到“直接执行”,附完整操作流程与积分消耗参考。