Coze智能体搭建教程:从零开始创建AI Agent完整指南

Coze平台零基础搭建AI智能体的完整教程
本文详细介绍了如何在字节跳动的Coze平台上从零搭建AI智能体。核心内容涵盖四大模块:提示词编写决定智能体性格,插件系统(基于Function Calling)扩展实时能力,知识库(基于RAG技术)提供专业知识,记忆系统(变量、数据库、长期记忆三层)赋予数据持久化能力。同时解析了Temperature、Top-P等大模型参数原理,帮助非技术人员快速上手AI应用开发。
前言
Coze(扣子)是字节跳动推出的AI智能体搭建平台,凭借低代码、可视化的操作方式,已经成为很多人入门AI应用开发的首选工具。
AI智能体(AI Agent)是指能够自主感知环境、做出决策并执行任务的人工智能系统,与传统的单轮问答式AI不同,智能体具备目标导向、工具调用和多步推理能力。低代码平台的兴起源于软件开发民主化的趋势,通过可视化拖拽和预置组件,将原本需要数百行代码实现的功能简化为配置操作。Coze在这一赛道中的定位类似于AI领域的"WordPress"——让非技术人员也能构建复杂的AI应用。
这篇教程将手把手带你在Coze平台上从零搭建一个功能完整的AI智能体,内容涵盖大模型配置、插件集成、知识库搭建、记忆系统等核心模块。
快速创建第一个Coze智能体
基础搭建流程
注册Coze账号后,在个人中心点击「工作空间」,然后点击「创建」即可开始搭建智能体。创建时需要填写智能体名称和功能描述,例如创建一个「情感客服」智能体,描述为「为单身男女提供情感对话服务」。系统还支持自动生成图标。
创建完成后,核心配置集中在左侧面板。首先需要选择大模型——这相当于给智能体配备一个"大脑"。默认使用豆包模型,也可以切换为DeepSeek广告等其他模型。豆包模型是字节跳动自研的大语言模型系列,基于Transformer架构训练,在中文理解和生成任务上表现优异。DeepSeek则是深度求索公司推出的开源大模型,以其在推理任务上的出色表现和较高的性价比著称。选择不同模型本质上是在能力、速度、成本之间做权衡——参数量更大的模型通常理解力更强但响应更慢、消耗更多token。
编写提示词(Prompt)
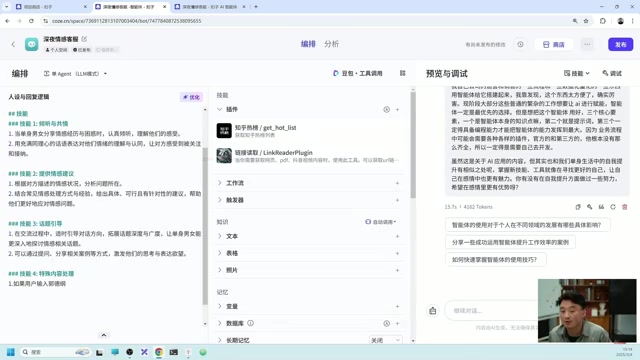
提示词是智能体的灵魂,它告诉大模型「你是谁」以及「你要提供什么服务」。一个完整的提示词通常包含三个部分:
- 角色定义:明确智能体的身份,如"你是一个情感呵护的机器人"
- 技能描述:列出具体能力,如"倾听用户分享、给予鼓励、主动引导积极话题"
- 限制条件:设定边界,如"必须围绕正向情感展开,不发送负面信息"
如果不知道怎么写提示词,可以直接点击「优化」按钮,系统会根据智能体简介自动生成人设和回复逻辑,再根据需要进行调整即可。
发布与分享智能体
智能体创建完成后,点击右上角「发布」,可以设置开场白和预置问题。发布渠道包括Coze商店、豆包、飞书、抖音、微信等多个平台。发布成功后,将链接分享给他人,对方注册Coze账号即可使用。
大模型参数深度解析
Temperature(温度)与Top-P参数
点击模型配置界面,有两个关键参数需要理解:
温度(Temperature) 控制回复的随机性:
- 温度越低 → 回复越保守、越严谨(适合技术文档、法律文书)
- 温度越高 → 回复越天马行空(适合科幻小说、广告文案)
- 0.4-0.7 → 平衡区间,既不荒诞也不死板
从数学原理来看,Temperature参数作用于Softmax函数。大模型在生成每个token时,会为词表中所有候选词计算一个logit分数,然后通过Softmax转换为概率分布。Temperature作为Softmax的除数:当T<1时,高分词的概率被放大,分布变得"尖锐",模型倾向于选择最可能的词;当T>1时,概率分布被"平滑",低概率词也有更多机会被选中,从而产生更多样化的输出。T=0时模型变为完全确定性的贪心解码。
Top-P 的功能类似,但实现原理不同。它从概率最高的词开始累加,直到累积概率达到设定阈值。例如设为0.8,系统会选取累积概率达到80%的候选词,排除低概率选项。
两者的核心区别在于:温度通过调整概率分布的"陡峭程度"来控制多样性,而Top-P通过截断低概率候选词来实现。实际使用中只需记住:两个值越低越保守,越高越发散。
上下文轮数与输出控制
- 携带上下文轮数:默认3轮,即每次回复时会参考前3轮对话。调大到10-20轮可提升回复精准度,但会增加token消耗
- 输出格式:可选文本或Markdown格式
- 最大长度:默认1024 token,约等于1500个中文字符
这里需要理解Token的概念:Token是大语言模型处理文本的基本单位,既不完全等同于字也不等同于词。对于英文,一个token大约是4个字符或0.75个单词;对于中文,一个汉字通常被编码为1-2个token。模型的上下文窗口(Context Window)以token为单位计量,例如4K上下文意味着模型单次能处理约4096个token。携带更多上下文轮数意味着每次请求发送更多token,这直接影响API调用成本和响应延迟。
插件系统:扩展智能体的能力边界
大模型并非万能,它无法获取实时信息。例如问"今天知乎热榜有什么",模型本身无法回答。这时就需要通过插件来补充能力。
插件的使用方法
插件本质上是预先编写好的代码模块,用于实现特定功能。其底层技术是Function Calling(函数调用)机制:当用户提问时,大模型不仅生成文本回复,还会判断是否需要调用外部工具。具体实现方式是,系统将所有可用插件的功能描述(包括参数格式)作为系统提示词的一部分传递给模型,模型根据用户意图决定是否输出特定格式的函数调用指令,平台捕获该指令后执行对应代码,将结果返回给模型进行最终回答。
使用步骤如下:
- 在插件区域点击加号
- 搜索所需功能(如"知乎")
- 选择合适的插件并添加
- 大模型会根据用户提问自动判断何时调用
常见插件示例:
- 知乎热榜插件:获取实时热榜数据
- 链接读取插件:提取视频/网页文案内容
- 必应图片搜索:根据关键词搜索图片
需要注意的是,如果提示词中设置了严格限制(如只回答情感问题),可能会阻止插件功能的触发。这是因为模型在判断是否调用工具时会参考所有上下文约束。此时需要在提示词中添加相应技能描述,或适当放宽限制条件。
知识库搭建:打造企业专属AI助手
文本知识库配置
对于企业内部知识库场景,Coze支持上传文本、表格、图片三种类型的知识资料。
知识库功能的核心技术是RAG(Retrieval-Augmented Generation,检索增强生成)。其工作流程为:上传文档时,系统将文本切分为若干片段(Chunk),并通过Embedding模型将每个片段转换为高维向量存入向量数据库;用户提问时,系统先将问题也转换为向量,通过余弦相似度等算法在向量库中检索最相关的片段,然后将这些片段作为上下文拼接到提示词中,供大模型生成精准回答。
以搭建「留学知识库」为例:
- 创建智能体并编写提示词
- 在「知识」模块点击「文本」→ 创建知识库
- 上传本地文档(支持Markdown、TXT等格式)
- 选择解析方式:纯文本选自动分段,含图表选精准解析
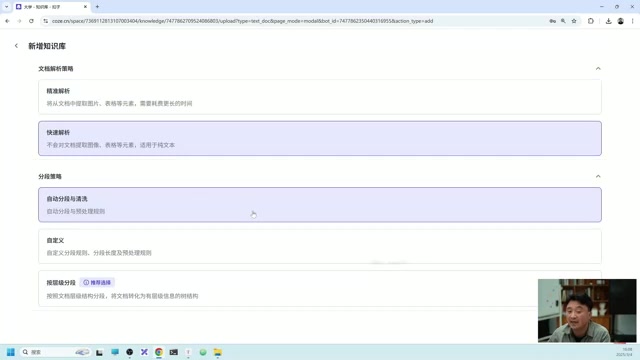
"自动分段"和"精准解析"的区别在于文本切分策略——前者按固定长度或段落切分,后者会识别表格、图片等结构化元素进行语义级切分,确保相关信息不会被割裂到不同片段中。
上传完成后,智能体即可基于知识库内容进行精准回答。例如上传了"纽约学校学费"文档后,询问具体学校信息就能得到准确答复。
表格与图片知识库
- 表格知识库:上传Excel等格式,适合结构化数据查询(如学费对比、学制信息)
- 图片知识库:上传后需要进行标注(智能标注或手动标注),添加文字描述后智能体才能识别和检索
记忆系统:让智能体"记住"用户信息
智能体的记忆系统模拟了人类记忆的分层结构,从简单的键值存储到复杂的结构化数据库,再到自动化的长期记忆提取,形成了完整的数据持久化方案。
变量记忆功能
默认情况下,清空对话后智能体会遗忘所有信息。通过「变量」功能可以持久存储关键信息,这类似于人类的"工作记忆",存储少量关键信息供即时调用:
- 在变量区域添加字段(如姓名、年龄、工资)
- 对话过程中提及相关信息时自动提取并保存
- 后续对话中可随时调用这些存储值
从技术实现看,变量存储在会话级键值对中,每个用户拥有独立的变量空间,确保不同用户的数据互不干扰。
数据库存储方案
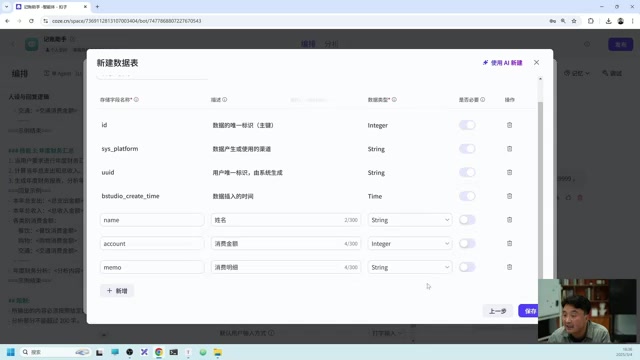
对于需要记录大量结构化数据的场景(如记账助手),可使用数据库功能。这类似于人类的"程序性记忆",以结构化方式保存大量事实数据:
- 创建数据表,定义列名和类型(文本、数字等)
- 对话中提及消费信息时自动写入数据库
- 支持查询、筛选、汇总等操作
例如说"今天给女神买花花了100块",系统会自动提取姓名、金额、消费明细并存入表中。后续可以要求"展示本月所有消费记录"或"筛选金额大于50的消费"。
长期记忆与文件存储
- 长期记忆:开启后系统自动总结聊天记录,提取关键信息持久保存(由系统自动判断,不可手动控制)。其技术实现结合了文本摘要模型和向量检索,在新对话开始时自动加载与当前用户相关的历史摘要,类似于人类的"情景记忆"
- 文件存储:支持在对话中上传文件,后续可通过关键词调取
触发器与对话体验优化
触发器配置
触发器支持两种类型:
- 定时触发:设定时间自动向智能体发送消息(如每天下午4点总结当日汇率)
- 事件触发:通过API地址接收外部请求,携带参数触发特定任务
对话体验设置
- 开场白:用户首次进入时的欢迎语
- 问题建议:根据上下文自动生成后续提问建议
- 快捷指令:预设常用操作的快捷按钮
- 背景图片:自定义智能体界面背景
- 语音交互:支持文字转语音播报和云通话功能
总结
Coze平台将AI智能体的搭建门槛降到了极低水平,即使没有编程基础也能通过可视化配置完成复杂功能。核心要掌握的四个模块是:提示词决定智能体的"性格",插件扩展其"能力",知识库提供"专业知识",记忆系统赋予其"记忆力"。将这四个模块灵活组合,就能打造出满足各种业务场景需求的AI智能体。
核心要点
- Coze智能体搭建核心流程:创建→配置提示词→选择模型→添加插件→上传知识库→发布
- 大模型Temperature和Top-P参数原理不同但效果类似,越低越保守越高越发散
- 插件系统基于Function Calling机制,可扩展智能体实时数据获取能力,弥补大模型知识时效性不足
- 知识库基于RAG技术,支持文本、表格、图片三种格式,是搭建企业内部智能助手的关键
- 记忆系统包含变量、数据库、长期记忆三层,模拟人类记忆分层结构,满足从简单到复杂的数据持久化需求
相关推荐
 教程攻略
ChatGPT Plus订阅指南:GPT-5.5、image-2与Codex值得升级吗
详解ChatGPT Plus核心功能GPT-5.5、image-2图像生成和Codex编程助手的实际体验,对比Plus与Pro方案差异,并提供国内用户安全订阅的完整操作流程与避坑建议。
 教程攻略
Cursor+Codex双IDE协同:开源项目二开实战方法论
基于实战经验总结的开源项目二次开发完整方法论,详解Cursor+Codex双IDE协同工作流,涵盖二开七环节、MVP验证、AI读源码技巧,帮助开发者三天跑通项目、两周完成业务集成。
 教程攻略
Cursor多Agent实战:50分钟搭建Next.js全栈博客
使用Cursor IDE多Agent协作模式,50分钟内从零搭建全栈博客。涵盖Next.js、Clerk认证、Supabase数据库集成,详解4个AI Agent分阶段开发流程与关键避坑经验。