CriticGen:将AI评估转化为可执行改进反馈的新框架
大模型评估困境:评分容易,改进难
评估大语言模型(LLM)输出质量的方法虽多,但普遍存在致命缺陷:粗粒度且与生成过程脱节。当前主流的LLM评估方法大致分为三类:基于基准测试(benchmark)的自动评估(如MMLU、HumanEval)、基于模型的评估(如LLM-as-a-Judge,即用GPT-4等强模型充当裁判对其他模型输出打分)、以及人工评估。
其中,MMLU(Massive Multitask Language Understanding)包含57个学科的选择题,测试模型的知识广度;HumanEval则通过代码生成任务测试编程能力。这些基准测试虽然标准化程度高,但存在"教学到考试"(teaching to the test)的风险——模型可能因训练数据污染而在基准上表现优异,却在实际应用中表现平庸。LLM-as-a-Judge方法由LMSYS团队在2023年系统化提出,其核心发现是GPT-4作为裁判时与人类评价的一致性可超过80%,但也存在位置偏差(倾向于选择排在前面的答案)、冗长偏差(倾向于更长的回答)和自我偏好(倾向于自己生成的内容)等系统性问题。
LLM-as-a-Judge因成本低、可扩展性强而被广泛使用,但其核心问题在于评估粒度粗糙——当评估模型给某个回答打分时,往往只能给出笼统的分数和模糊的解释,比如"回答不够全面"或"逻辑混乱"。
这类反馈对改进模型输出几乎没有实际价值。它既未指出具体问题,也未给出修改路径。评估与生成成了两条平行线——评估只是事后裁判,而非改进引擎。这种"评估-改进"之间的鸿沟,导致开发者知道模型表现不佳,却不知道该从哪里入手优化。
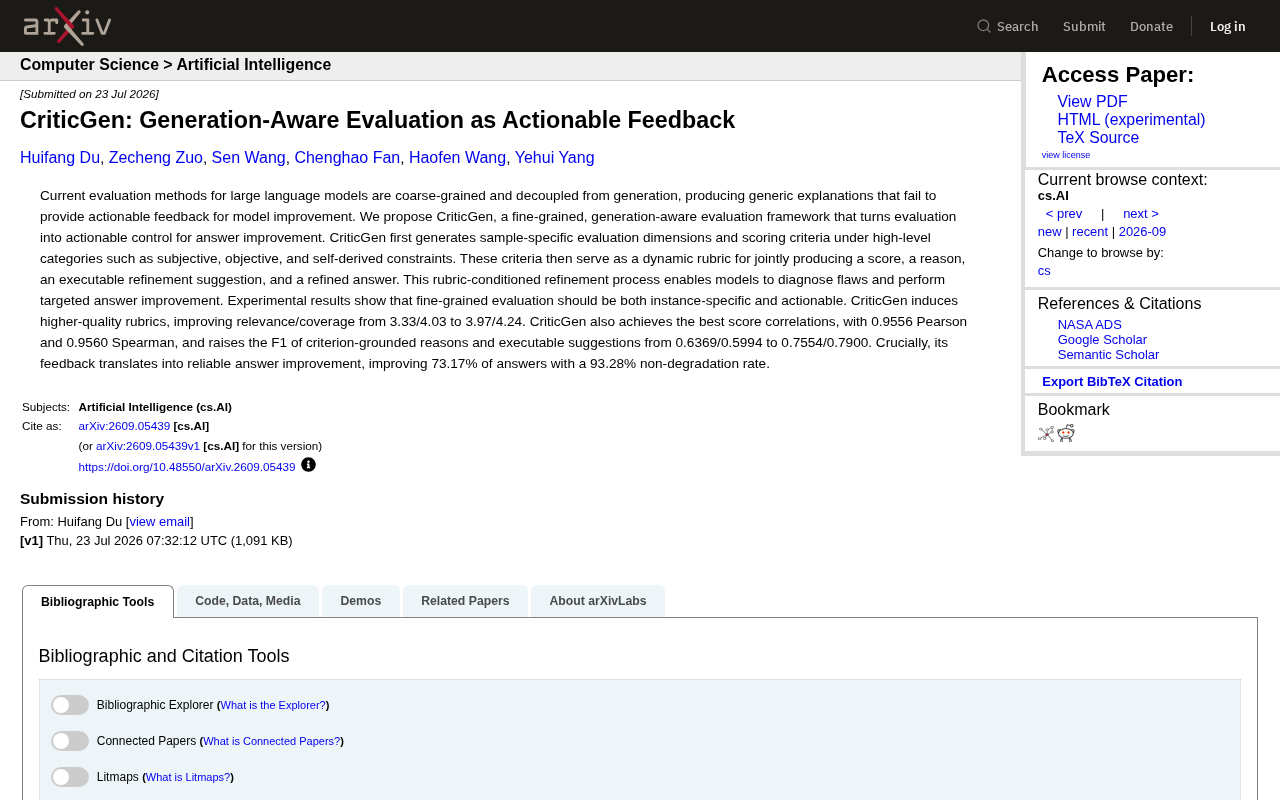
arXiv 新发布的论文《CriticGen: Generation-Aware Evaluation as Actionable Feedback》正是针对这一痛点,提出了将"评估"转化为"可执行控制"的全新框架。
CriticGen 核心机制:动态标准驱动定向改进
样本级评分维度取代固定标准
CriticGen 是一个细粒度、生成感知(generation-aware)的评估框架。所谓"生成感知",意味着评估过程深度理解生成机制,能够追踪答案中每个部分是如何产生的、哪些环节可能引入了错误。这一理念与近年来"过程奖励模型"(Process Reward Model, PRM)的思路相呼应——PRM不仅评判最终答案的对错,还对推理链中的每一步进行评分,提供更细粒度的反馈信号。
过程奖励模型的概念源自OpenAI在2023年发布的研究《Let's Verify Step by Step》。与结果奖励模型(Outcome Reward Model, ORM)只在最终答案处给出奖励信号不同,PRM对推理过程中的每一个中间步骤都进行评分。实验表明,在数学推理任务中,PRM训练的模型在MATH基准上的准确率显著优于ORM。这一发现揭示了一个深层原则:反馈信号越细粒度、越贴近错误发生的位置,对模型改进就越有价值。DeepMind的AlphaProof和AlphaGeometry等系统也采用了类似的逐步验证思路。CriticGen在此基础上更进一步,不仅标注哪一步出错,还给出如何修正的具体方案。
CriticGen将这种思路进一步推进,不仅关注过程评估,还将评估结果直接转化为可操作的修改指令。
它的首要步骤不是直接打分,而是为每个样本生成专属的评估维度和评分标准。在传统的LLM评估中,评分标准通常是预定义的固定模板,例如统一使用"有用性、相关性、准确性、深度、创造性"等维度对所有回答打分。这种方式的问题在于:一道数学题和一篇创意写作的评估重点截然不同,固定标准无法适应多样化的任务需求。CriticGen的动态评分表借鉴了教育评估领域中"分析式评分表"(analytic rubric)的理念——针对每道具体题目,分析其隐含的质量维度和期望标准,再据此构建定制化的评分框架。
分析式评分表是教育测量学中的经典工具,与整体式评分表(holistic rubric)相对。整体式评分表对作品给出一个综合等级(如A/B/C),而分析式评分表将质量分解为多个独立维度分别评分。例如,写作评估可能分解为"论点清晰度""论据充分性""语言表达""结构组织"等维度,每个维度有独立的等级描述。这种方法的优势在于诊断性——学生不仅知道总分,还知道具体哪个方面需要改进。Bloom的教育目标分类学(记忆、理解、应用、分析、评价、创造)也常被用于设计评分维度。CriticGen将这一教育评估理念引入LLM评估,让AI评估具备了类似优秀教师的诊断能力。
这些标准组织在几个高层类别之下:
- 主观约束(subjective constraints):表达、风格等主观要求
- 客观约束(objective constraints):事实、逻辑等可验证要求
- 自推导约束(self-derived constraints):模型根据问题推导的隐含要求
其中,自推导约束是一个特别值得关注的设计。许多问题的质量要求并非全部显式地写在指令中,而是需要根据上下文推理得出。例如,当用户问"如何为5岁孩子解释量子力学"时,指令中并未明确要求"避免专业术语"或"使用类比",但这些都是高质量回答的隐含要求。
自推导约束的设计理念与认知科学中的"元认知"(metacognition)概念密切相关。元认知是指"对认知的认知"——即个体对自身思维过程的监控和调节能力。在心理学研究中,元认知能力强的学习者能够更好地识别自己的知识盲区,制定更有效的学习策略。在NLP领域,这种能力的计算化实现有多种形式:思维链(Chain-of-Thought, CoT)通过显式的中间推理步骤提升推理质量;Self-Ask方法让模型先提出子问题再逐一回答;而Tree-of-Thought则让模型探索多条推理路径。CriticGen的自推导约束可以被理解为一种"评估层面的元认知"——模型不仅需要理解问题,还需要推理出评估这个问题的答案时应该关注哪些方面。
自推导约束让评估模型具备了这种"元认知"能力——它不仅理解问题表面要求,还能推断出未被明说但至关重要的质量标准。这与"思维链"(Chain-of-Thought)提示技术有异曲同工之处,都是通过让模型显式地进行中间推理来提升最终输出质量。
关键在于,评估标准不再是通用模板,而是针对具体问题定制的动态评分表(dynamic rubric)。
"诊断—修复"完整闭环
有了动态评分表,CriticGen 会以它为条件,联合产出四项内容:
- 分数(score)
- 理由(reason)
- 可执行的改进建议(executable refinement suggestion)
- 改进后的答案(refined answer)
这正是 CriticGen 最具价值的设计——它把评估从"打分"升级为**"诊断缺陷—定向修复"的完整闭环**。模型不仅知道问题所在,还能获得具体修改方案,并直接生成优化答案。这种以评分表为条件的改进过程(rubric-conditioned refinement),让评估真正成为驱动质量提升的工具。
实验验证:实例化且可执行的评估更有效
论文通过实验验证了核心观点:细粒度评估必须同时具备实例特异性(instance-specific)和可执行性(actionable)。
评分表质量显著提升
CriticGen 生成的评分表质量显著优于基线。相关性(relevance)和覆盖度(coverage)分别从 3.33/4.03 提升到 3.97/4.24,说明生成的评估维度既更贴合问题,又覆盖更全面。
评分与人类判断高度一致
在与人类判断的一致性方面,CriticGen 取得了 0.9556 的 Pearson 相关系数和 0.9560 的 Spearman 相关系数——这意味着它的打分与人类评价高度吻合,接近可信裁判水平。
值得一提的是,Pearson相关系数衡量两个变量之间的线性相关程度,而Spearman相关系数衡量的是单调相关程度(即排序一致性)。在LLM评估场景中,Pearson高意味着模型打分值与人类打分值在数值尺度上高度一致,Spearman高则意味着模型对不同答案的排序与人类排序高度吻合。在LLM评估领域,与人类判断的一致性是衡量自动评估方法有效性的黄金标准。除了Pearson和Spearman外,研究者还常用Kendall's Tau(衡量排序一致性的另一种指标)和Cohen's Kappa(衡量评分者间一致性)等指标。值得注意的是,高相关系数不等于完美替代——即使相关系数达到0.95,在边界情况(borderline cases)和主观性强的任务上,模型评分与人类评分仍可能出现显著分歧。此外,"人类评价"本身也并非无噪声的金标准:研究表明,不同人类标注者之间的一致性(inter-annotator agreement)在开放式文本质量评估中通常只有0.6-0.8,这意味着CriticGen的0.95实际上可能超过了人类评价者之间的一致性水平。
作为参考,GPT-4作为裁判时与人类的相关系数通常在0.7-0.85之间,CriticGen的0.95以上水平意味着其评分几乎可以作为人类评价的可靠替代。
理由与建议具有可操作性
更重要的是,CriticGen 在"基于标准的理由"(criterion-grounded reasons)和"可执行建议"(executable suggestions)上的 F1 分数分别从 0.6369/0.5994 提升到 0.7554/0.7900。这表明它给出的解释扎根于具体评分标准,而非空洞套话,建议也更具可操作性。
反馈可靠转化为质量提升
最关键的是,这些反馈能够可靠地转化为答案质量提升。实验显示,CriticGen 改善了 73.17% 的答案,且保持了 93.28% 的非退化率(non-degradation rate)——绝大多数情况下修改不会让答案变糟。
这组数据尤为重要,因为自我改进(self-refinement)领域面临着严峻的"退化问题"。Huang等人(2023)在《Large Language Models Cannot Self-Correct Reasoning Yet》中系统论证了:在没有外部oracle反馈的情况下,LLM的自我纠正在推理任务上往往会降低性能。这一发现挑战了此前Self-Refine(Madaan等,2023)等工作的乐观结论。退化的根源在于:如果模型本身缺乏识别错误的能力,那么自我反馈只会放大其偏见。解决方案大致有三个方向:引入外部验证器(如代码执行器、搜索引擎)、使用更强的模型作为评估器、或者像CriticGen这样通过结构化评估框架来约束反馈质量。CriticGen的动态评分表本质上是一种"结构化先验",通过将评估分解为具体维度来降低评估器产生错误反馈的概率。
非退化率衡量的正是修改后答案不比原答案更差的概率。CriticGen的93.28%非退化率意味着每100次修改中,只有约7次会导致答案质量下降,这在自我改进方法中是相当稳健的表现,但在医疗诊断、法律咨询等高风险领域,这7%的退化风险仍可能带来严重后果。
这项工作的价值与意义
评估范式转变
CriticGen 代表了 LLM 评估领域的方向转变:从被动裁判走向主动教练。传统评估器只负责说"对"或"错",而 CriticGen 试图回答"如何变得更好"。
这种把评估与改进耦合的思路,与近年兴起的自我修正(self-refinement)、宪法式 AI 等技术方向一脉相承。宪法式AI(Constitutional AI, CAI)由Anthropic于2022年提出,核心思想是用一组明确的原则("宪法")来指导模型的自我批评和自我修正,从而减少对人类标注的依赖。CAI的流程是:模型先生成回答,再根据预设原则对回答进行批评,最后根据批评修改回答,修改后的数据用于强化学习训练。CriticGen与CAI在理念上相似——都试图将评估反馈直接融入改进流程——但CriticGen更进一步:它不依赖固定的宪法原则,而是为每个具体问题动态生成评估标准,评估粒度更细、针对性更强。
在自我修正的更广泛技术谱系中,CRITIC(Gou等,2023)让模型借助外部工具(计算器、搜索引擎)来验证和修正自己的输出;Self-Refine(Madaan等,2023)采用迭代式的"生成-反馈-修正"循环;Reflexion(Shinn等,2023)则引入了语言化的"经验记忆",让模型从过去的失败中学习。这些方法的共同挑战是反馈质量——反馈越具体、越准确,修正效果越好。CriticGen通过动态评分表和结构化反馈机制,在反馈质量这一关键维度上实现了显著提升,可以被视为这一技术脉络的最新进展。
对模型训练与推理的影响
这种可执行反馈的价值不仅停留在推理阶段。高质量、可落地的批评信号,本身就是训练数据的绝佳来源——它可用于强化学习中的奖励建模,或作为拒绝采样、迭代优化的筛选依据。
当前LLM训练中广泛使用的RLHF(基于人类反馈的强化学习)依赖奖励模型对模型输出进行打分,但奖励模型通常只提供标量信号(一个分数),缺乏解释性。RLHF由OpenAI在InstructGPT(2022)中大规模应用,其标准流程包括三个阶段:监督微调(SFT)、奖励模型训练、以及使用PPO算法进行强化学习优化。但RLHF存在训练不稳定、奖励黑客(reward hacking)等问题——模型学会了取悦奖励模型的捷径,而非真正提升回答质量。
DPO(Direct Preference Optimization,Rafailov等,2023)通过数学推导绕过了显式的奖励模型训练,直接从偏好数据优化策略,大幅简化了训练流程。KTO(Kahneman-Tversky Optimization)则进一步放宽了对成对偏好数据的要求,只需单个样本的好/坏标签即可训练。在这些方法中,训练数据的质量至关重要。
CriticGen产生的结构化反馈(包含具体维度评分、理由和修改建议)可以作为更丰富的奖励信号。它的"原始答案-改进答案"配对天然构成了高质量的偏好对(preference pairs):原始答案作为被拒绝样本,修改后答案作为被选择样本,从而大规模地生产训练数据而无需昂贵的人工标注。一个既能精准诊断、又能给出修复方案的评估器,有望成为模型自我进化循环中的重要一环。
局限性思考
论文数据仍处于研究阶段,需要注意几点:其一,动态生成评分表会带来额外计算开销;其二,评估器能力天花板受限于自身模型水平——当被评估答案质量超过评估器时,反馈有效性可能下降;其三,93.28% 的非退化率虽高,但剩余近 7% 的退化风险在高风险场景中仍需谨慎对待。
结语
CriticGen 的核心贡献在于重新定义"什么是好的评估":好的评估不应只是孤立的分数,而应是实例化、可执行、能直接驱动改进的反馈闭环。在大模型越来越依赖自我评估与自我优化的今天,这类将评估转化为可执行控制的框架,或将成为提升模型输出质量的关键基础设施。
相关推荐

对抗AI代码腐化:规格、结果笔记与文件清单的实战方法
一位开发者用八个月、650次提交、4.3万行代码的实战,总结出防止AI智能体代码库腐化的方法:前置规格与验收标准、任务结果笔记、文件清单约束,以及用触发式钩子取代规则文件。核心洞察是——指令只是建议,机制才能在长会话中存活。

"Tokens Exhausted":一段机器人视频背后的AI焦虑
一段名为「Tokens Exhausted」的机器人视频在 Reddit 引发热议,网友已分不清它是否为波士顿动力真实作品。本文解析这段AI讽刺内容为何戳中神经,以及它折射出的合成媒体与LLM时代焦虑。

4千美元淘到全新DGX Spark:本地部署大模型的性价比之选
一位Reddit用户以4000美元在Craigslist淘到全新DGX Spark,用于本地托管AI模型。本文解析这笔交易背后的性价比、二手交易安全,以及本地部署大模型的兴起趋势。