CrofAI造假门:号称全球最便宜的推理服务被扒是套壳骗局
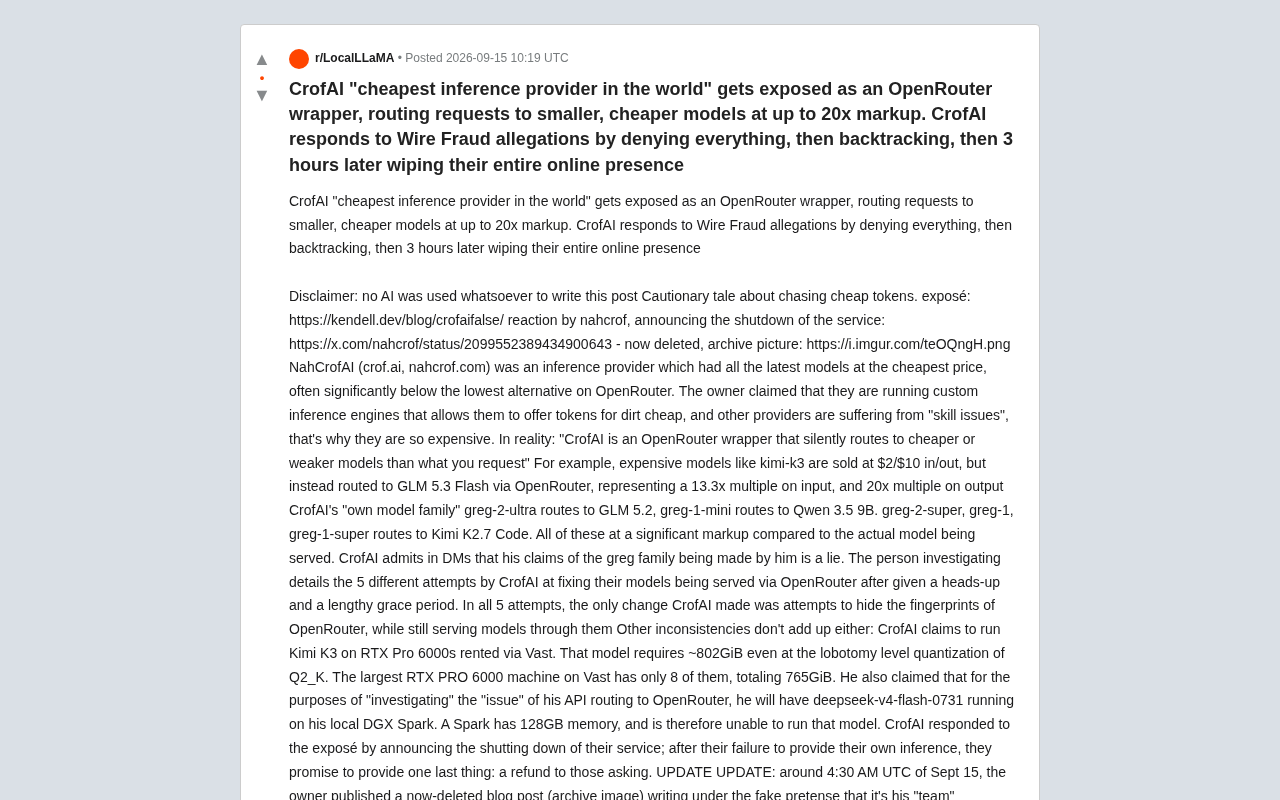
AI公司CrofAI以"最便宜推理"为幌子,实为OpenRouter套壳加价最高20倍,曝光后删号跑路。
自称"全球最便宜推理服务商"的CrofAI被独立调查者Kendell技术核查揭穿:其所谓自研推理引擎并不存在,全部请求均通过OpenRouter中转,并被偷偷路由至GLM、Qwen、Kimi等廉价模型,输入端加价最高13.3倍、输出端高达20倍。其宣传的"自研greg模型家族"同样是彻头彻尾的谎言,创始人在私信中亲口承认。调查期间,CrofAI五次"修复"均只是在掩盖OpenRouter的响应指纹,从未真正建立自有基础设施。硬件说辞亦漏洞百出,其声称的运行方案在公开可查的显存参数面前完全不成立。面对曝光和电信欺诈指控,CrofAI先否认、后改口、再伪造"团队接管"剧情,最终删除全部线上痕迹。此事件警示开发者:价格异常低廉的推理服务需用技术手段主动核查,"你付费调用的模型是否真实"正成为不可忽视的信任议题。
一家自称"全球最便宜推理服务商"的AI公司CrofAI,被独立调查者揭穿其真面目——所谓的自研推理引擎根本不存在,实际上只是一个OpenRouter的"套壳",偷偷将用户请求转发给更小、更廉价的模型,加价最高可达20倍。面对指控,CrofAI先是全盘否认,随后改口,三小时后干脆删除了全部线上痕迹。这是一则关于"贪便宜token"的警世故事。
便宜到不合理的价格背后
CrofAI(域名crof.ai、nahcrof.com)此前主打一个卖点:拥有全部最新模型,价格往往显著低于OpenRouter上的最低报价。创始人声称自己运行着定制推理引擎,才能把token价格压到"白菜价",还嘲讽其他服务商价格高是因为"技术不行(skill issues)"。
这种叙事在追求低成本的开发者群体中极具诱惑力。但据调查者Kendell在其博客(kendell.dev)发布的详细技术分析,真相是:"CrofAI是一个OpenRouter的套壳,悄悄把你请求的模型路由到更便宜或更弱的模型上。"
换句话说,用户以为自己在调用顶级模型并支付了相应费用,实际拿到的却是被替换后的廉价替代品,而差价则被CrofAI收入囊中。
20倍加价的具体操作
调查揭示的定价与实际路由之间的落差令人咋舌。以昂贵的kimi-k3为例,CrofAI以每百万token输入2美元、输出10美元的价格出售,但请求实际被转发到OpenRouter上的GLM 5.3 Flash。这意味着输入端存在13.3倍的加价,输出端更是高达20倍。
更荒唐的是所谓"自研模型家族"greg系列。调查显示:
- greg-2-ultra 实际路由到 GLM 5.2
- greg-1-mini 实际路由到 Qwen 3.5 9B
- greg-2-super、greg-1、greg-1-super 实际路由到 Kimi K2.7 Code
这些"自研模型"全部以相对实际被调用模型的高额溢价出售。在私信中,CrofAI本人也承认greg系列出自其手的说法纯属谎言。
GLM 5.3 Flash、Qwen 3.5 9B、Kimi K2.7 Code均属于开源或低价商用模型序列,推理成本远低于旗舰级模型。GLM系列由清华大学与智谱AI联合开发,Flash版本专为高吞吐低延迟场景优化,每百万token定价通常在零点几美分量级;Qwen 3.5 9B是阿里巴巴通义千问的中等参数版本,9B参数量意味着可在单张消费级GPU上运行,边际推理成本极低;Kimi K2.7 Code则是月之暗面专为代码任务裁剪的轻量模型。这些模型在能力和价格上与顶级旗舰模型(如完整版Kimi K3或GPT-4级别)存在本质差异,但名称相近容易混淆。OpenRouter作为聚合中间层,会公开每个模型的实际计费价格,调查者正是通过比对CrofAI的收费价格与OpenRouter上对应模型的透明定价,精确计算出各档次的加价倍数。
五次"修复"只是在掩盖指纹
调查者在正式曝光前给了CrofAI相当长的宽限期和预警,记录下对方五次"修复"模型被OpenRouter代理这一问题的尝试。结果耐人寻味:在全部五次尝试中,CrofAI唯一做的事情就是想办法隐藏OpenRouter的指纹特征,而请求依旧照样通过OpenRouter转发。
这种行为模式本身就极具说服力——一个真正拥有自研推理引擎的公司,根本不需要费尽心机去掩盖第三方服务的痕迹。
OpenRouter在HTTP响应头、错误消息格式、特定字段命名惯例等方面存在可识别的"指纹"特征,例如响应中可能携带x-openrouter-*系列header,或在流式输出的特定字段中留下平台标识。调查者正是通过捕获这些指纹来确认请求经过OpenRouter中转。CrofAI的五次"修复"尝试包括过滤响应头、修改错误返回格式等操作,但始终未能切断与OpenRouter的实际连接,每次"修复"后调查者仍能通过更深层的特征验证路由路径。这种只改外观、不动实质的行为模式,在调查报告中被用作"无自研引擎"的核心佐证——真正自建基础设施的服务商根本不会在意第三方平台的指纹是否被看见。
硬件账算不过来
除了路由证据,CrofAI的技术说辞在硬件层面也漏洞百出。
CrofAI声称通过Vast租用RTX Pro 6000来运行Kimi K3。但即便采用极度激进的Q2_K量化(业界戏称的"脑叶切除"级别压缩),该模型也需要约802GiB显存。而Vast上最大的RTX PRO 6000机器只有8张卡,合计仅765GiB——根本装不下。
更离谱的是,他还声称为了"调查"自家API路由到OpenRouter的"问题",会在本地DGX Spark上运行deepseek-v4-flash-0731。然而一台DGX Spark只有128GB内存,同样无法运行该模型。这些自相矛盾的技术细节,进一步坐实了整个叙事的虚构性。
Q2_K量化是GGUF格式中压缩比最激进的量化方案之一,将模型权重从原始的16位或32位浮点数压缩至平均约2.5比特,显存占用可降低至原来的1/6左右,但代价是模型能力的显著退化,在推理质量敏感的任务上与全精度模型差距明显。业内将其戏称为"脑叶切除(lobotomy)"正是出于此。Vast.ai是一个GPU算力租赁市场,用户可以在上面按小时租用各类消费级和专业级显卡,RTX PRO 6000是NVIDIA面向专业工作站的新一代卡,单卡显存96GiB。即便拼满8张(765GiB),也无法容纳802GiB的最低需求,这一公开可查的参数差距使CrofAI的硬件说辞在数字层面完全站不住脚,无需任何黑盒测试即可证伪。
从否认到删号跑路
面对曝光,CrofAI的公关应对堪称一场闹剧。
最初,创始人宣布关闭服务,承认无法提供自研推理,并承诺给要求退款的用户退款。据存档记录,在UTC时间9月15日凌晨约4:30,他发布了一篇随后被删除的博客,假借"团队"名义撰写,称创始人此前的所有言论"是在巨大压力下写的,把情况描述得比实际更糟",并宣布新团队接管、服务将在两周后恢复。
话说回来,CrofAI的推特账号也"被团队接管",每条回复都以"Hey, Nathan here"开头,声称创始人退居幕后。这套"假团队"表演只持续了几个小时。或许是因为公众根本不买这个惯性说谎者的第N个故事,或许是被网友反复提醒"电信欺诈(wire fraud)会构成多项罪名",他最终删除了所有线上痕迹:nahcrof.com和crof.ai返回404,推特账号被删,/r/CrofAI板块也已设为私密。
廉价token的警示
这起事件对整个AI开发者社区是一记警钟。当一家服务商的价格显著低于市场所有竞品,且用"别人技术不行"来解释自己的低价时,理性的反应应当是警惕而非欣喜。
AI推理本质上是重资本、重算力的生意,硬件和电力成本构成了价格的硬底线。任何声称能长期、大幅突破这个底线的服务商,都值得用技术手段去验证——比如检查响应指纹、比对模型行为特征、核算硬件可行性。CrofAI能被揭穿,正是依靠了这些扎实的技术核查。
对于依赖第三方推理API的团队而言,"你付钱调用的模型,是否真的是你以为的那个模型",正在成为一个不容忽视的信任问题。
相关推荐
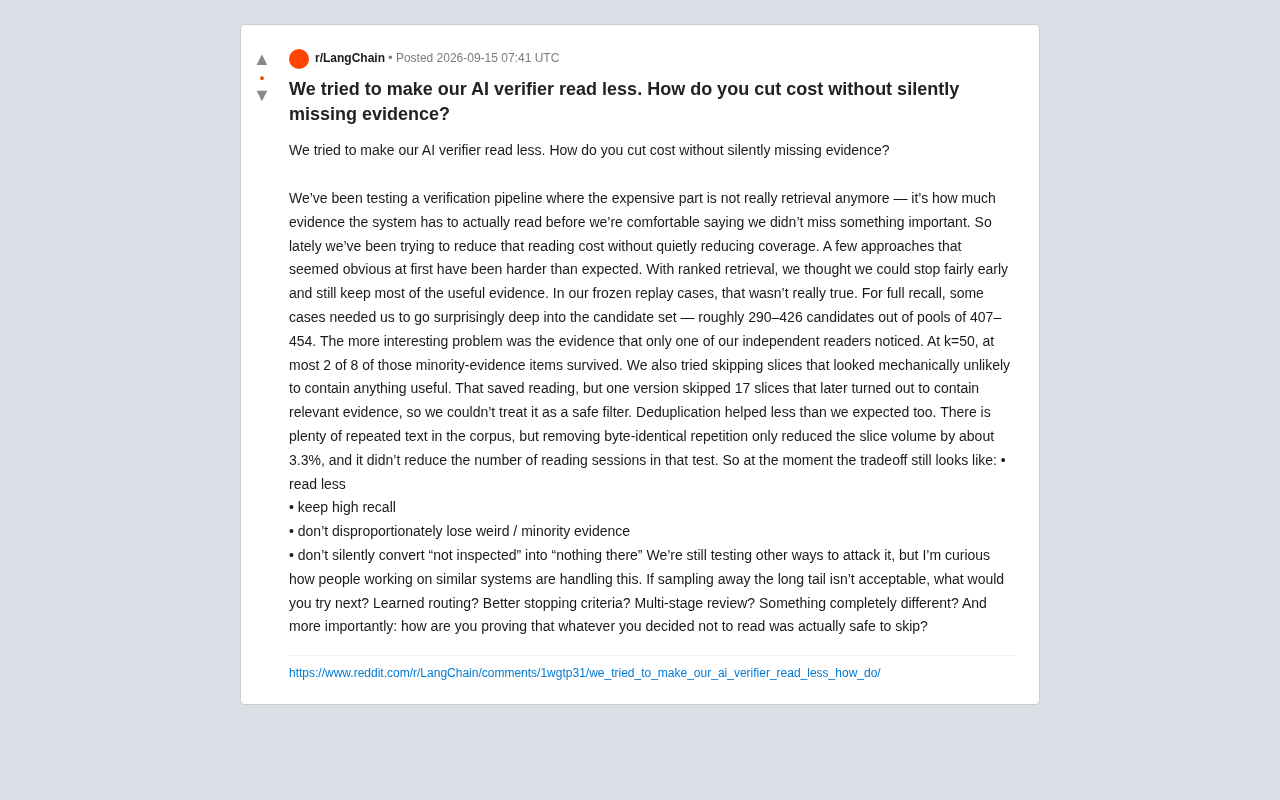
AI验证系统降本困局:如何少读证据又不漏掉关键信息
AI验证系统的真正成本不在检索而在阅读证据量。本文剖析一个RAG验证流水线的降本实践:提前停止、跳过切片、去重为何收效甚微,以及如何在保持高召回率的同时不漏掉少数派证据这一核心难题。
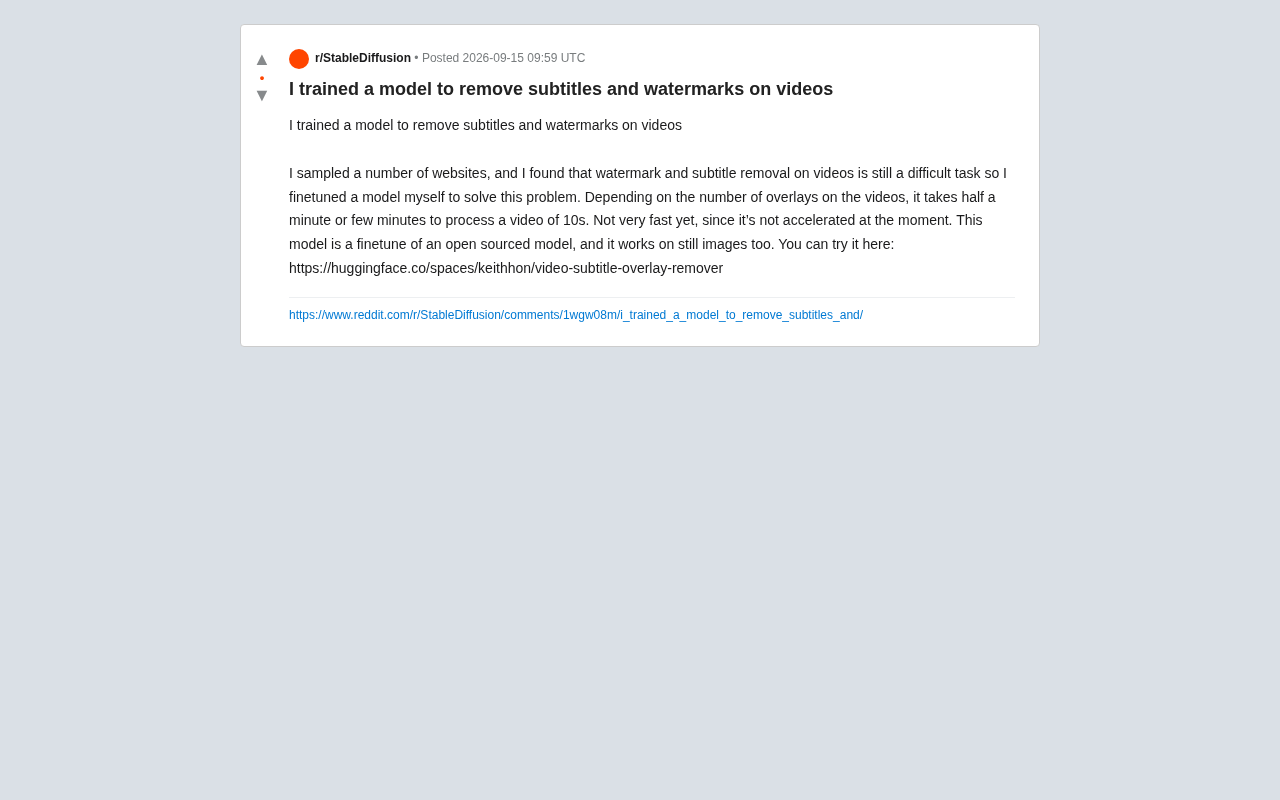
开发者微调AI模型实现视频字幕与水印去除
一位开发者微调开源模型,实现视频字幕与水印去除功能,支持图片处理,已部署在Hugging Face上开放试用。本文解析其实现思路、性能表现与应用争议。
Salesforce联手英伟达推Koa模型:企业AI的开源突围
Salesforce与英伟达联合推出基于开放权重模型Nemotron的推理模型Koa,专注销售、营销和客服场景。本文分析这一垂直化AI策略为何值得通用大模型实验室警惕,以及它对行业格局的启示。