Cursor工程师揭秘:AI协作的真正瓶颈是信任而非模型
Cursor工程师Lauren分享如何通过验证机制、强约束架构与信任曲线,将AI Agent从受监视的助手培养为可自主合并PR的协作伙伴。
来自Cursor团队的工程师Lauren提出,AI Agent协作的真正瓶颈不在于模型能力,而在于人与Agent之间信任体系的建立。他用自身经历描绘了一条「信任曲线」:从逐行盯梢Agent输出,到让Agent自动合并PR、单月提交近800个PR。实现这一跨越的核心在于三个层次:其一是赋予Agent自我验证能力(通过Chrome DevTools Protocol等工具让其能真实运行和测试代码);其二是用feature map和Eval机制让技能可被评估和维护;其三是从架构层面为「最笨的Agent」设计代码库——用禁用useEffect、强制进程隔离等硬性CI规则取代软性的人工code review提醒。这套强约束架构的意外收获,是让PM、设计师等非技术人员也能直接提交高质量代码,实现真正意义上的团队普惠。
当越来越多工程师用AI Agent写代码,一个绕不开的问题浮现出来:你敢信任它写的代码吗?来自Cursor团队的工程师Lauren在一场技术分享中给出了他的答案——AI协作真正的天花板不在模型能力,而在于你与Agent之间的信任体系是否建立起来。
从「事事盯梢」到「自动合并PR」的信任曲线
Lauren用一个类比切入这个话题:如果你是工程经理,带着一支你不信任的团队,那你的工作模式必然是「微观管理」——时刻盯着下属的肩膀,检查他们有没有把bug推到生产环境。用Agent写代码同样如此。
他画了一条并不严谨、却极具说服力的「信任曲线」。一年前,大多数人使用Agent时都被困在曲线底部:深度介入每一个环节,盯着每一条输出,手动敲提示词,根本无法并行。原因很简单——当你连一个Agent的输出都不敢信任时,你不可能同时驱动一百个Agent。
经过五个月的爬坡,Lauren走到了曲线的另一端。他坦言这话听起来「像个偷懒的骗子」,但事实是:他现在让Agent自动合并PR。「我今天早上醒来,已经有20个PR落地了,我直接在主分支上review它们——它们已经合进去了,而且写得很好。」他上个月提交了1000个PR,本月才到12号就已接近800个。
这条曲线几乎与他在Cursor的贡献量成反比映射:入职第一个月因为不熟悉代码库、也不信任Agent而效率低下,随着信任建立,产出急剧攀升。他强调分享这条曲线不是炫耀,而是说明——从底部到顶部没有捷径,这本质上是你个人对Agent信任程度的旅程。
核心技能:让Agent学会「自我验证」
在Lauren看来,与Agent协作最重要的一项能力是验证(Verification)——让Agent能够真正运行代码、抓取CPU trace、采集堆内存快照、打开iOS模拟器,用用户实际使用产品的方式去测试和检验它写的代码。
「这并不能保证Agent写出好代码,但能让它至少写出正确的代码,这是建立信任的一大步。」他指出,如果没有验证能力,人类自己就成了那个瓶颈:你让Agent做事,它写完代码,你打开本地构建,发现不对,再复制粘贴报错截图给它,它慢慢理解、修改……你被死死困在这个循环里,无法并行。
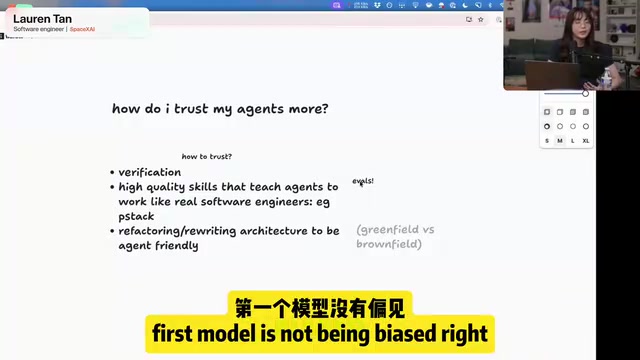
Lauren分享了他为Cursor的Agent窗口(内部代号glass)构建验证技能的经历。他刚入职一周,就要在deadline前处理一个React应用的性能问题。他打开Chrome开发者工具抓trace,把截图丢给Agent,Agent却只会「自信地」猜测问题所在,试了才发现根本不对。于是他构建了「control glass」技能,教Agent使用Chrome DevTools Protocol来运行应用、抓取trace并实现程序化控制。
Feature Map:给Agent一张「产品地图」
光有控制能力还不够——Agent根本不知道Agent窗口长什么样。用户说「左侧边栏卡顿」或「PR标签页不工作」,Agent只会到处乱撞,浪费大量时间查代码却找不到功能入口。
解决办法是一个叫feature map的独特文件。它教会Agent如何到达产品里的每一个功能:从用户视角出发的导航路径、各种键盘快捷键、甚至用于选择元素的DOM属性。有了它,即便用户丢来一张模糊的截图配上三个问号「???」,Agent也能凭借上下文理解并定位问题。Lauren的开源插件PSAC(潜台词是恶搞Y Combinator CEO Gary Tan的G-Stack)里包含了创建和维护这种验证技能的能力。
Chrome DevTools Protocol(CDP)是Google Chrome浏览器暴露的一套低层调试接口,允许外部程序通过WebSocket以JSON-RPC协议对浏览器实例进行程序化控制——包括捕获网络请求、执行JavaScript、录制性能trace、截取页面截图等。与Selenium、Playwright等上层自动化框架相比,CDP能以更细粒度访问V8引擎的CPU分析器(Profiler)和堆内存快照(HeapSnapshot),这正是性能诊断场景中不可替代的优势。Lauren所构建的「control glass」技能,本质上是将CDP封装为Agent可调用的工具,使Agent无需人类在中间传递截图,就能自主闭环地完成「运行→检测→定位瓶颈→修改」的完整循环,这是从「人类是瓶颈」走向「Agent自主验证」的关键技术基础。
Eval:给Agent技能写「单元测试」
产品在持续演进,很多人同时向代码库提交代码,这些技能如何维护?Lauren的答案是Eval(评估)——他的心智模型是「Agent的单元测试」。
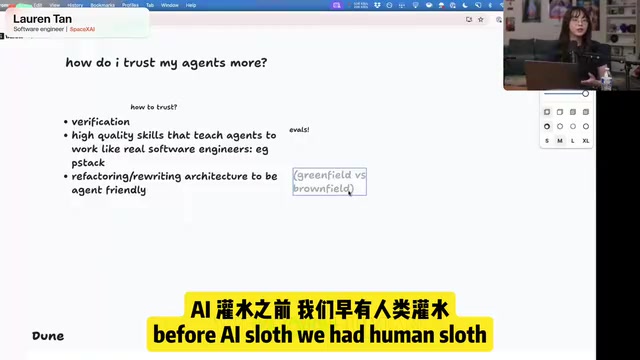
具体做法是:由一个主协调Agent制定评分rubric,然后派生出多个子Agent,为它们创建刻意命名以掩盖「正在被评估」这一事实的目录(因为Agent一旦察觉自己在被测试,就会改变行为)。同时用一个不同模型的裁判Agent做交叉验证,防止偏见。得益于Cursor支持多种模型,他可以在整个模型矩阵上评估同一个技能的表现。
更进一步,Eval可以「爬山(hill climb)」——用slash loop命令持续迭代,直到所有项都达到10分。Lauren的control技能正是这样近乎全自动地打磨出来的。他也坦言维护技能其实很难,需要大量的品味和观察,「你要善于做一个后座司机」,认真阅读Agent的每一个工具调用和思考过程,找出它失败的地方,再针对性地构建技能。
「裁判Agent使用不同模型做交叉验证」这一设计,源于LLM评估中广为人知的「自我偏好(self-preference)」问题:研究表明,当使用同一模型同时扮演生成者和评判者时,模型倾向于给自己的输出打高分,哪怕质量客观上并不更好。引入异构模型作为裁判(例如用Claude评估GPT生成的结果,或反之)可以在统计层面抵消这种偏差。这与机器学习中的交叉验证思想一脉相承:通过独立的、具有不同归纳偏置的评估者来提升结论的可信度。Lauren将这一学术界已有讨论的技巧工程化地落地到日常技能评估流程中,是「把AI评估方法论带入软件工程实践」的典型案例。
从本地信任到云端规模化:Benny机器人的启示
Lauren建议的完整路径是:先从本地开始建立验证技能,能观察Agent如何与应用交互;当你在本地信任它之后,再扩展到云端Agent。
Cursor云端Agent的强大之处在于,一旦你花时间配置好环境,这些控制与验证技能会带来巨大红利——它不只是让你一个人更强,而是提升整个团队乃至整个公司。他举了一个内部Agent「Benny」的例子:Benny接收所有bug报告,自动在云端开启一台桌面环境,运行Cursor,用同样的控制技能去复现用户报告的问题。有一次Benny复现了bug,却发现它在主分支上已经修复了,于是自动确认「这个问题已解决,只需再发一个构建即可」。这为团队省下了大量本需人工验证的时间。
不过Lauren反复强调:这是一段旅程,你必须先建立信任。他明确劝阻新手直接跳到「一次派生上百个云端Agent」,那只会浪费大量token、成本高昂。
强约束架构:为「最笨的Agent」设计代码库
访谈中最有见地的部分,是Lauren关于代码库架构的观点。他大胆为「重写应用」辩护,并指出一个反直觉的现象:大厂的历史包袱如今成了每个人的问题。
他曾在Meta工作,那里有成千上万工程师在一个巨型monorepo里写代码,「你会惊讶于代码质量其实并不好」。他调侃道:「在AI slop之前,我们有human slop(人类垃圾代码)。」但大厂基础设施恰恰是为「团队中能力最弱的工程师」设计的——框架、规范、护栏、权限限制,防止实习生抹掉生产数据库。有了这层基础设施,Agent反而能做得不错,因为护栏已经就位。
真正的风险在于全新的绿地项目(greenfield)。像Grokbot这样快速vibe code出来的原型,几乎没有任何护栏,Agent会用最便捷的方式解决问题,代码库最终「螺旋失控」——他称之为「有机架构(organic architecture)」,一个被短期捷径过度优化、无人能理解的烂摊子。
Dune架构:把所有约束变成硬性CI失败
Grokbot的架构代号叫Dune,Lauren把它类比为「面向Agent的、给Electron应用用的Next.js」。它的CI严苛到「烦人」的程度:
- 禁用useEffect:这是React最大的坑之一,CI直接报错
- 禁止代码注释:因为99%的情况下Agent写的注释都在描述无关的历史信息
- 强制进程隔离:设立electron-main和electron-renderer目录,用CI检查依赖图,防止重计算代码意外被拉进渲染线程导致掉帧
Lauren提出了一套分层防御的心智模型。最强的一层是代码库架构本身:因为Agent最爱复制现有模式,把功能全部收拢在单一目录里、约定唯一正确的写法,就是最强约束。他的核心原则是「最短路径即最佳路径」——既然Agent总爱走捷径,那就让捷径成为最优解。
往上是静态分析、编译器诊断、CI检查(硬约束),再往上才是rules、skills和BugBot(软约束)。他强调绝不能只依赖软约束:「如果你只有rules、BugBot、skills和风格指南,你的代码库变成垃圾只是时间问题。」
他给出的黄金法则是:每当你在code review里手动指出「你不应该这样做」,都应视为一种代码异味。你要问自己——如何把它变成一条lint规则?一条CI失败?或者干脆从根本上消除这类问题?
useEffect是React函数组件中用于处理副作用(side effects)的Hook,常见用途包括数据请求、DOM操作、订阅事件等。它之所以被称为「React最大的坑之一」,是因为其依赖数组(dependency array)的语义极易被误用:遗漏依赖会导致闭包过期(stale closure)、过度依赖则引发无限渲染循环,而依赖对象引用不稳定又会造成意外的重复触发。对于AI Agent而言,这一风险被进一步放大——Agent在补全代码时往往依照训练数据中的高频模式行事,而useEffect恰恰是Stack Overflow上大量「快速解决方案」的常客,极易被无差别地复制进代码库。将其在CI层面完全禁用,是一种「消除整类错误」而非「逐个纠错」的防御哲学的具体体现。
「Greenfield项目」(绿地项目)在软件工程语境中指从零开始、不受任何既有系统约束的全新项目,与之对应的是需要在遗留代码上迭代的「Brownfield项目」(棕地项目)。绿地项目听上去自由,却恰恰因为缺乏历史沉淀的规范与护栏而暗藏风险——尤其当Agent被用于快速原型开发时。Agent会沿着阻力最小的路径行进:哪里有可复用的模式就复制哪里,哪里能用全局变量省事就绝不抽象。在无规范约束的绿地环境中,这种行为会以指数级速度累积技术债务,最终形成Lauren所说的「有机架构」——表面上功能完整,内部却是无人能完整理解的依赖网络。这也是为什么他主张在项目最早期就引入严苛的CI约束,而不是等到代码库「失控」后再补救。
ROI与普惠:不只是省token的问题
面对「普通人没有无限token怎么办」的质疑,Lauren承认自己身处AI实验室有token优势,但他把这看作ROI问题。前期重构代码库确实烧钱(他为Grokbot的新架构提交了600多个PR),但如果我们正走向Agent编写所有代码的世界,你会希望团队保持精简,而不是变成一万人的工程组织。
Agent的真正价值不在于「每件小事都省token」,而在于让你做到过去做不到的事——比如凭一己之力在代码库中强制执行如此高的约束标准。
这套强约束架构还带来意外的普惠效应:因为Dune的约束足够严格,产品经理、设计师甚至GTM人员都能直接贡献高质量代码。Grokbot正是他们「非技术人员的Cursor时刻」——界面像iMessage一样亲切,每个Agent像一个有身份的「人」,可以自然地编排协作。Lauren说,现在PM们也在提交代码,「他们说这个bug我修好了,你看一下,我review发现完美,直接盖章通过」——这恰恰证明了Dune架构的严格约束正在生效。
相关推荐
企业级AI Agent全栈开发实战:从零搭建可上线智能体的学习路径
一份企业级AI Agent全栈开发课程导学解析:涵盖为什么学Agent、适合人群、LangChain与CrewAI框架学习路径,以及从单智能体到多智能体的实战落地方案,助你搭建可上线的智能体应用。
从真实项目拆解AI智能体:基于LangGraph的学习助手架构实践
以真实上线的AI学习助手为例,拆解基于LangGraph、Neo4j知识图谱、Redis与MinIO的智能体架构实践,解析为何面试官偏爱复杂真实项目,以及FDE岗位的求职方向。
LangChain 1.3 入门指南:大模型与Agent核心概念解析
LangChain 1.3入门教程:解析大语言模型的三大局限、框架的统一接口与模块化架构,以及LLM、Agent、DeepAgent与Harness架构的层级关系,助你理解大模型应用开发核心概念。