Cursor Composer 2.5深度解析:1/10成本比肩Claude Opus 4.7的编码能力
Cursor自研Composer 2.5以低成本实现顶级编码能力
Cursor基于Kimi K2.5开源模型,将85%算力投入后训练,通过文本反馈定向强化学习和大规模合成数据生成等创新技术,打造出Composer 2.5模型。该模型以不到十分之一的成本实现了与Claude Opus 4.7、GPT 5.5比肩的编码能力,尤其在长任务链稳定性上表现突出,有望重塑AI编程工具市场格局。
文章正文
当AI编程助手进入长任务链Agent时代,模型不再只是补全一两行代码,而需要持续稳定地执行数十步复杂操作。Cursor最新推出的自研模型Composer 2.5,通过独特的大规模后训练策略,以不到十分之一的成本实现了与Claude Opus 4.7、GPT 5.5比肩的编码能力,并在长任务稳定性上表现突出。这种高性价比路线,很可能重塑AI编程工具的市场格局。
技术全景:85%算力投入后训练,重塑模型能力边界
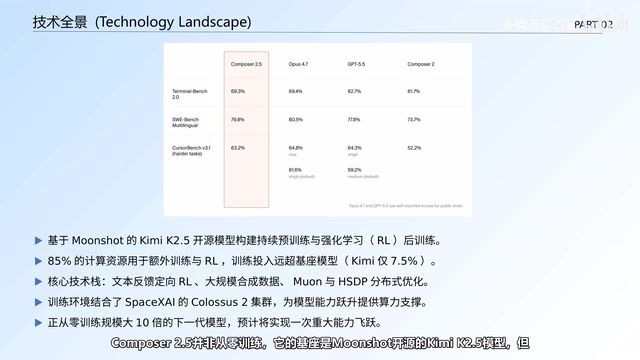
Composer 2.5并非从零训练,它的基座是Moonshot开源的Kimi K2.5模型。Kimi K2.5是月之暗面(Moonshot AI)开源的大规模混合专家(MoE)语言模型,其架构设计在代码理解和多语言编程任务上具备较强的基础能力。MoE架构的核心优势在于:模型拥有大量参数总量,但每次推理只激活其中一小部分"专家"子网络,从而在保持高性能的同时大幅降低推理计算成本。这一特性使其成为专精化后训练的理想基座——庞大的参数容量为领域知识提供了充足的存储空间,而稀疏激活机制则保证了推理效率。Cursor选择Kimi K2.5而非GPT或Claude系列作为基座,一方面是开源协议带来的自由度,另一方面也体现了对MoE架构在编码专精场景下潜力的判断。
但Cursor的野心绝不止于做一次微调——报告中最惊人的数字是:85%的计算资源被投入到额外的持续预训练和强化学习后训练中,而Kimi K2.5本身的后训练算力仅占7.5%。可以说,模型的绝大部分能力提升来自Cursor自己的训练流程。

核心技术栈包括文本反馈定向强化学习、大规模合成数据生成,以及使用MUON优化器与HSDP分布式方案的训练基础设施。训练运行在SpaceX AI的Colossus 2集群上,为模型能力跃升提供了充沛算力。更值得关注的是,他们正在与SpaceX AI合作从零训练一个规模大十倍的模型,预计将实现一次代际超越。
这不仅是算力分配的区别,更体现了设计哲学的根本不同:原生基座追求广谱知识覆盖,而专精模型需要把几乎所有资源都倾注在特定行为的塑造和纠错上。
核心创新一:基于文本反馈的定向强化学习
在长序列rollout中,强化学习的信用分配是个经典难题。所谓信用分配(Credit Assignment),是指当智能体执行了一长串动作序列后才获得奖励信号时,如何判断哪些具体步骤对最终结果起到了正面或负面作用。在代码Agent场景下,一次完整任务可能涉及数十次工具调用、数万行上下文,轨迹长度可达数十万token,稀疏奖励的问题被极度放大——当整个轨迹跨越数十万token,最后只有一个稀疏奖励,模型很难定位哪一步具体行为导致了失败。
Composer 2.5引入了一种巧妙的解决方案:在轨迹中模型出错的位置(比如错误调用了一个不可用的工具),训练系统会插入一条简短的局部提示(如提醒可用工具列表),然后把这个上下文下模型的预测分布当作"教师信号",通过on-policy KL散度损失让原始策略的token概率向教师分布靠拢。这一设计本质上是将稀疏奖励问题转化为密集的局部监督问题,从根本上绕开了长序列信用分配的困境。
这样做的好处是双重的:既能精准纠正局部的错误(工具调用混乱、解释偏差或代码风格问题),又不会破坏完整轨迹上的整体强化学习目标。这种方法把训练力度提升到了前所未有的精细程度。
核心创新二:大规模合成数据与奖励作弊防御
随着模型在强化学习训练中编码能力不断提升,简单任务很快就被"解决光了
相关推荐
Meta Muse六天下载破90万:AI Agent时代正式来临
Meta Muse六天下载破90万:AI Agent时代正式来临
Meta旗下个人AI智能体Muse上线仅六天下载量突破90万,连续登顶美国App Store与Google Play双榜,超越ChatGPT、Claude等明星产品。本文深度解析Muse的核心能力、入口优势与AI Agent赛道的竞争格局。
 行业洞察
OpenAI内部Codex使用量暴增56倍,AI编程正在吞噬一切
OpenAI披露内部Codex使用数据:研究部门增长56倍,客户支持32倍,工程27倍,法务13倍。从技术到非技术部门,AI编程工具的渗透速度远超预期,揭示企业AI采用率正处于关键拐点。
 行业洞察
美国国税局IRS全面引入Claude AI,联邦政府AI化进程加速
美国国税局IRS正在招募可全天候使用Claude AI的员工,标志着Anthropic成功打入联邦政府核心部门。本文分析IRS引入AI的战略意义、税务场景应用前景及对行业的深远影响。