大模型并非贝叶斯:概率信念更新的内在不一致性解析
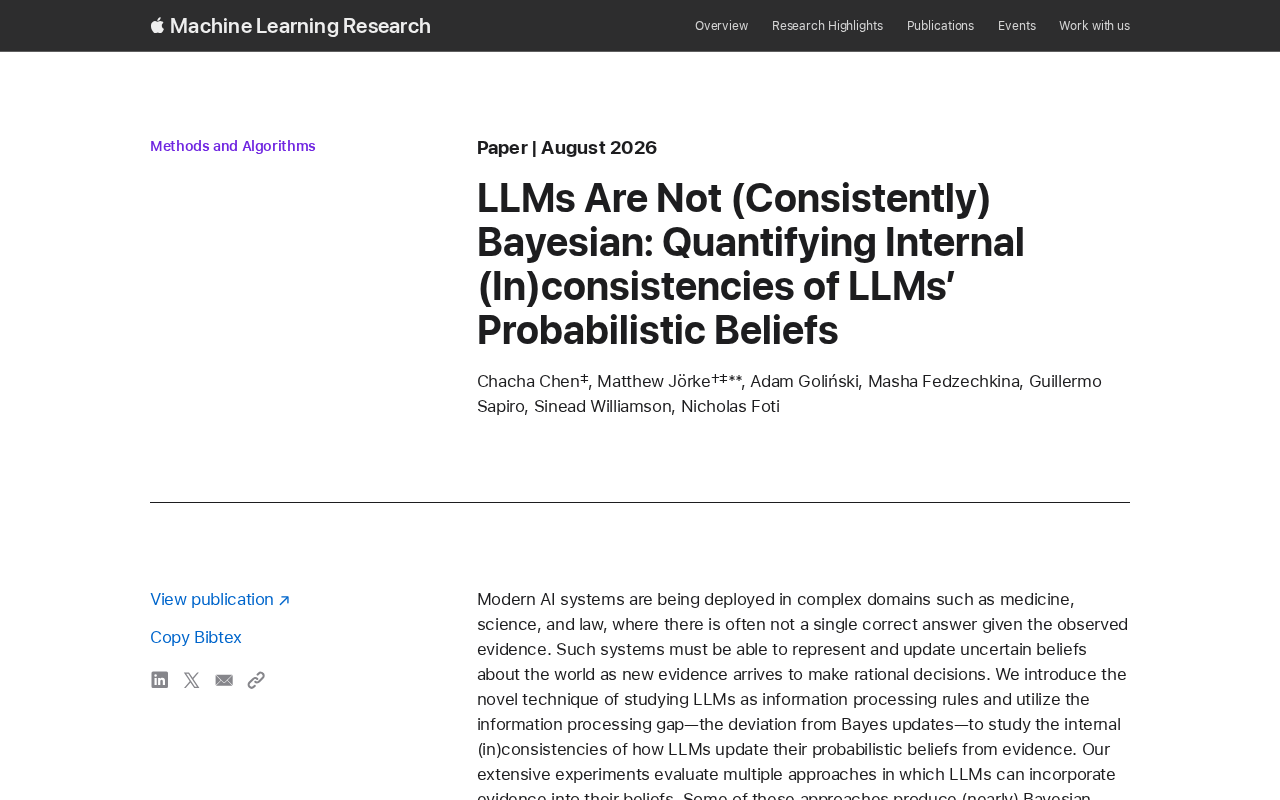
大语言模型的概率信念更新存在系统性偏差,无法稳定遵循贝叶斯推理规则。
这项研究将大语言模型(LLM)视为"信息处理规则",并引入"信息处理鸿沟"这一量化指标,衡量模型实际的信念更新与理想贝叶斯更新之间的偏差。研究发现,LLM在面对逻辑等价的证据时,会因呈现顺序或表述方式的差异而给出前后矛盾的概率判断,说明其概率信念并非建立在一致的推理逻辑之上。这一缺陷对医疗、法律等高风险场景尤为危险:不可信任的置信度输出、多步推理中的偏差累积,以及无法用传统准确率指标检测的内在矛盾,共同构成了AI可靠部署的三重警示。研究同时提供了可量化的诊断框架,为未来通过贝叶斯约束训练或自校验机制改进模型指明了方向。
当AI进入没有标准答案的领域
现代AI系统正被广泛部署到医学、科学、法律等复杂领域。这些领域有一个共同特征:面对同样的证据,往往并不存在唯一正确的答案。医生需要根据检查结果评估多种可能的诊断,法官需要基于证据链推断事实的可能性,科研人员则需要在不完整数据中判断假设的成立概率。
在这些场景中,一个可靠的智能系统必须具备一种核心能力——表征并更新对世界的不确定信念。也就是说,当新的证据到来时,系统应当能够理性地调整自己此前的判断。这正是概率推理的本质,也是贝叶斯定理所刻画的理想信念更新方式。
然而,当前大语言模型(LLM)是否真正具备这种一致的概率推理能力?一项最新研究给出了发人深省的答案:大模型并不始终如一地遵循贝叶斯规则,其概率信念存在内在不一致。
将LLM视为信息处理规则:一种全新分析框架
该研究提出了一种新颖的分析视角:将大语言模型视为一种信息处理规则(information processing rule)。在这个框架下,模型的每一次"从证据到信念"的转换,都可以被看作一个可度量的处理过程。
信息处理鸿沟:衡量LLM与贝叶斯理想的距离
研究引入了一个关键指标——信息处理鸿沟(information processing gap),用于衡量模型实际的信念更新与理想贝叶斯更新之间的偏差。
贝叶斯更新是概率推理的"黄金标准":给定先验概率和新证据的似然,理性主体应当按照贝叶斯公式得出唯一确定的后验概率。如果一个系统是自洽的贝叶斯推理者,那么无论以何种顺序、何种方式呈现相同的证据,它得出的最终信念都应当一致。
通过测量这一鸿沟的大小,研究者得以量化LLM在概率信念更新过程中的内在一致性(或不一致性)。这种方法的巧妙之处在于,它不依赖于"正确答案"是否存在,而是直接考察模型自身推理的逻辑连贯性。
为什么一致性比准确率更重要
对于部署在高风险领域的AI而言,内在一致性甚至比单次准确率更为关键。一个偶尔出错但逻辑自洽的系统,其行为是可预测、可校准的;而一个概率信念自相矛盾的系统,则可能在相同证据下给出前后矛盾的结论——这在医疗诊断或法律推理中是极其危险的。
大模型概率推理的系统性偏差
研究通过大量实验评估了LLM在概率信念更新上的表现,核心发现是:大模型的信念更新与贝叶斯规则之间存在系统性偏差。
这意味着,即便面对逻辑上等价的证据呈现方式,模型也可能得出不一致的概率判断。换言之,LLM的"信念"并不像理性主体那样稳定和自洽,而是会受到证据表述方式、呈现顺序等无关因素的影响而发生漂移。
对AI实际落地的三重警示
这一发现对AI应用部署有着直接的警示意义:
- 不能盲目信任LLM输出的概率或置信度。模型给出的"可能性"评估可能并非建立在一致的概率逻辑之上,其数值的可靠性需要额外验证。
- 在多步证据整合任务中风险会逐步放大。每一步的贝叶斯更新偏差可能累积,导致最终判断严重偏离理性结果,这在多轮诊断推理中尤为突出。
- 一致性应成为AI可靠性评估的独立维度。传统的准确率指标无法捕捉这种内在的逻辑矛盾,需要引入信息处理鸿沟等新型评估标准。
迈向更可靠的概率推理AI
这项研究的价值不仅在于揭示问题,更在于提供了一套可量化的诊断工具。通过信息处理鸿沟这一指标,研究者和开发者可以系统地测量并比较不同模型在概率推理上的可靠程度。
从更长远的视角看,要让AI真正胜任医学、科学、法律等不确定性密集的领域,仅靠扩大模型规模或提升语言流畅度是远远不够的。如何让模型学会一致、理性地处理不确定信息,才是通向可信AI的关键一环。
未来的改进路径可能包括以下方向:
- 在训练或推理阶段引入显式的贝叶斯约束
- 设计能够检测并修正信念不一致的自校验机制
- 建立更完善的概率校准评估基准
只有当AI的"信念系统"变得像理性主体一样稳健时,我们才能放心地将真正重要的决策交给它们。
结语
"大模型不是贝叶斯的"——这个结论提醒我们,语言能力的强大并不等同于推理逻辑的严谨。在惊叹于LLM流畅表达的同时,我们更需要审慎地审视其在不确定性推理上的内在缺陷。对于任何计划将AI部署到高风险决策场景的团队而言,理解并量化这种"信息处理鸿沟",是确保AI可靠性不可回避的课题。
相关推荐
Ollama入门:本地部署开源大模型的核心工具解析
本文详解 Ollama 是什么及其核心价值:作为一款开源免费的大模型管理工具,它能将 DeepSeek 等开源模型部署到本地,支持 GPU/CPU 灵活调度、跨平台运行,并提供 API 与命令行接口,适合搭建私有知识库等场景。
让AI自己开发AI工具:7天31次提交的自举踩坑实录
一位工程师让AI自动开发AI工具,7天跑出31个commit,自举成功率仅六分之一。本文复盘五类典型踩坑、11条结构性规律及AI审AI机制,揭示自举飞轮如何把失败变成永久免疫。
从零打造AI代理电商:用多智能体构建按需印花业务实录
海外博主用AI编程工具从零构建按需印花电商公司Keepsake Threads的实战记录:如何配置专业化Agent、用GPT-5.6与Claude Fable多模型编排突破架构阻塞,并沉淀可复用技能。真实展示AI代理创业的方法论与局限。