大模型如何让形式化软件验证走向大规模落地

LLM 通过降低规格编写与证明工程的人力成本,使形式化验证走向规模化成为可能。
文章基于 Hacker News 的一则讨论,分析了大语言模型如何让形式化软件验证在更大规模上变得可行。核心判断是:形式化验证的规模化瓶颈不在证明器能力,而在稀缺专家的人力供给。LLM 的切入点是规格生成与形式化翻译、证明脚本的草拟与修复、不变式与前置条件的发现,把"从零构造"转变为"审查与修补"。但文章强调信任边界不可模糊:LLM 输出只是候选材料,最终结论必须由机器可检验的证明背书,"可行"指向成本可行性而非正确性保证的放宽。更深远的影响可能是形式化验证从项目级大审查转向持续验证。
大模型如何让形式化软件验证走向大规模落地
形式化验证长期被视为软件工程的"贵族工具"——它能用数学方法证明程序不存在某类错误,却因门槛高、成本大而难以规模化。Hacker News 上的一则讨论抛出了一个值得认真对待的判断:大型语言模型正在让形式化软件验证在更大规模上变得可行。这并非说 LLM 会取代定理证明器,而是它可能改变整个流程的成本结构。
形式化验证的规模化瓶颈何在
形式化验证的核心思路是:先把程序或系统的行为用逻辑规格(specification)精确描述,再让定理证明器或模型检验器去证明实现满足规格。它的价值没跑了——在编译器、操作系统内核、密码协议、航空航天控制等场景中,一个隐蔽的整数溢出或状态机漏洞可能造成灾难性后果。
问题在于流程中的每一环都昂贵:写规格需要既懂领域又懂逻辑的专家,证明过程往往需要大量人工引导(proof engineering),维护证明的成本随代码演进而持续累积。学术界多年来的经验是,验证一个小规模核心模块的投入,可能远超编写该模块本身。
这构成了规模化的根本瓶颈:不是证明器不够强,而是人力供给跟不上。而 LLM 恰好是一种能大规模供给"理解与生成"能力的工具,两者相遇的位置正是这条瓶颈。
定理证明器与模型检验器的区别:文中提到的两类工具走的是不同技术路线。定理证明器(如 Coq、Isabelle、Lean)基于演绎推理,需要人工引导证明步骤,能处理无限状态空间,但自动化程度低、学习曲线陡峭。模型检验器(如 SPIN、NuSMV)则通过穷举有限状态空间来验证性质,全自动但面临状态爆炸问题,通常适用于协议和硬件设计。二者的成本结构不同:定理证明器的主要成本在人力,模型检验器的主要成本在算力与状态空间建模。LLM 对前者的增益更明显,因为其瓶颈正是"理解与生成"。
LLM 切入验证流程的几个位置
从讨论所指向的方向看,LLM 对形式化验证的增益不是单点的,而是分布在流程的多个环节。
规格生成与形式化翻译
最直接的切入点是自然语言到形式化规格的转换。工程师用自然语言写下意图,LLM 将其翻译成 Coq、Isabelle、Lean 或 TLA+ 风格的规格草案。这一步过去几乎完全依赖稀缺专家,现在可以先由模型产出可讨论的初稿,再由人审查修正。
Coq、Isabelle、Lean 与 TLA+ 的定位差异:这几个工具虽同属形式化方法生态,但适用场景不同。Coq 和 Isabelle 是交互式定理证明器,基于依赖类型论或高阶逻辑,适合验证算法、编译器、操作系统内核等复杂系统,学习门槛极高。Lean 是较新的定理证明器,因数学库 mathlib 的快速发展而在数学形式化领域崛起。TLA+ 则是 Lamport 提出的时序逻辑规格语言,配套模型检验器 TLC,专用于并发与分布式协议的建模验证,语法相对轻量、工业界接受度较高(AWS 曾大规模使用)。LLM 在不同工具上的表现差异显著:TLA+ 因语法简洁、训练语料中示例丰富,模型生成的规格草案质量通常高于 Coq/Isabelle 这类重型证明助手。
证明脚本的草拟与修复
证明工程是另一个重灾区。LLM 可以根据当前证明状态建议下一步策略(tactic),或在证明失败时分析错误信息并尝试修补。虽然模型给出的证明片段不能直接信任,但把"从零构造证明"变成"审查与修补证明",已经显著降低了认知负担。
Tactic 与 Proof Engineering 的含义:在交互式定理证明中,tactic 是指令式的证明构造命令,如 induction n、simpl、auto,证明脚本本质上是一串 tactic 的组合。Proof engineering 指的是为让证明通过而进行的大量人工调试工作——调整引理顺序、补充辅助引理、修改归纳假设等,这部分工作量往往远超预期。LLM 在此环节的价值在于它熟悉常见 tactic 模式,能根据当前证明状态(goal stack)建议下一步,或在失败时识别类型不匹配、缺少前提等问题。但需注意,证明脚本对上下文极度敏感,模型建议的 tactic 可能因隐式参数或局部假设差异而失败,因此"草拟—验证—修复"的循环仍需人工主导。
不变式与前置条件的发现
循环不变式、前置条件、后置条件这类隐含假设,是验证中最难被发现的部分。LLM 通过阅读代码上下文提出候选不变式,能帮助工程师更快地锁定需要形式化的关键性质。
循环不变式为何难以自动发现:循环不变式是在循环每次迭代前后都成立的性质断言,是程序验证(如 Hoare 逻辑)中的核心难点。它必须足够强以蕴含循环退出后的目标性质,又必须足够弱以在循环体执行后仍被维持,这种"恰到好处"的平衡在数学上不存在通用构造算法——事实上不变式生成在理论上不可判定。传统方法依赖专家洞察或抽象解释等近似技术,常常只能得到保守但无用的结果。LLM 的优势在于它能从代码语义和常见编程模式中"猜测"有意义的候选不变式,把搜索空间从无限缩小到有限几个可讨论的选项,再由证明器逐一检验。这与传统静态分析形成互补:后者保证可靠性但可能遗漏,前者提供广度但需验证。
关键限制:信任边界不能模糊
这里必须保持清醒。LLM 生成的内容是候选材料,不是证据。形式化验证的全部意义在于最终由机器可检验的证明来背书,如果流程中混入了未经检验的模型输出并当作已证事实,整个验证体系的可信度就会崩塌。
合理的工程实践应当是:LLM 负责提出,证明器负责裁决,人类负责界定问题边界。三者职责不可混淆。任何把"模型说没问题"当作验证结论的做法,都是对形式化方法的误用。
这也是为什么讨论中"可行"一词的落点值得注意——它指向的是成本可行性,而非正确性保证的放宽。
对工程实践的潜在影响
如果上述路径成立,最直接的变化可能发生在这类场景:安全关键系统的核心模块、密码学实现的常数时间性质、并发协议的状态机正确性、编译器优化的语义保持。这些领域的共同点是规格相对稳定、错误代价极高,恰好是形式化验证收益最大的地方,也是过去因成本被挡在门外的地方。
另一个可能的变化是验证的"日常化"。当写规格和草拟证明的边际成本下降,团队或许会把轻量级形式化检查纳入常规开发流程,而不是只在项目末期做一次昂贵的大审查。这种从"项目级验证"到"持续验证"的迁移,可能比单次验证规模的扩大更具结构性意义。
仍需回答的问题
讨论本身篇幅有限,留下不少开放问题:LLM 在多大程度上能处理大型代码库的跨模块依赖?对证明失败原因的归因是否足够可靠?生成的规格草案在语义偏差上的错误率如何?这些都需要实证数据而非直觉判断。
可以确定的是,形式化验证的门槛正在被重新定价。当稀缺专家的时间从"写"转向"审",整个领域的规模上限就发生了移动。对工程团队而言,现在值得做的是小范围试点:选一个规格清晰、错误代价高的模块,让模型参与规格与证明草拟,记录人工审查的实际节省量。数据会比观点更有说服力。
相关推荐
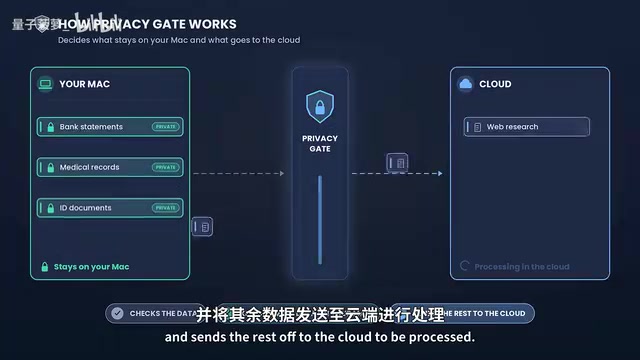
Perplexity混合计算实测:隐私数据不出Mac
Perplexity Hybrid Compute 实测:PrivacyGate 如何拦截敏感数据、本地模型与云端模型如何分工、16GB 与 32GB Mac 的模型差异,以及银行流水、医疗记录等真实场景下的隐私保护表现。
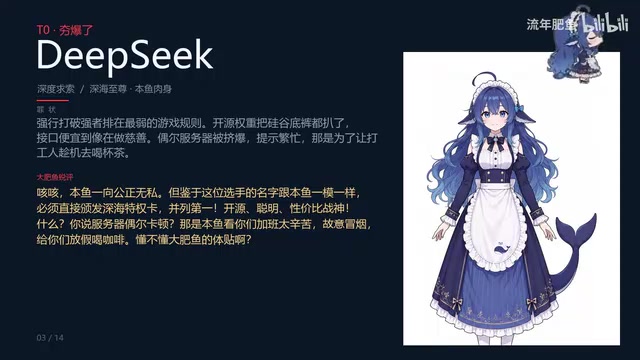
大肥鱼锐评国内外主流大模型:豆包登顶、DeepSeek并列第一
B站UP主大肥鱼锐评国内外主流大模型:豆包凭情绪价值登顶,DeepSeek以开源性价比并列第一,文心、海螺、元宝、Kimi、Qwen、可灵、Claude、Gemini、Grok各被贴上鲜明人设标签。本文梳理这份「最不客观」榜单背后的产品逻辑与选型启示。
AI Agent上生产前如何真测?一套可落地的测试与监控框架
BotGage创始人Pramin Pradeep分享AI Agent上生产前的测试方法:Agent注册可见性、红队测试、生产环境可观测性三步框架,附QA成本从18万美元降至8万美元的真实案例,以及IT角色向Agent监督者转型的分析。