大模型应用开发面试突击:LLM、RAG与Agent高频考点

大模型应用开发面试已转向原理理解与工程落地,需按知识树系统准备。
文章梳理了大模型应用开发面试的考察体系:面试重点已从“会调 API”转向理解原理与工程落地。考察范围覆盖 LLM 基础(Transformer、tokenizer、推理参数、KV Cache)、Prompt 与上下文工程、RAG 完整链路(切分、embedding、混合检索、重排序、效果评估)、Agent 与工具调用(死循环防范、无效调用控制、记忆设计),以及 AI 编程流程与架构设计。文章强调候选人需具备后端工程功底,建议按“LLM 基础→Prompt→RAG→Agent→工程化”的顺序建立知识树,每个环节准备可讲述的项目案例,用取舍与踩坑经历代替概念背诵。
为什么大模型应用开发面试需要系统准备
大模型应用开发岗位的面试正在从“会调API”转向“懂原理、能落地、有工程思维”。一份流传于B站的技术面试突击资料显示,当前考察范围已覆盖LLM基础、Prompt工程、RAG、Agent、工具调用以及工程化项目追问。内容同时涉及Java后端高频题与AI编程实践,反映出企业更看重候选人将大模型能力嵌入现有系统的综合素养。
LLM基础:面试的第一道门槛
大模型基础部分通常考察Transformer结构、注意力机制、tokenizer原理、上下文窗口限制以及推理参数(如temperature、top_p)的影响。面试官希望候选人理解模型“为什么这样输出”,而不是只会调用接口。对KV Cache、位置编码、模型微调与蒸馏等概念的掌握,能体现对推理成本和部署约束的认知。
KV Cache 是 Transformer 推理阶段的关键优化机制。自回归生成时,每生成一个新 token 都要对之前所有 token 做注意力计算;若不缓存,计算量会随序列长度平方增长。KV Cache 将每层已计算的 Key 和 Value 张量保存下来,后续步骤直接复用,把复杂度降为线性。代价是显存占用随上下文长度和批大小线性上升,因此长上下文、大并发场景下 KV Cache 往往是显存瓶颈,催生了 PagedAttention、MQA/GQA 等压缩与调度技术。面试中能讲清“用显存换计算”的取舍,通常比背定义更受认可。
位置编码 解决的是自注意力本身对顺序不敏感的问题。早期用正弦位置编码和可学习绝对位置编码,现代大模型多采用 RoPE(旋转位置编码),通过旋转向量注入相对位置信息,并支持一定程度的长度外推。位置编码直接决定了模型能多好地处理长文本,也是理解上下文窗口限制为何存在的重要背景。
Prompt工程:从技巧到方法论
Prompt部分已不止于“写个好提示词”。资料中提到的Context Engineering表明,面试官关注如何系统化设计上下文,包括指令分层、少样本示例选择、输出格式约束以及工具描述的编写。ToolsRegParameter(工具注册与参数设计)也是高频追问点:如何让模型稳定地选择正确工具并传入合法参数,直接关系到Agent的可靠性。
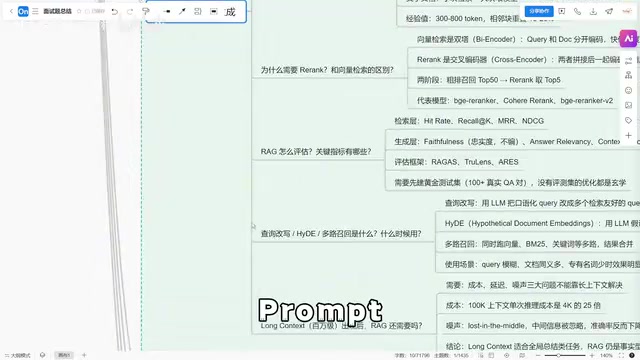
Context Engineering(上下文工程) 是对 Prompt Engineering 的进一步抽象:不再只优化一句提示词,而是系统设计进入模型上下文窗口的全部信息,包括系统指令、历史对话、检索到的文档、工具定义、示例和输出约束。核心问题是在有限的 token 预算内做优先级分配与截断策略,并保证各部分信息互不冲突。它与 RAG、Agent 的记忆管理紧密相关,因为上下文窗口既是资源也是约束。面试中能说明“哪些信息必须进上下文、哪些应外置检索、冲突时如何取舍”,体现出比调提示词更成熟的工程视角。
RAG:检索增强生成的核心链路
RAG是应用开发面试的重头戏。典型问题包括文档切分策略、embedding模型选型、向量检索与关键词检索的混合、召回率与准确率的权衡、重排序(rerank)的必要性,以及如何评估RAG效果。工程化追问常涉及知识库更新、权限过滤和引用溯源。候选人需要说清楚每个环节的取舍,而非堆砌组件名词。
重排序(Rerank) 位于召回之后、生成之前。向量检索追求高召回但精度有限,常一次性取回几十条候选;重排序模型(如 Cross-Encoder 架构)对“查询—文档”对做更精细的相关性打分,再截取 Top-K 送入大模型。它能显著提升送入上下文的文档质量,代价是额外的推理延迟和成本。实际链路通常是“向量召回 + 关键词召回 → 融合 → 重排序 → 截断”,是否引入重排序取决于对准确率和延迟的权衡,这也是面试官常追问的取舍点。
混合检索 指同时使用稠密向量检索与稀疏关键词检索(如 BM25)。前者擅长语义相似,后者对专有名词、编号、精确术语更敏感,二者融合能缓解单一方式的盲区,常见做法是分数归一化后加权或使用 RRF(倒数排名融合)。
Agent与工具调用:避免死循环与无效调用
Agent部分是区分度最高的环节。资料明确提出两个实战问题:如何避免Agent的死循环和无效调用,以及Agent的记忆如何设计。前者需要超时控制、最大步数限制、状态检测和失败重试策略;后者涉及短期对话记忆、长期记忆存储与检索、记忆压缩。工具调用方面,函数描述的清晰度、参数校验和错误反馈机制,都是面试官检验工程经验的切入点。
Agent 的短期记忆与长期记忆 需要区分设计。短期记忆是当前任务内的对话与中间步骤,通常直接放入上下文窗口,受 token 限制,需要滚动截断或摘要压缩;长期记忆则持久化到外部存储(向量库、数据库、知识图谱),按相关性检索后注入。记忆压缩的常见手段包括摘要历史、抽取结构化事实、丢弃低价值轮次。设计时要考虑写入时机、检索召回质量与隐私边界,否则记忆反而会引入噪声、误导后续决策。
工程化项目追问:AI编程与架构设计
面试官会追问团队使用的AI编程流程与最佳实践,例如代码生成后的人工评审、测试覆盖和安全边界。AI应用的架构设计则涉及模型服务编排、降级熔断、成本控制与可观测性。资料中并列的Java高频题(JVM、并发、Spring、MySQL、Redis、分布式与中间件)说明,大模型应用开发并非脱离后端工程独立存在,候选人仍需具备扎实的系统设计能力。
准备策略:先理解再记忆
这份资料的建议是“先讲一遍,再拿脑图记一遍”,配合简历优化形成闭环。对候选人而言,更有效的路径是按“LLM基础→Prompt与上下文→RAG→Agent与工具调用→工程化”的顺序建立知识树,每个环节准备一个可讲述的项目案例。面试中能说清取舍与踩坑经历,比背诵概念更有说服力。
常见追问与回答思路
- Agent死循环怎么防? 从步数上限、循环检测、人工兜底三层回答。
- RAG召回不准怎么办? 先定位是切分、embedding还是查询改写的问题,再谈混合检索与重排序。
- AI编程如何保证质量? 强调评审流程、测试先行和敏感代码的人工确认。
- 上下文超长怎么处理? 谈压缩、摘要、分段检索与优先级保留。
相关推荐
5.3英寸手机众筹:小屏复兴还是599美元的无奈?
Enough Phone 在 Kickstarter 众筹,5.3 英寸小屏搭配 8GB 内存和 5000 万像素传感器,定价 599 美元。The Vergecast 讨论小屏手机能否在旗舰大屏与功能机之间找到中间地带,以及廉价手机为何越来越难做。
Asahi Linux弃用MIT转GPL:一场针对Omarchy的闹剧?
Asahi Linux将代码许可证从MIT改为GPL V2,指控Omarchy窃取代码并商业化。分析认为此举理由牵强且违反MIT协议,暴露开源社区政治分歧与AI争议。
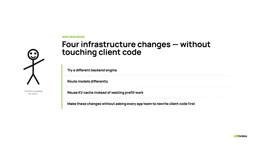
5分钟读懂NVIDIA Dynamo前端:兼容OpenAI的推理架构入口
NVIDIA Dynamo前端是什么?本文基于官方5分钟系列视频,解析它如何以OpenAI兼容API作为稳定边界,实现后端引擎替换、路由与KV缓存复用的解耦架构。