大一新生先装Codex与Claude Code?AI技能入门指南

大一新生应早装Codex与Claude Code,并按三层技术栈规划Agent开发之路。
文章面向大一新生,建议尽早安装Codex和Claude Code,不只用于写代码,而是作为应对比赛、论文、项目和科研的通用AI助手。文章指出大学四件事都可用AI提效,计算机专业尤其需要自学AI工具。针对双非本科生,作者从三个维度拆解Agent开发路径:学历上门槛比算法岗友好、高校课程滞后使起跑线相近;技术栈分三层,即Python/异步/FastAPI/大模型基础与Prompt工程、RAG全链路与记忆规划、向量数据库与本地部署量化;项目上强调绑定真实业务场景、跑通检索生成溯源闭环。企业更看重落地能力,不要求训练大模型或刷算法题,扎实项目是双非破局点。
刚开学的大一新生,电脑里除了必备软件,还有什么值得提前装好?B站有UP主提出:先把Codex和Claude Code装上。这并非只为写代码——在AI渗透校园的当下,它们可能成为你应对比赛、论文、项目、科研的通用助手。
一、为什么是Codex和Claude Code?
UP主指出,大学四年绕不开四件事:打比赛、写论文、做项目、搞科研。而这四样,AI都能帮上忙。
- 打比赛:数模竞赛被部分人称为“水赛”,去年就有人用AI轻松拿下国奖;电赛也因Codex这类agent的普及而逐渐被渗透;大创的商业计划书、PPT更是AI力所能及。
- 写论文:AI查重越来越严,但AI辅助写作的渗透程度已经相当高。
- 做项目:学校课程要求学生开发产品,AI编程能力的重要性大家都看得到。
- 科研:课题研究中的文献梳理、代码实现,AI也能显著提效。
计算机专业的同学尤其需要提前掌握AI技能——学校教数据结构、操作系统,却没人教你怎么用AI干活。这堂课得自己补上。
Codex 最初是 OpenAI 推出的代码生成模型系列,后来演化为能在终端或 IDE 中自主执行任务的编码 agent;Claude Code 则是 Anthropic 推出的命令行 AI 编程助手,可以读写文件、运行命令、调试项目。两者都属于“agent 型”工具:不只是补全代码,而是能理解目标、拆解步骤、调用工具并迭代执行。这正是它们能延伸到比赛、论文、项目、科研等场景的原因——本质上是在替你操作电脑完成任务,而非单纯问答。
二、双非本科如何入局Agent开发?
UP主从学历、技术栈、项目三个维度拆解了Agent开发这条路。
学历:门槛比算法岗友好
Agent开发方向太新,很多高校压根没开对应课程。即使你是人工智能专业,学的也还是机器学习那一套。
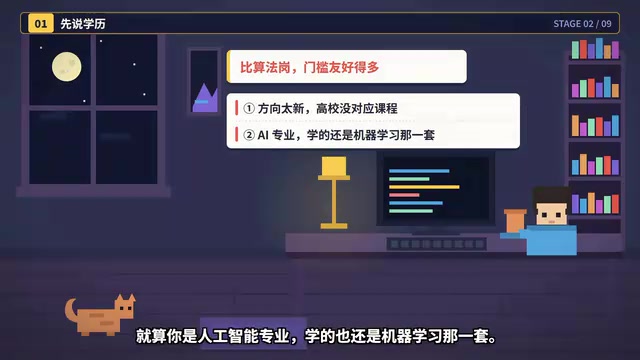
所以大家起跑线差不太多,双非同学不必先给自己设限。UP主整理了一份大模型+Agent的系统学习路线和配套教程,供有需要的人领取。
技术栈:三层能力,一层比一层关键
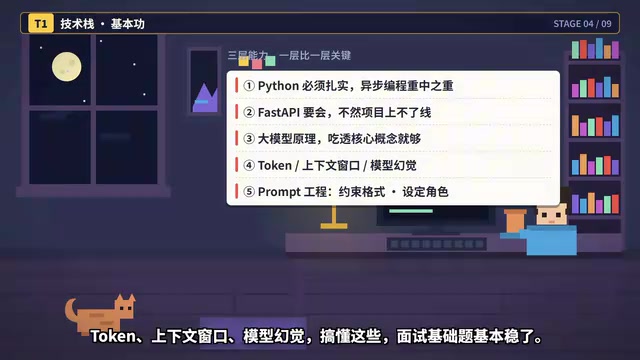
第一层:基本功
- Python必须扎实,异步编程是重中之重。
- FastAPI这类接口框架要会,否则项目只能本地跑,上不了线。
- 大模型原理不用啃到论文级别,吃透Token、上下文窗口、模型幻觉等核心概念就够了,面试基础题基本稳。
- Prompt工程要多练,约束格式、设定角色都是项目刚需。
第二层:求职核心硬技能
RAG(检索增强生成)整条链路一定要亲手搭一遍:文档解析、文本切片、向量化、检索、回答生成,从头到尾跑通。熟练调模型、调工具、查接口都得门儿清。再进阶一点,记忆机制和任务规划也要懂,复杂任务怎么拆解执行是加分项。
第三层:工程落地能力
向量数据库至少精通一款,能用起来才行。会部署本地模型、了解量化知识最好。UP主划重点:绝大多数Agent岗位不要求你训练大模型,也不用疯狂刷算法题。
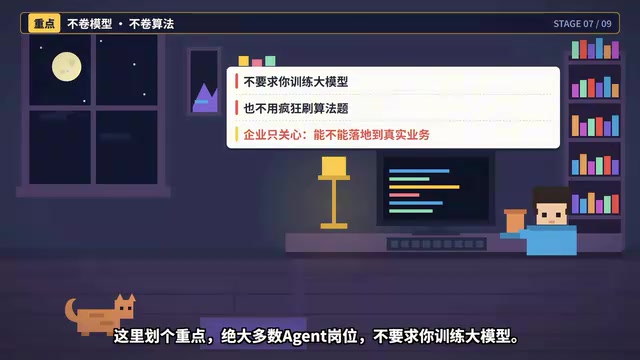
企业只关心一件事:你能不能把大模型能力落地到真实业务里。
三、项目:双非学历的破局点
双非学历很难第一眼抓住面试官,但扎实的项目可以。UP主提醒,千万别只停留在跟着教程跑demo,一问细节就卡壳。
高质量项目一定要绑定真实业务场景——教育、法律、电商都行。拿真实数据完整落地检索、生成、引用、溯源全链路闭环。一个吃透了的项目,能讲清痛点和优化点,远胜三个复制粘贴的demo。
四、总结
做Agent开发,学历当然有影响,但过硬的技术加上落地的项目,权重高得多。对于大一新生来说,尽早装好Codex、Claude Code这类工具,把AI变成日常干活的伙伴,同时按三层技术栈规划学习路径,积累真实项目经验,可能是比单纯刷绩点更关键的起手式。
背景补充
RAG(Retrieval-Augmented Generation,检索增强生成)指在模型生成回答前,先从外部知识库检索相关片段,再把片段作为上下文交给模型生成。它解决的是大模型知识过期、易幻觉、无法访问私有数据的问题。典型链路包括:文档解析(PDF/网页等转文本)、文本切片(按语义或长度切块)、向量化(用 embedding 模型把切片转成向量)、存入向量数据库、按用户问题检索 Top-K 片段、拼入 Prompt 后生成回答,并可附引用溯源。企业落地知识库问答、客服、文档助手几乎都绕不开这条链路。
Agent 中的“记忆机制”指让模型在多轮任务中保留并复用历史信息,常见做法包括短期对话缓冲、长期向量记忆以及摘要压缩;“任务规划”则指把复杂目标拆成可执行的子任务并安排顺序,常见范式有 ReAct(推理与行动交替)、Plan-and-Execute(先规划再执行)以及工具调用编排。这两项能力决定了 agent 能否处理多步骤、跨工具的复杂任务,也是面试中区分“会调 API”和“会做系统”的关键分水岭。
向量数据库是专门存储和检索高维向量的数据库,常见有 Milvus、Qdrant、Weaviate、pgvector 等,核心能力是近似最近邻(ANN)检索,用余弦相似度等度量快速找到与问题最相关的文本片段。本地模型部署与量化则指用 Ollama、vLLM、llama.cpp 等工具在本地或私有服务器运行开源模型,并通过 INT8/INT4 等量化手段压缩显存占用、提升推理速度。掌握这些,才能把 demo 变成可上线、成本可控的真实系统。
相关推荐

AI能直接读懂神经网络权重:模型能力已超出预期?
Reddit开发者实验显示,语言模型能直接阅读神经网络权重并推断其功能。Astra、Opus 5.5和Muse Spark 1.3均通过测试,引发对模型泛化能力与训练来源的讨论。

印度微短剧市场爆发:EloElo获NBCUniversal 8000万美元投资
印度社交娱乐平台EloElo获NBCUniversal 8000万美元投资,加码微短剧平台StoryTV。StoryTV月活超3300万,印度微短剧市场正吸引全球资本关注。

多旋翼无人机声学检测:融合手工特征与预训练嵌入
研究揭示无人机声学检测中随机划分导致数据泄漏,提出源不相交评估协议下融合手工声学特征与YAMNet嵌入的堆叠集成方法,准确率达95.29%,为低成本无人机探测提供可靠基准。