单张产品图批量生成广告素材:规模化工作流的现实瓶颈与解法
从一张产品图到全套广告素材:理想工作流长什么样
在电商和数字营销领域,一个越来越普遍的诉求正在浮现:能否从一张真实的产品照片出发,自动化地批量生成一整套广告创意?这不仅仅是生成几张图片,而是一条完整的流水线——从多场景布局、多平台尺寸适配,一直延伸到带有字幕、配音、音乐和行动号召(CTA)的短视频。
AIGC技术的营销应用浪潮
AIGC(AI Generated Content,人工智能生成内容)是指利用人工智能技术自动生成文本、图像、视频、音频等多种形式内容的技术。2022年以来,以Stable Diffusion、Midjourney为代表的图像生成模型,以及ChatGPT等大语言模型的爆发,使AIGC从实验室走向商业应用。在营销领域,AIGC的价值在于能够大幅降低内容生产成本,将原本需要设计师数天完成的素材制作压缩到分钟级。然而,从「能生成」到「能规模化生产可用素材」之间,仍存在巨大鸿沟——这正是本文要探讨的核心问题。
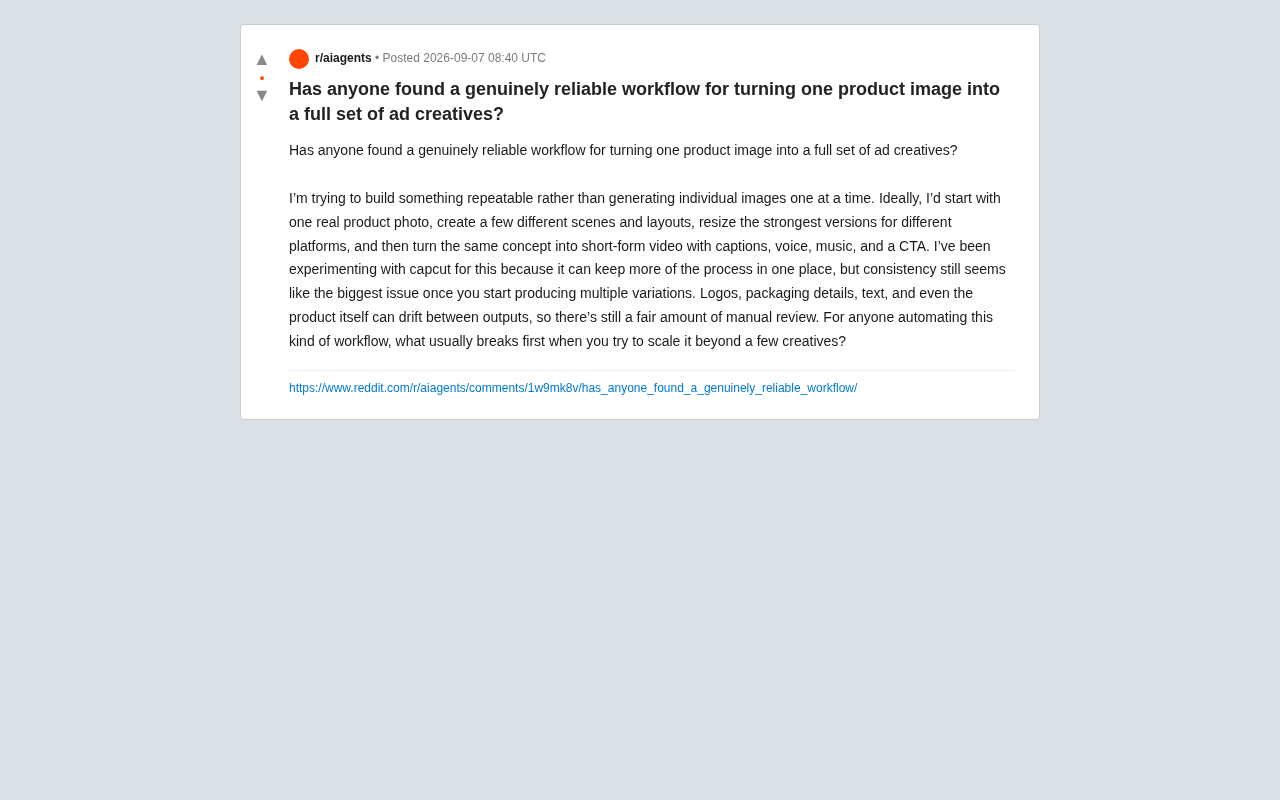
近期一位 Reddit 用户提出的问题,精准地击中了当下 AIGC 营销工作流的核心痛点。他描述的理想流程是这样的:
- 以一张真实产品照为起点
- 生成多个不同的场景和排版
- 将最优版本适配到不同平台的尺寸
- 把同一概念转化为短视频,配上字幕、配音、音乐和 CTA
CTA(Call to Action,行动号召)是广告素材中引导用户执行特定操作的元素,如"立即购买""了解更多""限时优惠"等按钮或文案。CTA的效果不仅取决于文案本身,还与出现时机、视觉层级和心理暗示密切相关。在短视频广告中,CTA通常出现在视频的最后2-3秒或情绪高潮点之后,过早出现会让用户感到突兀而划走,过晚则可能被跳过。CTA的颜色、大小、动画方式也需要与整体品牌风格一致。在自动化工作流中,CTA的智能插入涉及对视频叙事结构的理解,这超出了当前大多数自动化工具的能力范围。
这个诉求的关键词是可重复(repeatable),而非一次性地逐张生成图片。换句话说,他要的不是一个创意工具,而是一条能够规模化运转的广告素材生产线。
品牌一致性:规模化生产时最先崩溃的环节
这位用户尝试用 CapCut 来完成大部分工作,因为它能把剪辑、字幕、配音等环节集中在一个平台内。CapCut(剪映国际版)是字节跳动旗下的视频编辑应用,于2020年推出。它将视频剪辑、字幕生成、配音、特效和音乐等功能整合在一个移动端和桌面端平台内,特别针对短视频创作者和社交媒体营销需求。2023年后,CapCut大量引入AI功能,包括AI文案生成、智能抠图、语音克隆等。用户选择它的原因在于「一站式」——不需要在Premiere、After Effects、剪映之间来回切换和导出。
然而他发现,当开始批量生产多个变体时,一致性成了最大的障碍。这种集成式工具在批量化、模板化的营销素材生产场景下,往往缺乏足够的自动化控制能力和批处理接口,难以满足「可重复工作流」的需求。
品牌元素的"漂移"问题
他指出了一个非常典型的现象:Logo、包装细节、文字,甚至产品本身,都会在不同的输出之间发生"漂移"(drift)。这意味着 AI 在生成每一个新变体时,无法完美复刻上一版的品牌资产。
图生图技术的根本局限
这背后的技术原因值得深入分析。图生图(Image-to-Image)是扩散模型(Diffusion Model)的一种应用模式。其工作原理是:先将输入图像加入一定程度的噪声,再引导模型按照文本提示词(prompt)进行去噪重建。这个过程并非简单的滤镜或风格迁移,而是在潜在空间(latent space)中对图像进行重新解释和生成。
扩散模型的核心思想源自非平衡热力学:先通过前向过程逐步向数据添加高斯噪声直至变为纯噪声,再训练神经网络学习逆向过程——从噪声中逐步恢复出有意义的图像。Stable Diffusion等模型在此基础上引入了潜在空间(Latent Space)的概念,即不直接在像素空间操作,而是先通过变分自编码器(VAE)将图像压缩到低维的潜在表示中进行去噪,最后再解码回像素空间。这种设计大幅降低了计算成本,但也意味着细节信息在编码-解码过程中会产生不可避免的损失,这正是品牌资产在图生图过程中发生"漂移"的底层技术原因之一。
当前主流的图像生成模型本质上是基于概率分布的重建。当前主流的AI图像生成技术基于扩散模型(Diffusion Models),其核心是通过逐步去噪的方式生成图像。这个过程本质上是概率采样:模型学习了海量图像的统计分布,然后在这个分布空间中「抽样」出新图像。即使给定相同的输入图和提示词,每次生成的结果也会存在随机性(除非固定随机种子seed)。
值得注意的是,固定随机种子在实际批量生产中的作用十分有限。在扩散模型中,生成过程从一个随机噪声张量开始,这个初始噪声由伪随机数生成器的种子值决定。固定seed意味着每次生成都从相同的初始噪声出发,理论上能产生相同的结果。然而,一旦改变提示词、图像尺寸、采样步数、CFG引导强度中的任何一个参数,输出就会发生显著变化。更重要的是,不同的推理框架、GPU型号甚至浮点精度差异都可能导致结果不一致,这使得跨设备、跨平台的可复现性成为工程层面的额外挑战。
更关键的是,即便使用了图生图或参考图(reference)机制,模型对细节的"记忆"依然是模糊的近似,而非像素级的精确复制。为了解决这一问题,研究者们开发了多种条件控制技术。ControlNet允许通过边缘图、深度图、人体姿态等辅助信号来约束生成结果的空间结构;IP-Adapter则通过图像提示(Image Prompt)来引导风格和内容的一致性。
从技术原理上看,ControlNet由张吕敏等人于2023年提出,通过在预训练扩散模型旁边附加一个可训练的编码器分支,接收边缘图(Canny)、深度图、语义分割图等空间条件信号,从而精确控制生成图像的结构布局。IP-Adapter则由腾讯AI Lab提出,它通过一个轻量级的适配模块将参考图像的CLIP视觉特征注入到交叉注意力层中,实现风格和内容层面的引导。两者可以组合使用——ControlNet控制空间结构,IP-Adapter控制风格一致性——但叠加多个控制条件时,它们之间可能产生冲突,需要仔细调整各自的权重系数。
然而,这些技术本质上是在概率采样过程中增加软约束,而非硬性锁定像素级细节。这意味着它们能提高品牌元素的近似度,但无法保证100%的保真——在商业场景中,99%的相似度和100%之间的差距可能就是合规与违规的分界线。
模型对输入图像的「记忆」是语义级而非像素级的——它理解「这是一个红色的瓶子』,但不会精确记住瓶身标签上每个字母的字体、间距和颜色。这种特性在艺术创作中是优势,但在需要品牌资产精确复现的商业场景中就成了致命缺陷。
对于营销物料而言,这恰恰是致命的——一个略微变形的 Logo、一段被 AI "脑补"错误的包装文案,都可能让整套素材失去可用性。
手动审核为何无法避免
结果就是,即使自动化程度提高,团队仍然需要投入大量的人工审核去逐一检查这些漂移。这实际上抵消了自动化本应带来的效率提升。当你只生成三五张素材时,手动检查尚可承受;一旦要扩展到几十上百个变体,审核成本会呈线性甚至非线性增长。
AI批量生成广告素材时"最先崩溃"的四个关键点
这位用户抛出的核心问题是:当你试图把这类工作流扩展到几个创意之外时,通常最先出问题的是什么?结合社区讨论和实践经验,可以归纳出几个关键的失效点。
1. 品牌资产的保真度
这是最先、也是最普遍崩溃的环节。产品本体、Logo 和包装是不允许任何创造性发挥的"硬约束",但生成模型天生倾向于"再创作"。二者的根本矛盾,使得纯生成式方案在品牌保真度上始终存在天花板。
2. 文字渲染的可靠性
图像生成模型在渲染文字方面长期表现不稳定,尤其是较长的产品名称、规格参数或促销文案。AI图像生成模型在文字渲染上的困难,根源在于文字是一种高度结构化的视觉符号系统——每个字符的笔画、间距、连接方式都有严格约定,容不得半点偏差。而扩散模型的训练数据中,文字只是像素模式的一种,模型并不"理解"字母的拼写规则或汉字的笔画结构。2024年以来,一些新模型(如FLUX、Ideogram、DALL-E 3)通过引入字符级别的文本编码器和专门的文字渲染训练,在英文文字生成上取得了显著进步,但对于非拉丁字母系统(如中文、日文、阿拉伯文)的渲染质量仍然参差不齐。
文字扭曲、拼写错误、字符缺失是高频问题,而广告素材恰恰高度依赖清晰准确的文字信息。在商业广告场景中,当前的最佳实践依然是将文字作为独立图层在后期合成阶段叠加,而非依赖生成模型直接渲染。
3. 跨平台适配的构图逻辑
将一张素材从方形(1:1)改为竖版(9:16)或横版(16:9),并不是简单的裁剪。不同社交媒体和广告平台对素材尺寸有严格且差异化的要求:Instagram信息流偏好1:1方形或4:5竖版,TikTok和Reels要求9:16全屏竖版,YouTube前贴片广告通常为16:9横版,而Facebook广告则需要同时提供多种比例以适配不同展示位。
每个平台还定义了自己的"安全区"(Safe Zone)——即UI元素(如点赞按钮、用户名、进度条等)不会遮挡的区域。在TikTok上,底部约15-20%的区域被文案和互动按钮占据,顶部也有平台UI。如果自动适配时不考虑这些因素,产品主体或关键文案很可能被遮挡,导致素材在投放后实际效果大打折扣。不同平台的安全区、主体位置、留白比例都有讲究。单纯依赖自动缩放,往往会把主体裁掉或让排版失衡。
4. 视频环节的多模态同步
当流程延伸到短视频时,复杂度进一步叠加。多模态(Multimodal)指的是同时涉及文本、图像、音频、视频等多种信息形式的AI系统。在广告素材生成场景中,不仅要生成静态图像,还需要生成与之匹配的视频、配音、字幕和音乐。
字幕的时间轴、配音的节奏、背景音乐的情绪、CTA 的出现时机——这些多模态元素需要协调一致。这些元素之间存在复杂的时序依赖和语义对应关系:配音的语速要与字幕出现时机同步,背景音乐的情绪要与画面节奏一致,CTA按钮的出现要配合叙事高潮。
当前的AI工具大多是单模态优化的——图像生成模型不懂音频,语音合成模型不理解画面构图。2024年以来,Sora(OpenAI)、Runway Gen-3、Kling(快手)、Vidu(生数科技)等视频生成模型取得了显著进展,能够生成数秒到十几秒的高质量视频片段。然而在广告素材场景中,这些模型面临特殊挑战:产品在运动中的形态保持(如瓶身标签不应变形)、品牌色彩的帧间一致性、以及与预设脚本的精确对应。目前更实用的方案是图像动画化(Image Animation)——将AI生成的静态广告图通过Stable Video Diffusion等工具转化为带有微妙运动(如光影变化、背景粒子飘动)的短视频,既保留了品牌元素的确定性,又赋予了素材视频的动态吸引力。
跨模态的协调依然高度依赖人工设计和调试,这也是为什么任何一个环节的自动化失误都会破坏整体观感,使视频环节成为自动化工作流中最易崩溃的部分。
更务实的广告素材批量生成思路
虽然原帖并未给出完美答案(这本身也说明该领域尚无成熟的"银弹"方案),但从问题本身可以提炼出几条更具可行性的工作流思路。
分离"可变"与"不可变"元素
一个更稳健的做法是,把品牌资产(Logo、产品图、包装文字)作为不可变的固定图层,通过模板化的合成方式叠加,而不是交给生成模型重新绘制。生成模型只负责创造背景、场景和氛围这些"可变"部分。这样既保留了 AI 的创意能力,又锁死了品牌保真度。
模板驱动而非纯生成
真正可规模化的工作流,往往是模板 + 变量填充的模式,而非端到端的生成。预先设计好符合各平台规范的版式模板,再将 AI 生成的场景和固定的品牌素材填充进去,能够大幅减少漂移和审核成本。
模板驱动的批量素材生成并非新概念。在AIGC兴起之前,Canva、Crello(现为VistaCreate)等平台已经提供了"设计模板+变量替换"的批量生成方案。企业级工具如Celtra、Smartly.io和Hunch则进一步实现了动态创意优化(DCO, Dynamic Creative Optimization),能够根据受众标签、地理位置、时间段等变量自动组合不同的标题、图片、CTA和配色方案,生成成百上千个广告变体。
DCO的真正价值不仅在于素材生成,更在于与广告投放数据形成闭环。DCO系统能根据实时投放数据(如点击率CTR、转化率CVR、千次曝光成本CPM)自动淘汰表现差的变体、放大表现好的组合。Meta(Facebook)的Advantage+、Google的响应式展示广告(Responsive Display Ads)都内置了DCO能力。AIGC与DCO的结合意味着:AI不仅负责创意生成,还能根据投放效果反馈来调整生成策略——例如发现户外场景的产品图比室内场景点击率高30%,系统就自动增加户外场景变体的生成比例。这种"生成-投放-反馈-优化"的闭环,是规模化广告素材生产的终极目标。
AIGC的加入为这一范式注入了新的可能——AI可以生成模板中"可变部分"的创意素材(如场景背景、模特姿态等),而模板框架本身保证了品牌元素的确定性。这种"AI创意+模板约束"的混合模式,目前被认为是兼顾效率和质量的最佳实践。
建立自动化质检环节
对于文字准确性和 Logo 完整性,可以引入自动化质检手段。OCR(Optical Character Recognition,光学字符识别)是一种将图像中的文字转换为可编辑文本的技术。在AI生成的广告素材质检流程中,OCR可以自动提取图像中的文字内容,与预期文案进行比对,从而发现拼写错误、字符缺失或文字变形等问题。现代OCR系统(如Google Cloud Vision、Tesseract、PaddleOCR)已经能够处理多种字体、倾斜文字和复杂背景。
此外还可以使用图像比对等技术验证Logo完整性。例如,通过模板匹配(Template Matching)或特征点匹配(如SIFT、ORB算法)将生成图中的Logo区域与原始Logo进行相似度计算,当相似度低于阈值时自动标记为需要人工复审。一些企业还引入了品牌资产管理系统(Brand Asset Management),将Logo的标准色值、最小使用尺寸、保护区域等规范数字化,作为自动化质检的基准参考。
但OCR本身也有局限:对于艺术化字体、严重变形的文字或与背景融合的设计,识别准确率会大幅下降。虽然无法百分百替代人工,但能显著降低审核负担。OCR质检是降低审核负担的辅助手段,而非完全自动化的解决方案。
结语:AIGC广告素材自动化的边界在哪里
这个来自 Reddit 的真实提问,折射出当前 AIGC 营销工具的一个共性困境:创意生成很强,但确定性控制很弱。营销素材恰恰是一个对确定性要求极高的场景——品牌不容出错,文字不容含糊。
因此,短期内最可靠的工作流,很可能不是追求"一键全自动",而是在自动化与人工控制之间找到平衡:让 AI 负责它擅长的创意扩展,让模板和规则负责它不擅长的一致性保障。当你试图把创意工作流规模化时,最先崩溃的往往不是技术本身,而是那些看似微不足道却不容许犯错的品牌细节。
相关推荐

对抗AI代码腐化:规格、结果笔记与文件清单的实战方法
一位开发者用八个月、650次提交、4.3万行代码的实战,总结出防止AI智能体代码库腐化的方法:前置规格与验收标准、任务结果笔记、文件清单约束,以及用触发式钩子取代规则文件。核心洞察是——指令只是建议,机制才能在长会话中存活。

"Tokens Exhausted":一段机器人视频背后的AI焦虑
一段名为「Tokens Exhausted」的机器人视频在 Reddit 引发热议,网友已分不清它是否为波士顿动力真实作品。本文解析这段AI讽刺内容为何戳中神经,以及它折射出的合成媒体与LLM时代焦虑。

4千美元淘到全新DGX Spark:本地部署大模型的性价比之选
一位Reddit用户以4000美元在Craigslist淘到全新DGX Spark,用于本地托管AI模型。本文解析这笔交易背后的性价比、二手交易安全,以及本地部署大模型的兴起趋势。