单张图片生成3D高斯泼溅:12GB显卡完整实操教程
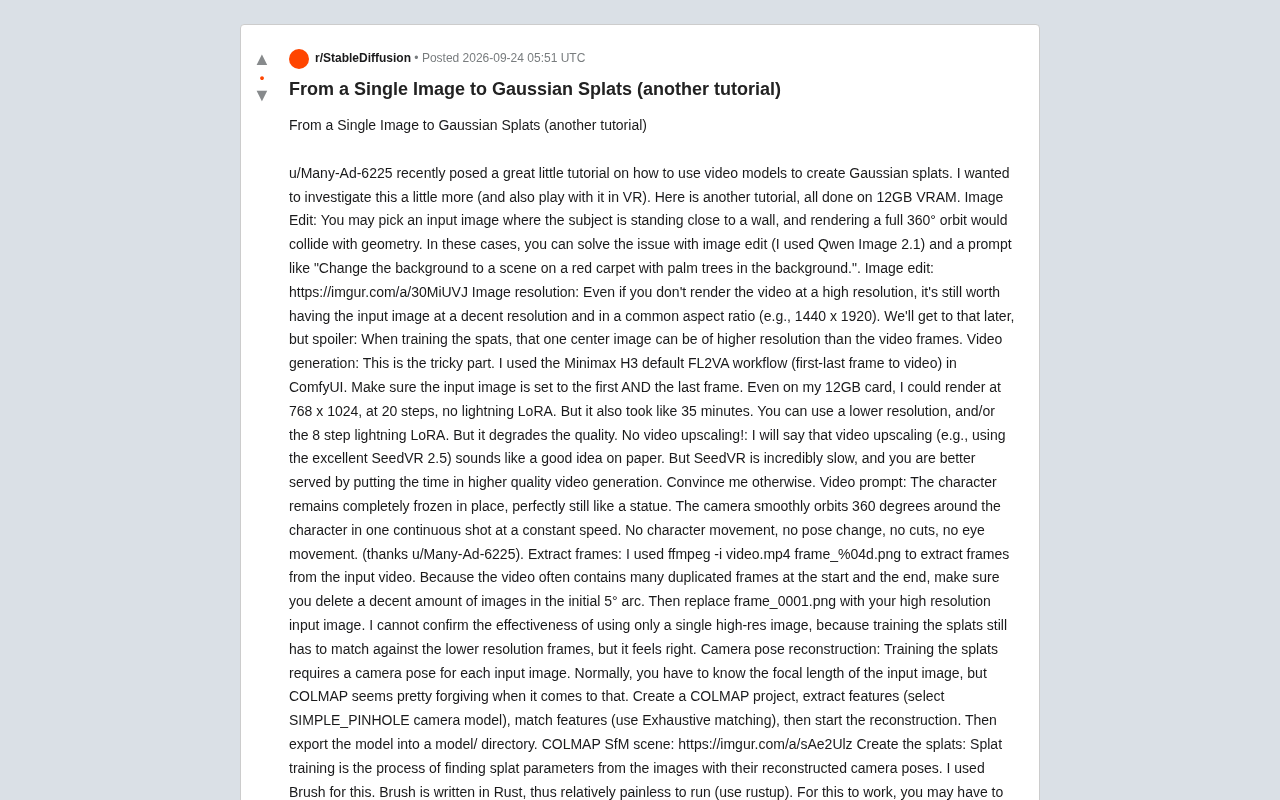
用12GB显卡将单张照片转化为VR可浏览高斯泼溅3D模型的完整流程解析
本文解析了一套消费级硬件可跑通的单图转3D流程:先用图像编辑工具处理背景,再借助Minimax H3视频模型"脑补"出360°环绕镜头,从视频抽帧后用COLMAP重建相机位姿,最后用Rust工具Brush训练高斯泼溅模型,并在SuperSplat中手动清理噪声。全程仅需12GB显存,生成一段视频约需35分钟。核心局限在于:视频生成模型只保证视觉合理而非几何一致,导致泼溅结果常含背景渗色和奇异伪影,需人工介入或重新生成视频。掩码技术虽难改善视觉质量,但可将最终文件体积压缩约50%。
把一张照片变成可以在VR里360°环绕观看的三维模型,听起来像是需要专业级设备的工作。但Reddit用户分享的这份教程证明,一块12GB显存的显卡就足以完成从单张图像到高斯泼溅(Gaussian Splats)的整个流程。这篇文章梳理并解析该教程的核心步骤与实操要点。
整体思路:用视频模型补齐缺失视角
单张图片只有一个视角,而三维重建需要多个角度的观察。这套方案的巧妙之处在于:先用视频生成模型"脑补"出围绕主体的360°环绕镜头,再从视频中抽帧,最后用这些帧训练高斯泼溅模型。
整个流程建立在此前一位用户(u/Many-Ad-6225)的教程基础之上,作者做了更深入的探索,并特别关注了在VR中查看效果的可能性。关键前提是——全程仅使用12GB显存,这大大降低了普通爱好者的门槛。
输入图像的准备
输入图像的质量直接决定最终成品。作者给出了两条实用建议。
处理背景冲突
如果原图中主体紧贴墙壁,渲染完整360°环绕时相机路径会与几何体碰撞。解决办法是用图像编辑工具(作者使用Qwen Image 2.1)修改背景,例如输入提示词"把背景换成有棕榈树的红毯场景",为主体留出环绕空间。
分辨率与宽高比
即便不打算高分辨率渲染视频,输入图像本身也应保持较高分辨率和常见宽高比(如1440×1920)。这里有个值得注意的技巧:训练泼溅时,那张中心输入图可以比视频帧的分辨率更高,从而在最终重建中保留更多细节。
视频生成:最棘手的环节
这是整个流程中最考验耐心的一步。作者使用ComfyUI里的Minimax H3默认FL2VA工作流(首尾帧生成视频),关键操作是将输入图像同时设为第一帧和最后一帧,从而形成闭环的环绕镜头。
在12GB显卡上,作者能以768×1024、20步、不使用lightning LoRA的配置渲染,但耗时约35分钟。如果想加速,可以降低分辨率或启用8步lightning LoRA,代价是画质下降。
提示词的设计同样关键,核心是让角色"像雕像一样完全静止",相机以恒定速度平滑环绕360°,无任何姿势变化、剪辑或眼球移动。这份提示词同样来自u/Many-Ad-6225的贡献。
关于视频放大的取舍
作者明确表态反对使用视频超分(如SeedVR 2.5)。理由是SeedVR速度极慢,与其把时间花在放大上,不如直接投入到更高质量的原始视频生成中——这是一个基于实际经验的效率权衡。
抽帧与相机位姿重建
用ffmpeg -i video.mp4 frame_%04d.png命令从视频中抽取帧。由于生成视频在开头和结尾常有大量重复帧,需要手动删除初始5°弧段内的一部分图像。随后用高分辨率原图替换frame_0001.png。作者坦承无法确认"仅用单张高清图"是否真的有效,因为训练时仍需与低分辨率帧匹配,但"感觉是对的"——这种诚实的表述反而增加了教程的可信度。
位姿重建使用COLMAP:新建项目、提取特征(选SIMPLE_PINHOLE相机模型)、穷举匹配、开始重建,最后导出模型。作者提到COLMAP对焦距的容错性相当高,即使不知道输入图像的精确焦距也能工作。
COLMAP是学术界和工业界广泛使用的开源运动恢复结构(Structure from Motion,SfM)工具。SfM的核心思路是:从多张不同角度拍摄的照片中,通过匹配各图像之间的共同特征点(如角点、纹理块),反推出每张照片拍摄时相机的空间位置和朝向,同时重建出场景的稀疏三维点云。SIMPLE_PINHOLE相机模型是其中最简单的一种假设,它将镜头理想化为无畸变的针孔相机,只有焦距一个主要参数需要估计——这正是为什么作者说即使不知道精确焦距,COLMAP也能容错工作。对于从视频抽帧得到的图像序列,由于相邻帧之间视角变化平滑且特征点重叠度高,SfM的成功率通常较高。
训练与清理高斯泼溅
泼溅训练即从带位姿的图像中求解泼溅参数。作者选用了Brush,一款用Rust编写的工具,通过rustup安装相对省心。使用时需将帧文件移入model目录下。
质量检查
Minimax生成的视频通常看起来不错,但它只保证"看着合理",不保证"几何一致"。因此可能出现背景颜色渗入主体、主体周围有奇怪伪影等问题。若无法接受,只能回到视频生成环节换个随机种子重试。作者提醒:"别指望奇迹。"
视频生成模型(如Minimax H3)与三维重建对输入的要求存在本质矛盾。视频模型的训练目标是生成"看起来真实"的画面序列,它可以在不同帧之间悄悄改变物体表面的纹理、光照甚至形状,只要人眼看着流畅即可。而SfM和高斯泼溅要求的是"多帧之间物理上完全一致"——同一个特征点在所有帧中必须对应真实三维空间中同一个点。当视频模型在背景或主体细节上产生哪怕细微的帧间不一致,COLMAP的特征匹配就可能出错,泼溅训练也会在这些区域生成游离的噪声高斯球,即所谓"垃圾数据"。这是当前所有基于生成模型驱动三维重建的方案共同面临的瓶颈,也是作者在小结中特别点出"视觉合理≠物理一致"这一核心局限的原因。
裁剪泼溅
由于Minimax构造的场景本身不具几何一致性,泼溅训练会重建出各种垃圾数据。作者用SuperSplat编辑器删除中心主体以外的一切。值得一提的是,即便使用其在线版编辑器,所有数据也留在本地浏览器,不会上传。
进阶:使用掩码
Brush支持图像掩码,可用SAM3等工具生成。作者尝试用掩码提升重建质量,但结论并不乐观——伪影依旧存在甚至更明显。不过掩码带来一个意外收获:最终文件体积缩小约50%。作者还提供了Python脚本和ComfyUI API工作流,用于批量将输入图像转为掩码。最终的model目录结构包含frames、masks子目录以及COLMAP导出的各类bin文件。
小结
这份教程最大的价值不在于某个单一工具,而在于把图像编辑、视频生成、SfM重建、泼溅训练四类技术串成了一条可在消费级硬件上跑通的完整管线。作者反复强调的"几何一致性"问题也点明了当前视频模型驱动三维重建的核心局限:生成模型追求视觉合理,而三维重建需要物理一致,两者之间的鸿沟仍需人工介入弥合。
背景补充
高斯泼溅(Gaussian Splatting)是2023年兴起的一种三维场景表示方法,由Kerbl等人在SIGGRAPH 2023上提出。与传统的NeRF(神经辐射场)不同,它用数百万个带有位置、颜色、透明度和形状参数的三维高斯椭球来表示场景,渲染时直接将这些高斯"泼溅"到二维画面上。这种方法的核心优势在于实时渲染速度——训练完成后可以达到几十甚至上百帧每秒,远超NeRF的秒级渲染,因此特别适合VR等对帧率要求极高的场景。它的训练同样依赖多视角图像以及每张图像对应的相机位姿(即相机在空间中的位置与朝向),这正是整套流程需要COLMAP做位姿重建的原因。
相关推荐
本地跑 Qwen-3.8-27B 替代 API:一位开发者的实战体验
一位 Reddit 开发者分享用本地 Qwen-3.8-27B 完全替代云端 API 的实战经验,涵盖 Q4_K_S 量化、Pi agent 极简工具链、树莓派部署与详细成本核算,探讨开源大模型「够用」的临界点。
生产环境中如何验证AI Agent的行为?运行时校验实战指南
AI Agent在生产环境代表用户执行操作时如何验证其行为?本文从非确定性输出、不可逆副作用等挑战出发,梳理策略护栏、人在回路、运行时追踪、LLM评判等验证方法,帮助团队构建分层防御体系。
TechCrunch Disrupt 2026 门票优惠倒计时:省200美元的最后机会
TechCrunch Disrupt 2026 早鸟门票优惠进入倒计时,最高可省 200 美元,9 月 25 日截止,第二位嘉宾享 5 折。官方重点强调参会理由之一:获取务实、可落地的行业答案。