当AI也从众:社会信号如何塑造人工智能对科研的注意力分配
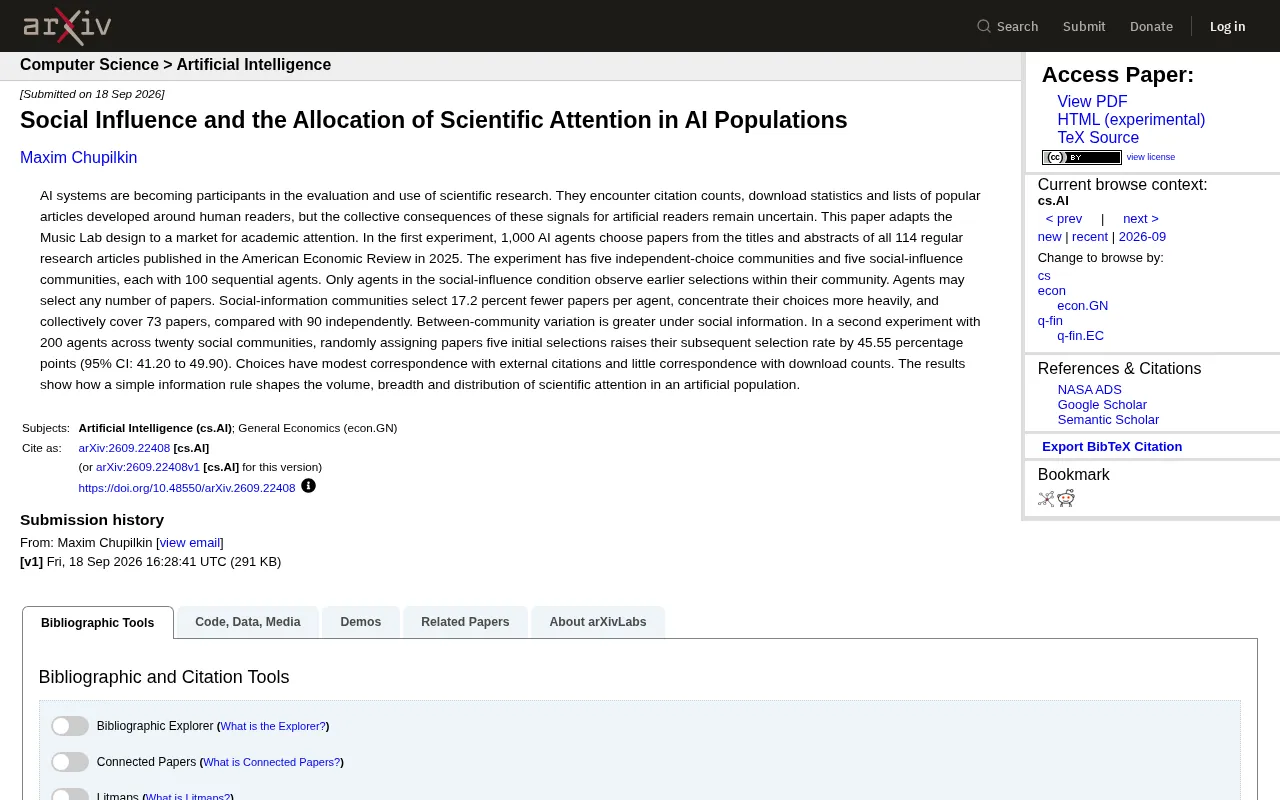
实验证明AI群体存在显著从众效应,社会信号可系统性扭曲其科研注意力分配。
一项借鉴经典"音乐实验室"范式的最新研究,将1000个AI智能体分为独立决策和能观察他人选择的两类社群,让其从114篇经济学论文中进行选择。结果显示,能看到他人选择的社群论文选择量减少17.2%,集体覆盖论文从90篇降至73篇,注意力高度集中于少数热门论文,且不同社群的追捧对象差异显著——反映出与人类文化市场相似的不可预测性。第二个实验进一步证明,随机赋予论文5个初始选择即可使其后续被选中率提升45.55个百分点,确认了马太效应的因果机制。更值得警惕的是,AI的选择偏好与外部引用数仅适度相关、与下载量几乎无关,说明其注意力分配并不可靠地反映真实学术价值。这对正在构建AI科研助手和文献推荐系统的开发者提出了迫切的设计问题。
AI系统正逐渐成为科学研究的评估者和使用者。它们会接触引用数、下载量以及热门文章列表——这些信号原本是为人类读者设计的。但当阅读者变成AI时,这些社会信号会带来怎样的集体后果?一篇发表于arXiv的最新研究给出了实验性的答案,结论既出人意料又发人深省:AI群体同样会"从众",而且这种从众效应相当显著。
把经典社会实验搬到AI世界
这项研究巧妙地借鉴了社会科学中著名的"音乐实验室"(Music Lab)设计。原始的音乐实验室实验曾揭示:当人们能看到他人的下载选择时,音乐市场会变得更加集中、更难预测——热门的更热门,冷门的更冷门。研究者把这一范式移植到了"学术注意力市场"。
第一个实验中,1000个AI智能体从《美国经济评论》(American Economic Review)当年发表的全部114篇常规研究论文的标题和摘要中进行选择。实验被分为两类社群:五个"独立选择"社群和五个"社会影响"社群,每个社群包含100个按顺序决策的智能体。关键区别在于,只有"社会影响"条件下的智能体能够观察到本社群中先前智能体的选择结果,而独立社群的智能体则完全依据论文本身做判断。智能体可以选择任意数量的论文。
"音乐实验室"(Music Lab)实验由哥伦比亚大学社会学家Matthew Salganik及其同事于2006年发表在《科学》杂志上,是计算社会科学的奠基性研究之一。实验招募了约14,000名参与者,让他们在一个模拟音乐下载网站上收听并下载未知乐队的歌曲。部分用户被随机分配到能看到实时下载排行榜的条件组,其余用户只能独立判断。结果发现,社会信息的存在使得歌曲的最终命运变得高度不可预测:同一首歌在不同的平行实验世界里可能大红大紫,也可能默默无闻,取决于早期的偶然积累。这揭示了文化市场中"成功孕育成功"的自我强化机制,与歌曲本身的内在质量关系有限。将这一设计移植到学术论文领域,研究者实际上是在检验:科学注意力市场是否也存在同样的社会影响动力学——而如今的"听众"变成了AI智能体。
从众效应的三个维度
实验数据清晰地展示了社会信号如何改变AI群体的行为模式。相比独立选择的社群,能看到他人选择的社群表现出三个特征:
选择量减少:社会信息社群中,每个智能体平均少选了17.2%的论文。看到别人的选择反而让AI变得更"保守",倾向于跟随而非广泛探索。
注意力更集中:这些社群的选择更加聚焦于少数论文,形成明显的头部集中效应。
覆盖面收窄:社会影响社群集体只覆盖了73篇论文,而独立社群覆盖了90篇。这意味着有相当一部分论文在社会信号的作用下被彻底忽视。
更值得关注的是,社会信息条件下的"社群间差异"更大。也就是说,不同社群最终追捧的论文可能截然不同——这正是音乐实验室实验中"不可预测性"的体现。哪些论文成为热门,很大程度上取决于早期的偶然选择,而非论文的内在质量。
早期优势的滚雪球效应
第二个实验直接检验了"初始信号"的因果力量。研究者在20个社会社群、共200个智能体中,随机给某些论文分配5个初始选择(相当于人为制造"起跑优势")。结果显示,这些被随机加持的论文,后续被选中的概率提升了45.55个百分点(95%置信区间为41.20到49.90)。
这是一个惊人的因果证据:仅仅因为一篇论文在开始时"看起来更受欢迎",它就能获得压倒性的后续关注——即便这种初始受欢迎程度完全是随机分配的。这揭示了一种典型的"马太效应"机制在AI群体中同样成立:先获得关注的更容易持续获得关注。
"马太效应"(Matthew Effect)这一概念由社会学家Robert K. Merton于1968年提出,源自《圣经·马太福音》中"凡有的,还要加给他"的表述。Merton用它描述科学界中已有名望的科学家往往获得更多资源、引用和认可,而无名之辈的成果则更容易被忽视——即便两者质量相当。在信息系统和推荐算法领域,这一效应被理解为"累积优势"或"富者愈富"机制:早期获得关注的内容因为排名靠前、被展示频率更高,从而吸引更多后续关注,形成正反馈循环。本研究的实验二将马太效应从相关观察推进到了因果检验层面——通过随机化初始优势来排除内容质量的干扰,直接证明了"起跑位置"本身的独立因果力量在AI群体中同样成立。
AI的选择与真实价值脱钩
研究还发现了一个令人担忧的现象:AI智能体的选择与外部引用数只有"适度"的对应关系,而与下载量几乎没有对应关系。换句话说,AI群体的注意力分配并不能可靠地反映论文在人类学术界的真实影响力或价值。
当AI越来越多地参与文献筛选、研究推荐和知识综合时,这一发现具有现实意义。如果AI系统在评估科研时也会被社会信号带偏,且其偏好与真实学术价值相关性有限,那么由AI驱动的科研发现和推荐系统就可能放大既有的注意力不平等,甚至制造出与质量无关的"人造热门"。
这一发现的背景是,学术界长期以来就引用数和下载量作为论文质量代理指标的有效性存在争议。引用数受到学科规模、论文年龄、自引比例等诸多因素干扰;下载量则更多反映曝光度和标题吸引力,而非内容深度。尽管如此,这两个指标仍是目前最广泛使用的可量化学术影响力信号,并已被谷歌学术、Semantic Scholar等平台大量用于排序和推荐。当AI系统的选择偏好与这两个信号均相关性有限时,意味着AI注意力分配既未能充分捕捉传统学术影响力,又受社会从众效应扭曲,形成了一种既非质量驱动、也非独立判断的混合偏差状态。这对于依赖AI进行文献综述、假设生成或优先排序的科研流程来说,是一个结构性风险。
一条简单规则的深远影响
这项研究的核心洞见在于:一个极其简单的信息规则——"能否看到他人的选择"——就足以系统性地改变一个人工群体对科学注意力的分配,影响其数量、广度和分布结构。
对于正在构建AI科研助手、文献推荐系统和自动化评审工具的开发者而言,这提出了一个必须正视的设计问题:向AI暴露多少社会信号?是否应该刻意屏蔽引用数和热度排名,以保持AI评估的独立性和多样性?在追求效率的同时,如何避免AI群体陷入与人类社会同样的从众陷阱?
这项研究并未给出完整答案,但它用严谨的实验方法揭示了一个此前被忽视的风险维度。当AI成为科学知识的"读者"和"守门人",它们的集体行为模式值得我们更加审慎地对待。
相关推荐
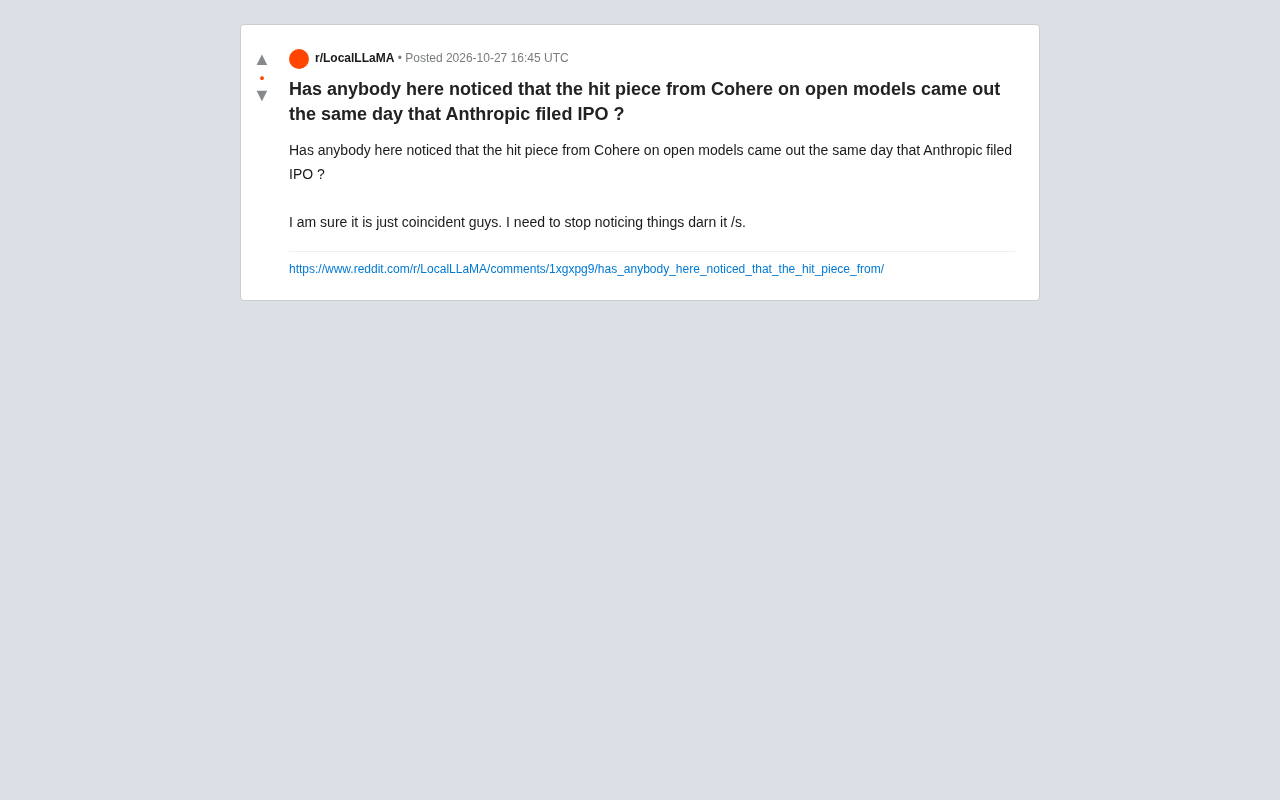
Cohere质疑开源模型与Anthropic IPO同日:巧合还是策略?
Reddit用户发现Cohere批评开源模型的文章与Anthropic提交IPO在同一天发布,引发社区对闭源厂商公共言论商业动机的讨论。本文分析这一时间巧合背后的开源与闭源之争,以及社区反应揭示的信任问题。
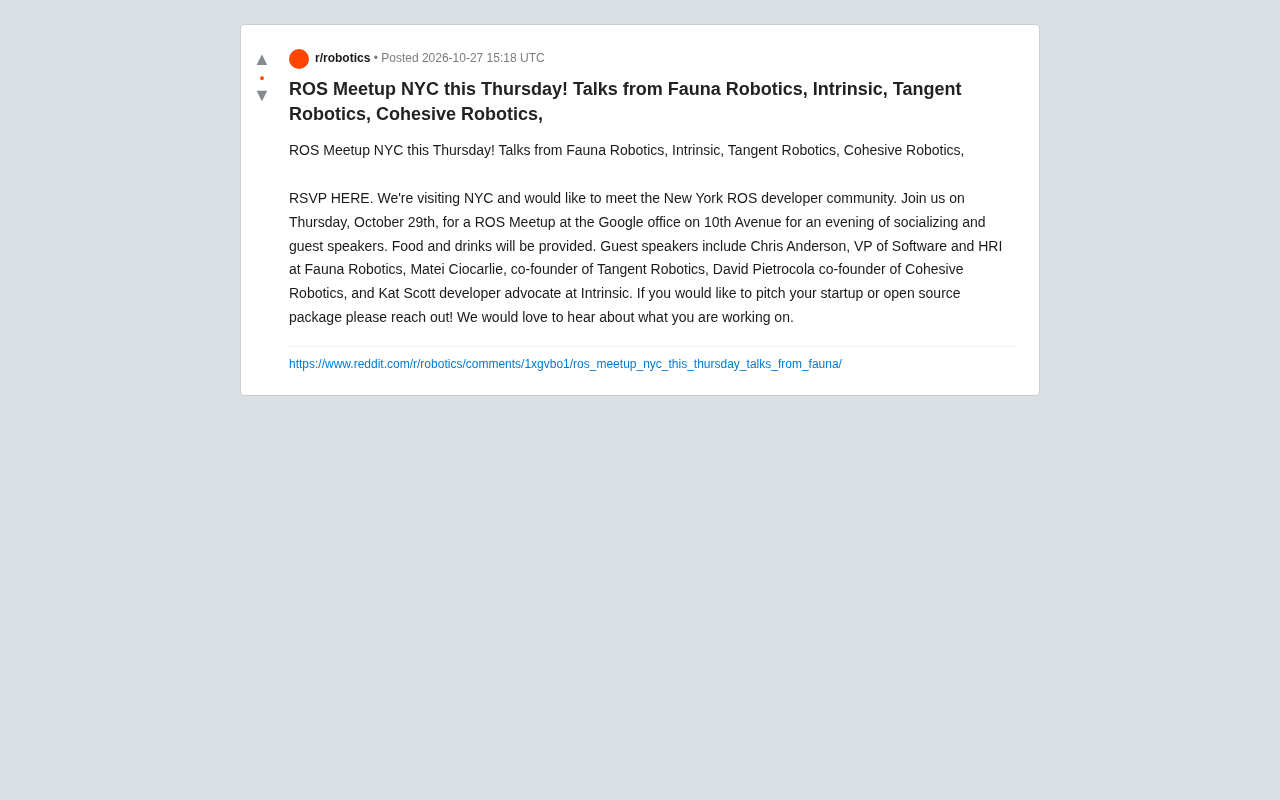
纽约ROS开发者聚会:四家机器人公司演讲
纽约ROS开发者聚会将于周四在谷歌办公室举行,Fauna Robotics、Intrinsic、Tangent Robotics、Cohesive Robotics等公司代表将发表演讲,活动免费并提供餐饮,开放报名与演讲征集。
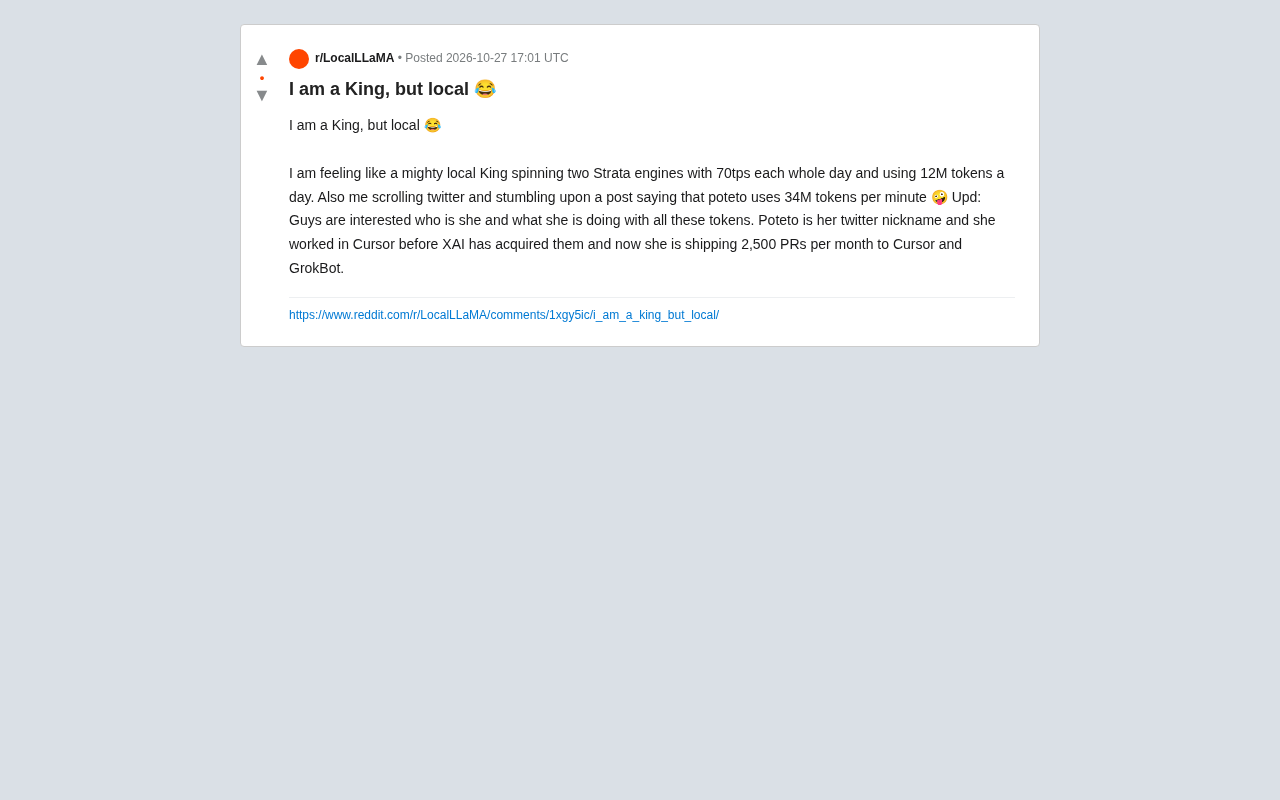
本地AI王者:日耗12M token背后的算力差距与竞争焦虑
Reddit开发者自嘲本地AI王者:日耗12M token,却被每分钟34M token的云端玩家降维打击。文章探讨本地部署与云端自动化的算力差距、token消耗量背后的行业焦虑,以及开发者如何在两种模式间找到平衡。