当Q-learning超参数由性格决定:一个文明模拟器的强化学习设计复盘

文明模拟器用人物特质驱动每个NPC的Q-learning超参数,稳定性与奖励塑形缺陷值得警惕。
文章分析了一个文明模拟器项目:每个NPC是独立的表格型Q-learner,其学习率alpha和折扣因子gamma由memory_strength与curiosity映射得到,epsilon随年龄衰减。这种人格绑定超参数的设计在叙事上很有吸引力,但从控制论角度看存在稳定性隐患——alpha上限0.22偏高,gamma可达0.94,且二者由不同特质独立控制,可能出现高alpha加高gamma的危险组合。奖励塑形方面,0.006的不活跃惩罚阈值会误伤小额正奖励,导致约16%的更新为负,其中98%是重复成功动作被错误惩罚。bootstrap掩码对未见状态取0并跳过计算,工程上可接受但存在偏差。作者提出用success flag修复,并建议对alpha加访问次数递减、监控高alpha高gamma组合、合并探索相关奖励项。
当每个NPC都有自己的学习率和折扣因子
在强化学习的教科书里,alpha(学习率)和gamma(折扣因子)通常是全局超参数,调好了就固定不动。但Reddit上一位开发者分享了他在文明模拟器中的做法:每个个体都是独立的表格型Q-learner,而它们的超参数直接由人格特质推导出来。
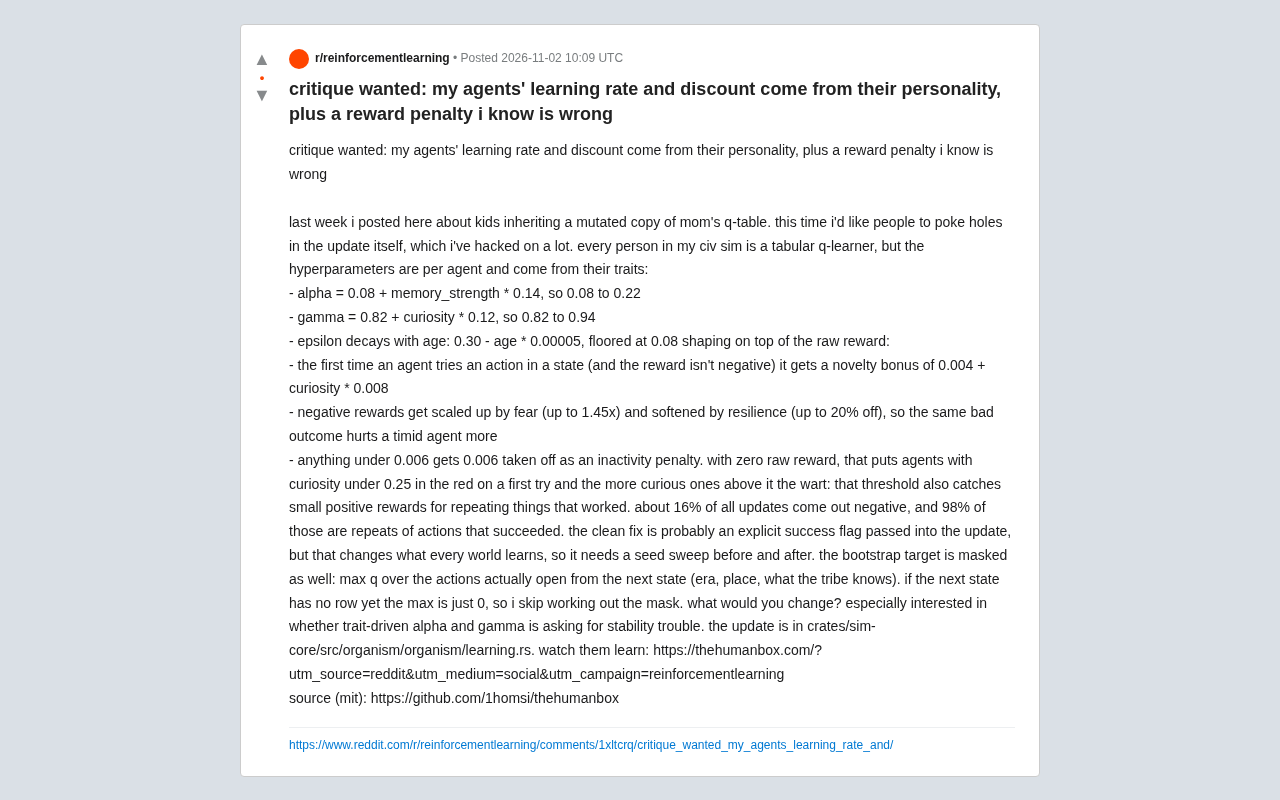
具体映射关系是:
- alpha = 0.08 + memory_strength × 0.14,取值范围落在 0.08 到 0.22 之间
- gamma = 0.82 + curiosity × 0.12,取值范围 0.82 到 0.94
- epsilon 随年龄衰减:0.30 − age × 0.00005,下限 0.08
这个设计在叙事层面很有吸引力——记性好的agent学得快,好奇心强的agent更看重远期回报。但从控制论角度看,它把两个最敏感的超参数交给了会随时间演化的人格分布,稳定性问题几乎是必然要面对的。
性格驱动超参数的隐患
学习率上限0.22在表格型Q-learning里偏高。单步更新时,新经验会覆盖掉相当大比例的历史估计,如果奖励信号本身带噪声,高alpha的agent容易出现Q值震荡,表现为行为反复横跳。原作者也明确询问"trait-driven alpha和gamma是否在稳定性上自找麻烦",这个担忧是对的。
gamma接近0.94也不轻松。折扣因子越高,bootstrap目标里的方差传播链越长,配合高alpha,误差会被反复放大。更麻烦的是,这两者由不同特质独立控制,意味着可能出现"高alpha + 高gamma"的组合——这在传统调参里是要极力避免的配置。
一种折中思路是把alpha与gamma做负相关耦合,或者给alpha设一个随更新次数递减的上限,让早期探索快、后期收敛稳。
表格型Q-learning的更新式为 Q(s,a) ← Q(s,a) + α[r + γ·max Q(s',a') − Q(s,a)]。α 控制单步新经验对旧估计的覆盖比例,γ 决定未来奖励在当前决策中的权重。两者共同影响 bootstrap 目标的方差:α 越大,每次更新引入的噪声越大;γ 越接近 1,价值估计的方差沿时间链传播得越远。经典调参经验认为,α 与 γ 存在此消彼长的关系——高 γ 需要更小的 α 来抑制方差累积,反之亦然。将二者分别绑定到独立的人格特质,等于放弃了这种耦合约束,使系统可能采到“高 α + 高 γ”这类在手工调参中会被直接排除的参数组合。这也是原作者担忧稳定性的根本原因。
奖励塑形里的一个已知缺陷
原帖作者很坦率地承认了一个bug:"the wart"。
新颖性奖励与恐惧/韧性缩放
他在原始奖励之上叠了三层塑形:
- 新颖性奖励:agent首次在某状态下尝试某动作且奖励非负时,获得 0.004 + curiosity × 0.008 的加成
- 负奖励缩放:负面结果被fear放大约1.45倍,同时被resilience削弱最多20%,所以同样的坏结果对胆小的agent伤害更大
- 不活跃惩罚:任何低于 0.006 的奖励会被扣掉 0.006
前两条的逻辑是自洽的——恐惧放大负面体验、韧性缓冲打击,这与人格设定一致。问题出在第三条的阈值。
16%的更新变成了负数
那条 0.006 的不活跃惩罚会误伤小幅正奖励。作者自己统计:约16%的更新结果为负,其中98%其实是"重复成功动作"被惩罚打成了负值。换句话说,agent做对了事、拿到了小额正反馈,却被系统判定为"不够活跃"而扣分。
这会让agent对稳定有效的行为产生错误的负面关联,长期看会抑制 exploitation——恰好是Q-learning收敛后最需要的行为模式。作者提出的修复方案是显式传入success flag,让更新逻辑区分"真的没做事"和"做了但收益小"。他也意识到这会改变所有世界的学习轨迹,所以需要做seed sweep对比前后差异。这个态度比直接patch更值得肯定。
奖励塑形(reward shaping)指在环境原始奖励之外人为添加辅助奖励项,以引导 agent 更快学到期望行为。它的理论依据是 Ng 等人提出的势函数方法:若塑形项可表示为某个势函数的差分,则不改变最优策略;否则可能引入策略偏差。本文的新颖性奖励和不活跃惩罚都属于非势函数塑形,因此会改变 agent 实际优化的目标。尤其是固定阈值的惩罚项,会把“做了但收益小”和“完全没做事”混为一谈,造成奖励信号与真实任务目标之间的错位。作者提出的 success flag 本质上是在塑形项中引入一个二值事件指示器,从而把“是否发生有效交互”与“交互收益大小”解耦。
Bootstrap掩码:细节里藏着正确性
原帖提到bootstrap目标是做过掩码的:取下一状态实际可行动作上的max Q。如果下一状态还没有对应的Q表行,max直接取0,此时跳过掩码计算。
这个分支处理值得聊两句。在表格型Q-learning里,未见状态用0初始化是常见做法,但它会引入乐观偏差——尤其当奖励全为正时,0实际上是个悲观估计。更严谨的做法是用该状态已见动作的均值或最小Q做初始化。不过对于模拟器这种状态空间爆炸、大部分状态只访问几次的场景,0初始化在工程上可以接受,只是要意识到它会让早期探索偏向未访问区域。
另一个细节是掩码依赖"era、place、tribe knows"这三元组,说明动作可用性本身是动态的。这增加了掩码计算的频率,但也让bootstrap目标更贴近真实决策空间,避免了在不合法动作上做max的经典错误。
Bootstrap 是时序差分学习的核心机制:用当前估计的下一状态价值来更新当前状态价值,而不必等到回合结束。表格型 Q-learning 中,若下一状态 s' 从未被访问过,其 Q 表行尚不存在,max 操作无从计算。常见处理是用 0 初始化新状态的所有动作值。当奖励全为正时,0 相对于真实期望回报是偏低的,因此 agent 会倾向于把未访问状态视为“不值得去”,产生悲观偏差;反之若奖励含负值,0 可能偏乐观。更稳健的做法包括用已见动作的均值初始化、用全局平均回报初始化,或引入基于访问计数的乐观初始化(如 R-max 类算法)。本文场景中状态空间随文明演化持续膨胀,多数状态仅被访问数次,0 初始化在工程上可接受,但需意识到它会影响早期探索的方向性。
值得尝试的几个改动方向
综合来看,这套设计最有价值的部分是把人格与学习动态绑定,最危险的部分也是它。如果由我来提建议:
优先修复不活跃惩罚。这是明确的逻辑错误,且影响面可量化(16%的负更新里98%是误伤)。先加success flag,再做seed sweep,确认修复没有破坏其他涌现行为。
给alpha加一个上限或衰减。0.22作为初始值可以接受,但应随该状态-动作对的访问次数递减,比如除以访问次数的平方根。这样既保留了性格差异,又避免了长期震荡。
监控高alpha高gamma组合的行为。可以统计这类agent的Q值方差和动作切换频率,如果显著高于群体均值,就说明稳定性问题确实存在,需要在trait映射里加约束。
考虑把新颖性奖励与不活跃惩罚合并。两者本质上都在鼓励探索,但一个加一个减,逻辑上打架。统一成一个随访问次数衰减的探索加成会更干净。
代码在 crates/sim-core/src/organism/organism/learning.rs,项目采用MIT协议开源,作者也提供了可交互观察学习过程的demo。对于想做多智能体强化学习或社会模拟的开发者,这是一个值得对照自己实现来读的案例——尤其是它暴露的失败模式,比成功经验更有参考价值。
相关推荐

AI能直接读懂神经网络权重:模型能力已超出预期?
Reddit开发者实验显示,语言模型能直接阅读神经网络权重并推断其功能。Astra、Opus 5.5和Muse Spark 1.3均通过测试,引发对模型泛化能力与训练来源的讨论。

印度微短剧市场爆发:EloElo获NBCUniversal 8000万美元投资
印度社交娱乐平台EloElo获NBCUniversal 8000万美元投资,加码微短剧平台StoryTV。StoryTV月活超3300万,印度微短剧市场正吸引全球资本关注。

多旋翼无人机声学检测:融合手工特征与预训练嵌入
研究揭示无人机声学检测中随机划分导致数据泄漏,提出源不相交评估协议下融合手工声学特征与YAMNet嵌入的堆叠集成方法,准确率达95.29%,为低成本无人机探测提供可靠基准。