当音视频误导AI:多模态情感识别鲁棒性审计

审计显示Omni模型能利用真实音视频,但无关输入会系统性显著拉低准确率。
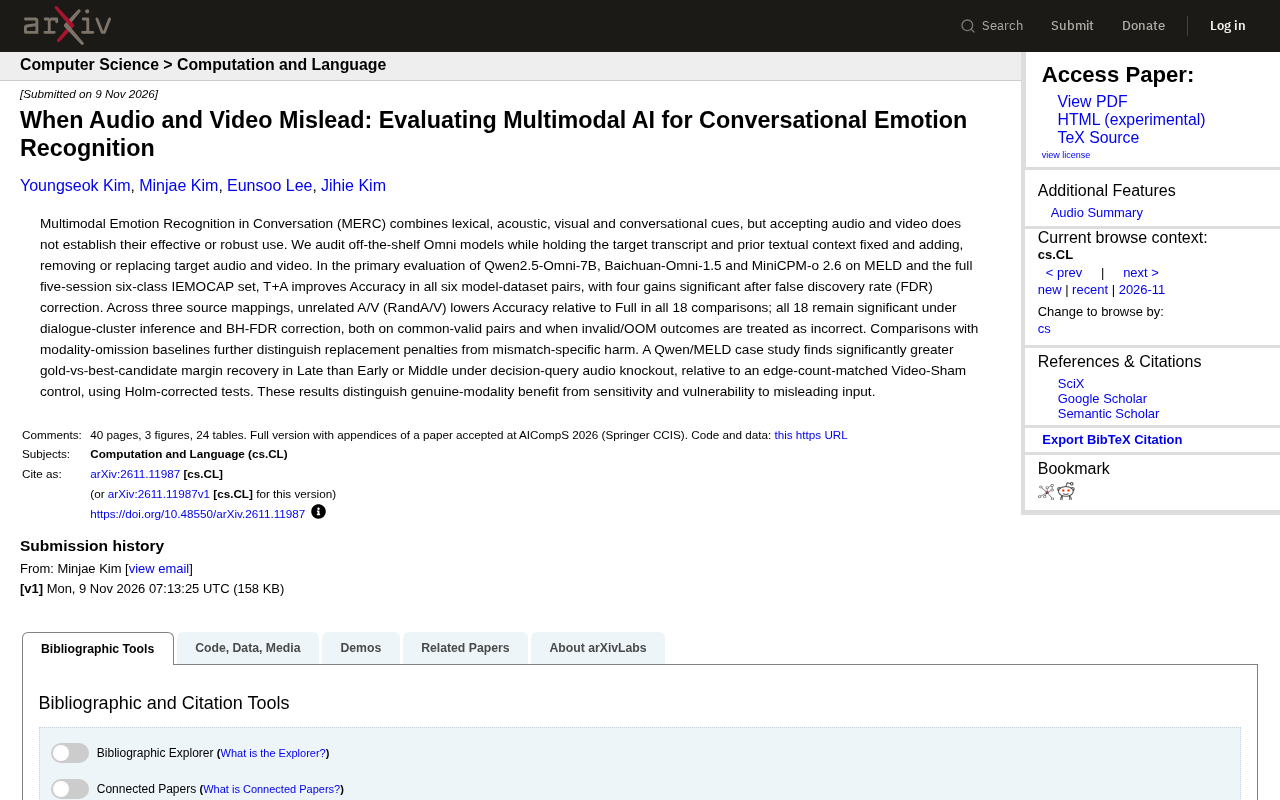
一项针对现成多模态情感识别(MERC)Omni模型的审计研究,通过固定文本上下文、仅扰动音视频输入,分离考察模态贡献与风险。在Qwen2.5-Omni-7B、Baichuan-Omni-1.5和MiniCPM-o 2.6上,加入目标音频在全部六组模型-数据集配对中提升准确率,四组经FDR校正显著;而用无关音视频替换原始输入则在全部18组比较中显著降低准确率。案例研究进一步显示,音视频信息在推理链条后段整合时更可能被真正利用。研究呼吁区分模态利用有效性与对误导输入的脆弱性,并将音视频替换压力测试纳入部署前评估。
多模态情感识别(MERC)模型能同时处理文本、语音、视觉和对话上下文,但“能接收音视频”不等于“能可靠使用它们”。一项针对现成 Omni 模型的审计研究揭示了令人不安的现实:无关的音视频输入会系统性地拉低模型准确率,而这种损害在统计上高度显著。
审计设计:固定文本,扰动音视频
研究者的方法很巧妙——保持目标转录文本和先前的文本上下文不变,只对目标音视频做添加、移除或替换。这样就把音视频的影响从文本信息中剥离出来,单独考察其贡献与风险。
主评测覆盖 Qwen2.5-Omni-7B、Baichuan-Omni-1.5 和 MiniCPM-o 2.6 三个模型,数据集为 MELD 和完整的五会话六类 IEMOCAP。核心对照有三类:文本+音频(T+A)与纯文本的对比、完整音视频(Full)与无关音视频(RandA/V)的对比、以及模态省略基线。
FDR校正与BH-FDR:FDR(False Discovery Rate,错误发现率)校正是一种多重假设检验的校正方法。当研究同时进行多次统计检验时(如跨多个模型-数据集配对),假阳性率会累积升高。BH-FDR(Benjamini-Hochberg 方法)通过控制被错误拒绝的原假设比例来平衡发现能力与假阳性风险。文中“经FDR校正后显著”意味着结果在考虑多重比较后仍具统计可靠性,而非仅单次检验显著。
对话簇推断:由于MELD和IEMOCAP均为对话数据,同一对话内的样本高度相关(情感表达受上下文影响)。对话簇推断(cluster-robust inference)将同一对话的样本视为一个“簇”,在计算标准误时考虑簇内相关性,避免因样本非独立而高估统计显著性。这是对话级情感分析中保证推断有效性的关键做法。
真实模态有增益,但统计强度不均
在全部六组“模型-数据集”配对中,加入目标音频(T+A)都提升了准确率,其中四组在 FDR 校正后仍然显著。这说明音视频并非摆设,在多数情况下确实携带了文本之外的情感线索。
不过,六组中只有四组显著,意味着增益的稳健性存在差异。对于部署方而言,这是一个提醒:不能假设所有模型对音频的利用程度一致,选型时值得逐项验证。
T+A与Full的对照含义:T+A(文本+音频)与纯文本的对比衡量音频的增量贡献;而Full(文本+音频+视觉)与T+A的对比则进一步分离视觉模态的作用。文中所谓“模态省略基线”指依次去掉某一模态后的性能,用于判断各模态的边际价值。这种设计能区分“多模态整体有效”与“某一模态单独有效”,对模型选型与融合策略有直接指导意义。
误导性输入造成普遍且显著的损害
更值得关注的是反面结果。在三种来源映射下,用无关音视频替换原始音视频(RandA/V),相对于完整输入在全部 18 组比较中都降低了准确率,且全部 18 组在对话簇推断和 BH-FDR 校正下保持显著——无论是只统计共同有效配对,还是把无效/显存不足的结果计为错误,结论都成立。
这个“18/18”的压倒性结果说明,多模态模型对音视频通道的敏感是一把双刃剑:真实信号带来增益,虚假信号带来伤害。与模态省略基线的对比进一步区分了两种效应——替换惩罚不同于简单缺失,它指向的是“错配特异性伤害”,即模型会把不匹配的音视频当作有效证据来使用。
错配特异性伤害:指模型并非简单忽略无关输入,而是将不匹配的音视频错误地当作与文本情感一致的有效证据进行融合,从而产生比缺失模态更严重的性能下降。这种伤害具有特异性——它源于跨模态语义不一致,而非信息量减少。这提示融合机制缺乏对模态间一致性的校验,是当前Omni模型的共性弱点。
案例研究:信息何时真正被利用
Qwen/MELD 的案例研究提供了机制层面的线索。在决策查询音频敲除实验中,相对于边数匹配的 Video-Sham 对照,Late 阶段的 gold-vs-best-candidate 边际恢复显著大于 Early 或 Middle(Holm 校正检验)。这暗示音视频信息在推理链条后段被整合时,模型更可能真正加以利用,而非表面接收。
决策查询音频敲除实验:一种因果归因方法。通过“敲除”(移除或替换)特定音频片段,观察模型对目标候选(gold vs. best-candidate)的边际得分变化,从而判断该音频是否被实际用于决策。Late/Early/Middle指敲除发生在推理链条的不同阶段(如浅层融合 vs. 深层融合)。若Late阶段敲除导致边际恢复显著更大,说明模型在推理后段才真正整合音频信息,而非表面接收。
Holm校正检验:一种控制族错误率(FWER)的多重比较校正方法,比Bonferroni更保守但更具统计效力。文中用于比较Early、Middle、Late三阶段的差异,确保结论在多次比较下仍稳健。
对实践者的启示
这项审计的价值在于把“模态利用有效性”和“对误导输入的脆弱性”区分开来。前者问的是模型是否用了音视频,后者问的是用错了会怎样。两个问题的答案可以同时为“是”——这正是当前 Omni 模型的处境。
对构建对话情感分析系统的团队来说,有几点直接可操作:在真实部署前做音视频替换压力测试,而不仅是消融实验;关注无效/显存不足等边界情况下的表现,因为它们可能被计入错误;以及审慎选择音视频融合的时机与层级,案例研究提示后段整合可能更有效。
多模态能力的“有无”已经不再是区分点,能否在误导性输入下保持稳定,才是下一阶段的评测重点。
相关推荐

Fable 5.2自我改进循环加速,Gemini 4 Carbon紧追
Anthropic Fable 5.2与Google Gemini 4 Carbon同期发布,远程劳动指数翻倍增长,自我改进循环加速,但基准缺陷与评估意识问题并存。
Meta FAIR发布e-means:k-means新替代,收敛快十倍
Meta FAIR 在 FAISS 1.16.0 中发布 e-means,作为 mini-batch k-means 的替代方案,达到同等损失所需 epoch 减少约一个数量级,GPU 加速 10 到 45 倍,且无需新增超参数。

AI写代码好用,但为何代码库越来越脆弱?
AI编程工具提升效率的同时,可能让代码库变得脆弱。本文基于开发者博客和Hacker News讨论,分析AI生成代码的隐性成本、社区分歧与降低风险的实践建议。