Databench:面向数据团队的开源协作式AI智能体工作空间

Databench 是整合实时多人协作、AI 多智能体与开源自托管的数据科学工作空间。
Databench 是由 Alkera 推出的开源数据科学协作平台,旨在解决数据团队长期"各自为战"的痛点。它将实时多人 Notebook 编辑、团队聊天、AI 智能体协作整合于同一界面,允许并行启动多个 agent 探索不同的数据分析路径。在计算资源调度上,用户可将任意单元格或 agent 运行于本地、远程机器或 GPU 节点,兼顾轻量原型与重计算任务。产品强调每个结果均可回溯至具体数据与代码,以保障可复现性。Databench 提供官方托管(含免费额度)与 GitHub 自托管两种部署方式,后者对有数据合规需求的企业尤为友好。该项目上线 Product Hunt 后获167票,排名当日第5,但实际协作延迟、多智能体编排成熟度及与现有数据栈的集成深度仍有待验证。
数据科学团队的协作长期停留在"各自为战"的状态——每个人在自己的 Jupyter Notebook 里跑分析,结果靠截图和消息传递,复现一份实验往往要翻遍散落在各处的代码与数据。来自 Alkera 的开源项目 Databench 试图改变这一局面,它把实时多人协作、AI 智能体与可追溯的计算环境整合进同一个工作空间。该产品在 Product Hunt 上线后获得 167 票、排名当日第 5,被归类于开源、人工智能与数据科学三大类目。
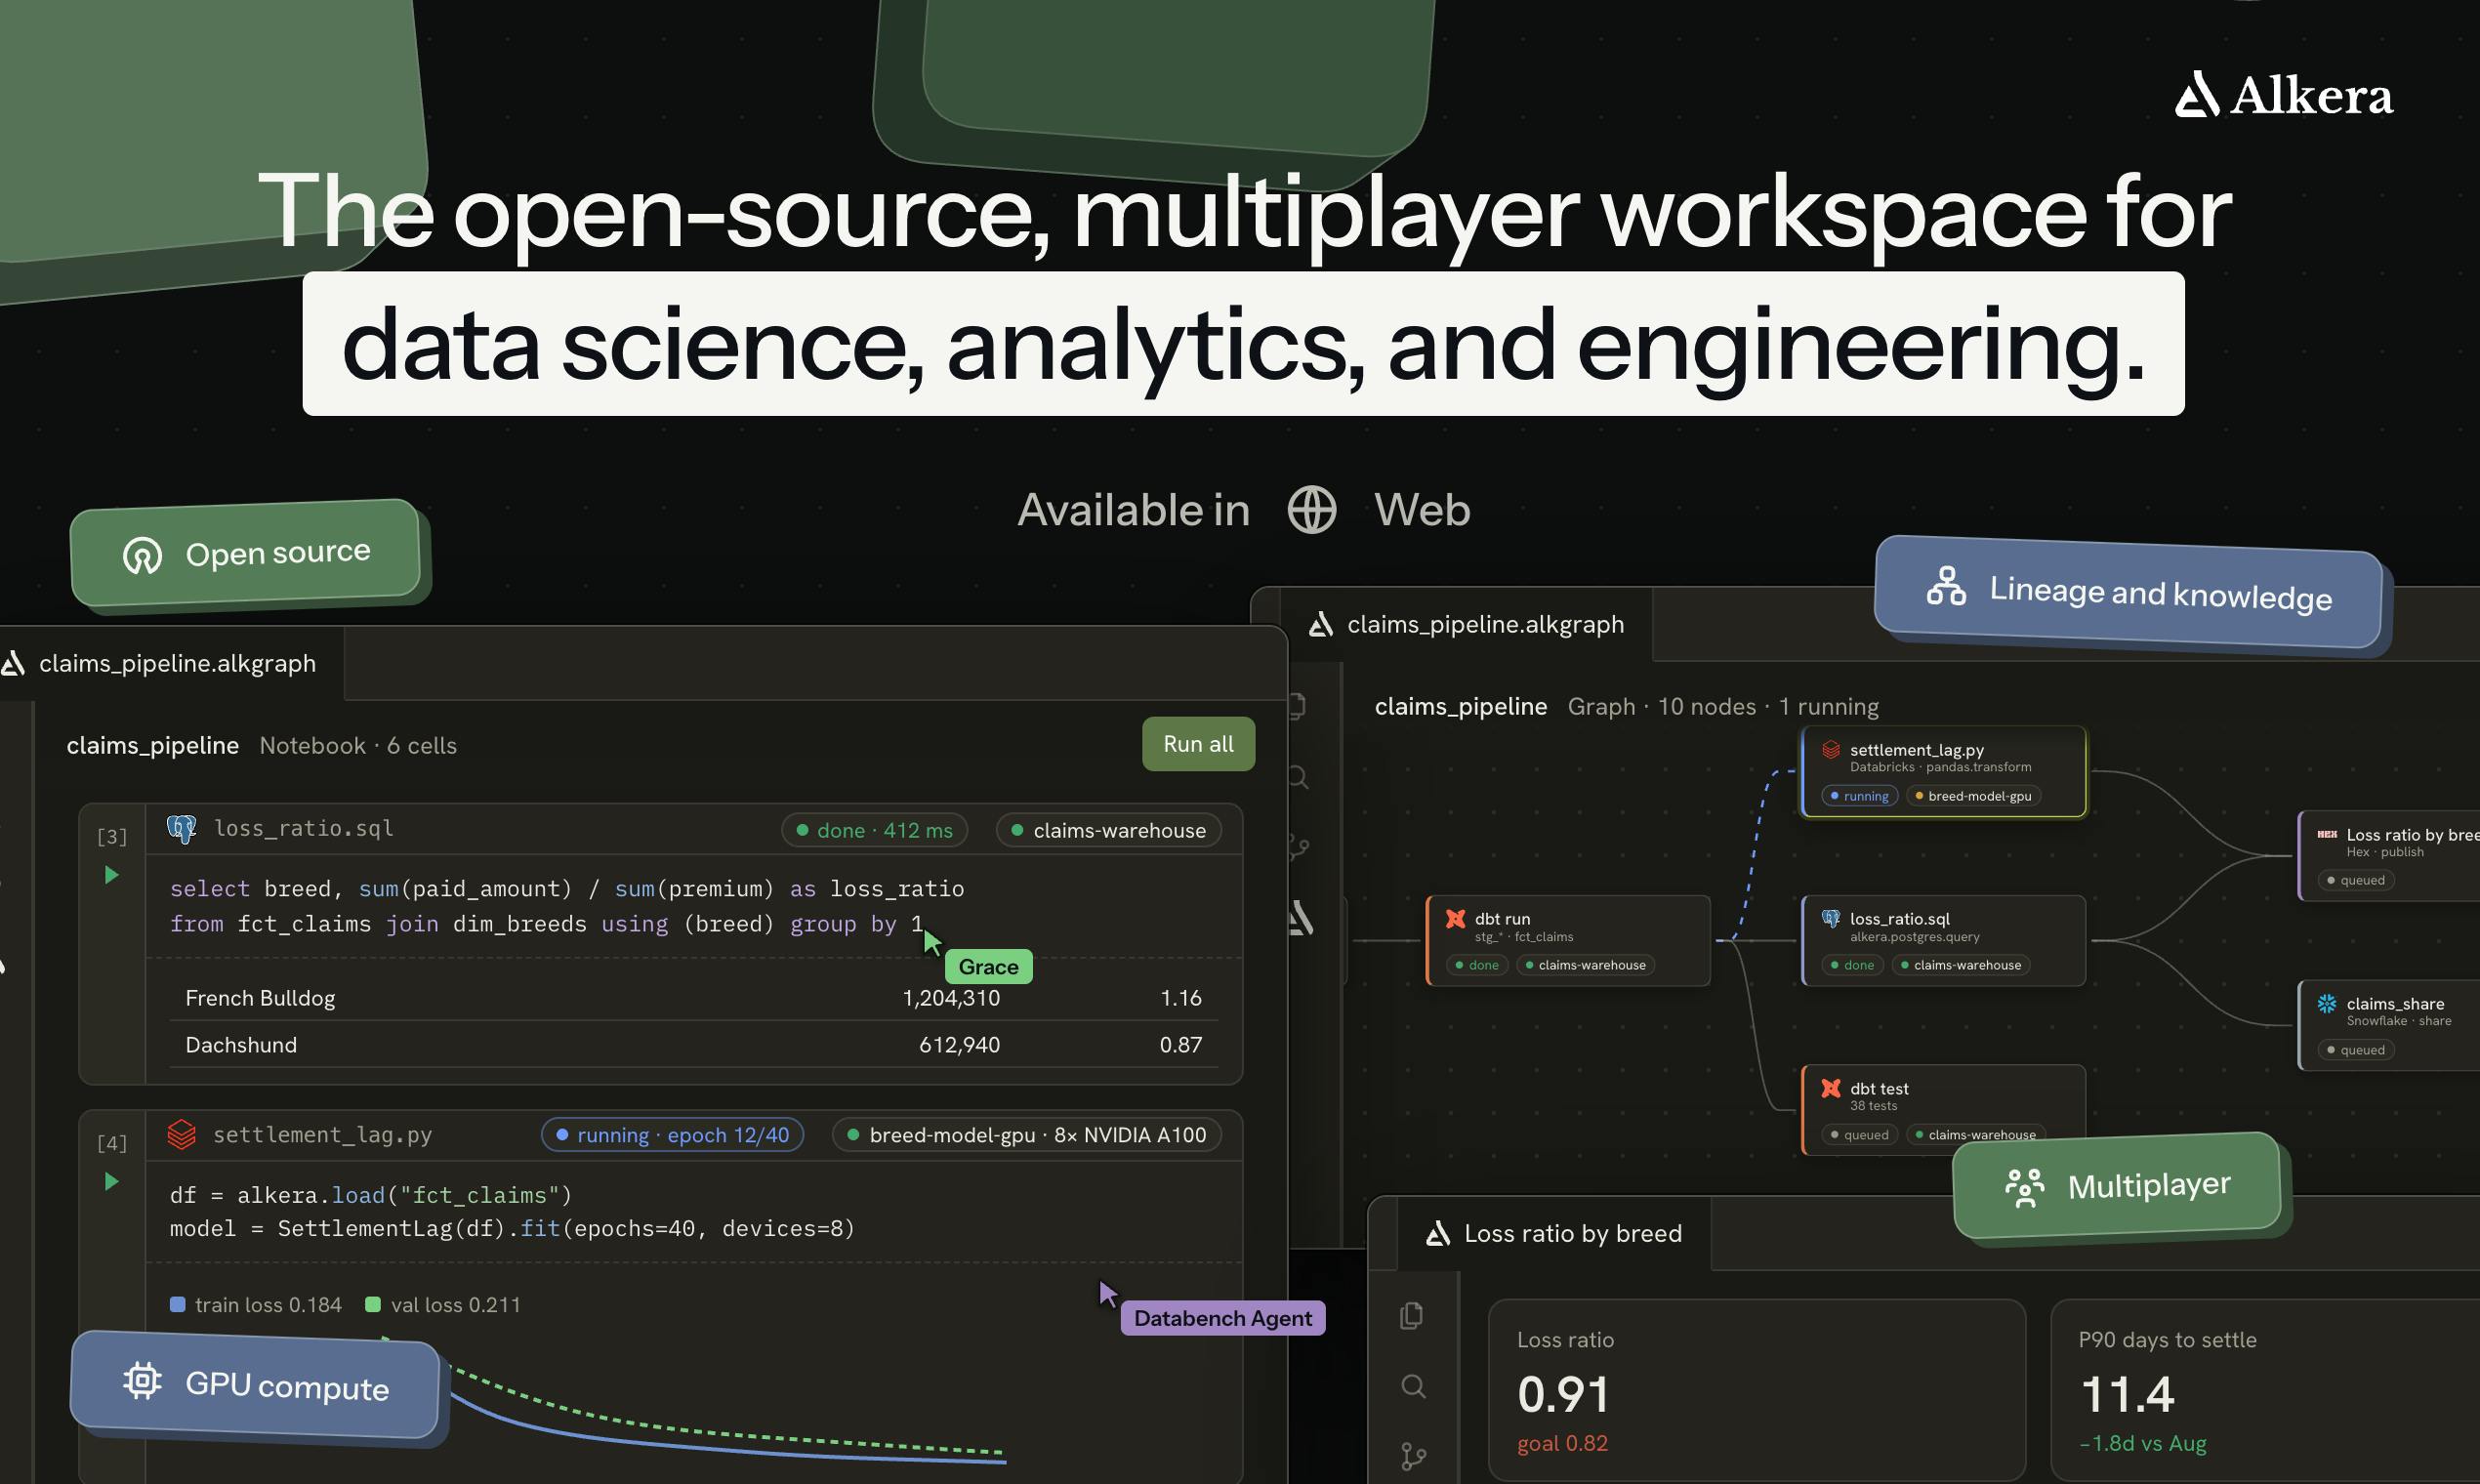
多人实时协作的数据工作空间
Databench 把自己定位为"面向数据科学、分析与工程的开源多人(multiplayer)工作空间"。它最核心的卖点是实时协同:团队成员可以像在 Google Docs 中那样,在同一个 Notebook 和聊天窗口里并肩工作,而不再是各自维护一份本地副本后再手动合并。
这种"多人"模式对数据团队的意义不止于编辑体验。在传统工作流中,分析师、工程师与数据科学家往往使用不同的工具链,交接成本高。将 Notebook 与对话(chat)置于同一界面,意味着讨论、代码与结果能够保持在同一上下文中,减少了信息在不同渠道间流转时的损耗。
把 AI 智能体引入 Notebook
与普通协作工具不同,Databench 的"agentic"属性是其区别于传统 Notebook 平台的关键。用户不仅能和人类队友协作,还能与 AI 智能体一同工作。
官方描述中提到一个颇具想象力的能力:可以并行启动多个智能体来探索不同的想法(launch many agents in parallel to explore ideas)。对于数据探索这种高度试错的工作而言,这种并行化意味着可以同时让多个 agent 尝试不同的特征工程、模型假设或数据清洗路径,再比较各自产出的结果,而不必串行等待。
这类设计反映了当前 AI 工具演进的一个趋势:智能体正从"单个助手"向"可编排的多智能体工作流"过渡,而数据分析恰好是适合多路并行探索的场景。
**多智能体工作流(Multi-Agent Workflow)**是近年来大模型落地应用的重要范式转变。与单一 LLM 对话不同,多智能体框架允许将一个复杂任务拆解为多个子任务,由独立的 agent 分别执行——每个 agent 可拥有不同的工具访问权限、上下文记忆或模型后端。在数据科学场景中,这意味着可以让一个 agent 专注特征工程、另一个负责模型选型、再由一个 agent 汇总评估指标,并行执行后统一比较结果。目前业界已有若干多智能体框架(如 LangGraph、AutoGen、CrewAI)尝试标准化这类编排逻辑,但将其原生嵌入 Notebook 交互环境,并与实时协作界面打通,仍属较新的探索方向。Databench 的并行 agent 设计正是借助了这一趋势,但多智能体的调度稳定性与结果可解释性在实践中仍是尚待验证的工程挑战。
灵活的计算后端与可追溯性
Databench 在计算资源调度上提供了相当的灵活性。用户可以把任意一个单元格(cell)或智能体运行在本地笔记本、另一台计算机,或是 GPU 节点上。这种解耦让轻量任务留在本地、重计算任务下沉到 GPU 节点成为可能,对需要在原型验证与大规模训练之间切换的团队比较友好。
另一个值得关注的特性是完整的可追溯性——官方强调"每一个结果都能追溯回其背后的数据与代码"(Every result traces back to the data and code behind it)。在团队协作与 AI 智能体自动生成内容的场景下,可追溯性直接关系到结果的可信度与可复现性。当多个 agent 并行产出结论时,能够回溯到具体的数据与代码路径,是避免"黑箱结论"的重要保障。
**实验可追溯性(Experiment Lineage / Reproducibility)**是数据科学工程化成熟度的核心指标之一。传统 Jupyter Notebook 的一大痛点在于"执行顺序依赖":单元格可以乱序运行,同一份 Notebook 在不同时间、不同机器上可能产出截然不同的结果,导致他人无法复现。MLflow、DVC(Data Version Control)、W&B(Weights & Biases)等工具正是为解决这一问题而生,它们通过追踪数据版本、代码快照与超参数来构建完整的实验谱系。Databench 将可追溯性作为内置特性而非外挂插件,理论上可以在多人协作与多 agent 并行产出的复杂场景下,自动维护每个结论与其输入数据、执行代码之间的映射关系,从而降低"结果存在但不知怎么来的"这类团队协作中常见的认知债务。
开源与可自托管的交付方式
Databench 采用开源策略,并提供两种使用路径:一是通过官方托管服务 alkera.ai,附带"慷慨的免费额度"(generous free tier);二是直接从 GitHub 仓库(AlkeraAI/Databench)自行部署托管。
对数据团队而言,自托管选项尤为重要。数据资产通常涉及隐私与合规要求,许多企业无法将敏感数据交给第三方云服务。开源 + 自托管的组合,让团队既能在内网环境中运行完整功能,也能根据自身需求审查和改造代码,这与近年来数据与 AI 基础设施领域对"数据不出域"的强烈诉求相契合。
小结
Databench 把三个当下热门的方向——实时协作、AI 智能体、开源自托管——组合进了一个面向数据团队的工作空间。它瞄准的痛点清晰:分散的工具链、难以复现的实验、以及 AI 时代对多智能体并行探索的需求。
需要说明的是,目前公开信息仍以产品定位和特性描述为主,实际的协作延迟表现、多智能体编排的成熟度、以及与现有数据栈(如 dbt、Spark、各类数据仓库)的集成深度,都还有待在真实使用中验证。对于正在寻找团队级 Notebook 协作方案、又看重开源可控的数据团队来说,Databench 值得纳入评估清单。
相关推荐

@ai-sdk/workflow-harness 1.0.146 发布说明
@ai-sdk/workflow-harness 1.0.146 为补丁级别更新,依赖 @ai-sdk/harness 同步升级至 1.0.146,由 GitHub Actions 自动发布并经验证签名。

ICANN新顶级域名争夺战:Meta与OpenAI抢注.agent和.agi
ICANN放出1600份新顶级域名申请,Meta与OpenAI争夺.agent和.agi后缀;同时GTA VI发售倒计时泄露不断,Joe Rogan与Spotify达成约2.5亿美元续约。一文看懂科技圈头部资产争夺战。

MCP协议详解:20行代码搭建你的AI工具服务器
MCP(模型上下文协议)是连接 AI 应用与外部工具的通用标准,被称为「AI 界的 USB-C」。本文详解 MCP 的架构原理、无状态协议升级,并手把手教你用不到 20 行代码搭建自己的 MCP 服务器,附安全实践建议。