Databricks MLOps实战:MLFlow、Agent Bricks与Genie哪些真正好用

为什么MLOps落地总是比预期难
在企业级AI/ML项目中,模型训练往往只占整个生命周期的一小部分,真正的挑战在于将模型稳定、可复现、可监控地部署到生产环境——这正是MLOps(机器学习运维)要解决的核心问题。近日,一位数据从业者在Reddit社区发起讨论,探索在Databricks平台上构建AI/ML工作流的真实体验,重点关注MLFlow、Agent Bricks、Genie等功能,并希望听到社区在实际落地过程中遇到的挑战与经验教训。
这个话题引发广泛关注,背后是Databricks近年来从数据处理平台快速演进为覆盖数据到AI全栈的"Data Intelligence Platform"这一现实。本文将围绕这些核心功能,梳理它们在MLOps流程中的定位、实际价值与常见落地挑战。
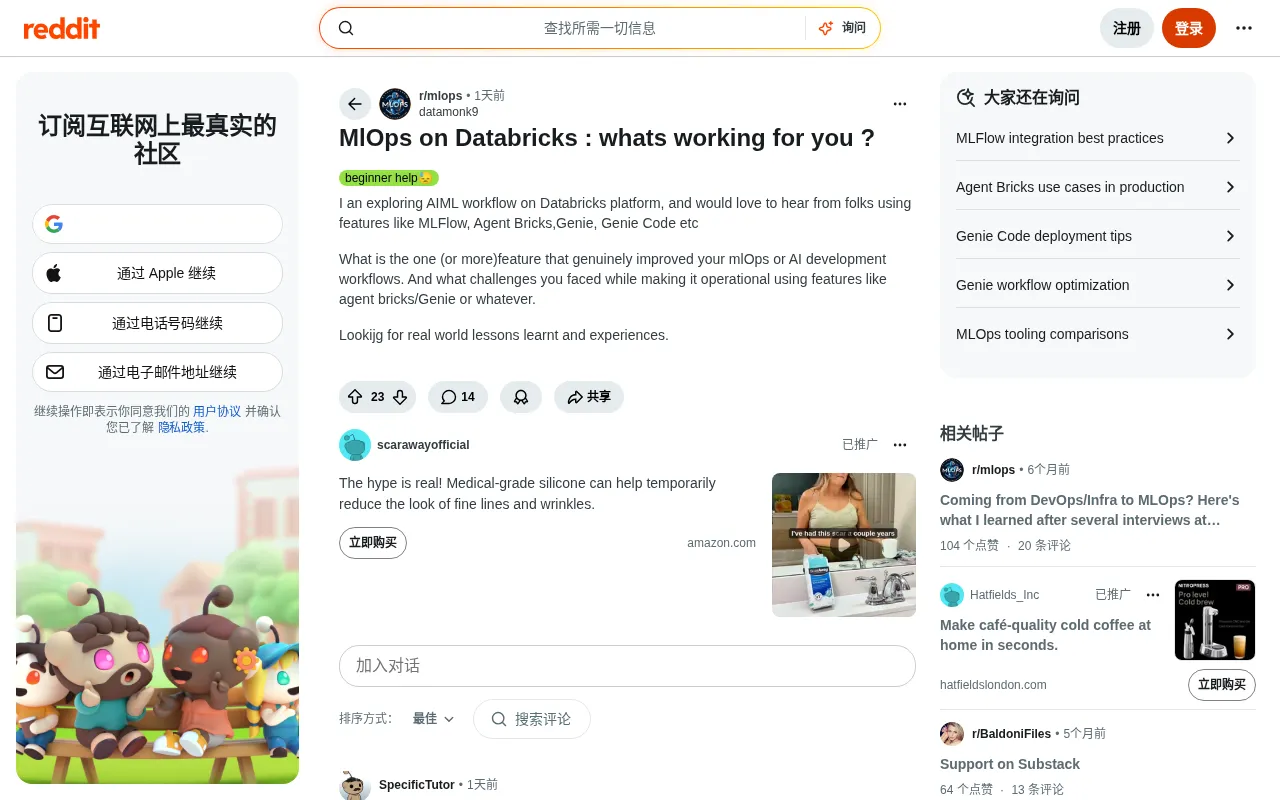
Databricks MLOps核心组件全解析
MLFlow:公认的实验管理基石
在Databricks生态中,MLFlow几乎是所有MLOps讨论的起点。作为一个由Databricks主导开发并深度集成到平台的开源工具,它的价值主要体现在以下几个层面:
- 实验追踪(Tracking):自动记录每次训练的参数、指标、代码版本和产物,解决"上次效果好的模型究竟用了什么配置"这一经典痛点。
- 模型注册表(Model Registry):提供模型版本管理与阶段流转(Staging / Production / Archived),让模型晋升有据可依。
- 模型服务(Model Serving):将注册的模型一键部署为REST端点,缩短从训练到上线的路径。
对于绝大多数团队而言,MLFlow是Databricks上MLOps工作流中最先见效、也最被广泛认可的组件。它把原本散落在Notebook和本地文件中的实验记录标准化,为可复现性和团队协作奠定基础。
Unity Catalog:数据治理的关键拼图
任何严肃的Databricks MLOps讨论都绕不开Unity Catalog。它统一了数据、特征表、模型和函数的治理与权限管理。当模型注册表与Unity Catalog集成后,模型资产可以像数据表一样进行血缘追踪和访问控制,对合规要求高的企业尤为关键。
Agent Bricks与Genie:生成式AI时代的新工具
Genie:用自然语言查询数据
Genie是Databricks推出的对话式分析功能,允许业务和技术人员用自然语言提问,系统自动生成SQL并返回结果,显著降低了数据探索的门槛。
然而,Genie的实际表现高度依赖底层数据的元数据质量。如果表和字段缺乏清晰注释、语义模糊,生成的查询准确率会明显下滑。社区反馈中反复出现的教训是:要用好Genie,必须先做好数据的语义层建设和元数据治理,否则容易得到"看起来对、实际错"的结果。
Agent Bricks:从模型到智能体的全流程管理
Agent Bricks是Databricks面向Agent(智能体)开发的功能模块,帮助团队构建、评估和部署基于LLM的智能体应用,并将Agent开发纳入统一的MLOps框架——涵盖版本管理、评估指标和生产监控。
但Agent类应用的运维远比传统ML模型复杂,挑战主要集中在三个方面:
- 评估困难:Agent输出是开放式自然语言,缺乏传统模型那样明确的准确率指标,需要专门构建评估集和评判逻辑。
- 成本与延迟管控:大模型推理成本和响应延迟必须精细监控,否则生产环境容易出现成本失控。
- 可复现性挑战:LLM的非确定性使得"复现某次表现"变得困难,与MLOps追求的可复现性存在天然张力。
生产环境落地的真实挑战
功能新颖但成熟度参差不齐
Agent Bricks、Genie等功能相对较新,社区积累的最佳实践仍在形成中。相比之下,MLFlow这类成熟组件的使用路径清晰,而生成式AI相关的新功能则需要团队投入更多探索和验证成本。
深度集成带来的厂商锁定风险
Databricks端到端集成是其核心优势,但也意味着更强的平台依赖。团队在全面拥抱Agent Bricks、Genie之前,需要权衡厂商锁定风险,以及这些专有功能与开源工具链(如LangChain、原生MLFlow)之间的迁移成本。
数据治理是所有功能的前提
无论传统ML还是Agent应用,Databricks上所有功能的效果都建立在数据质量和治理之上。Genie依赖元数据、模型监控依赖特征血缘、Agent评估依赖高质量数据集——这提醒团队:MLOps的成败往往不取决于工具本身,而取决于数据基础是否扎实。
给实践团队的落地建议
对于正在评估Databricks MLOps能力的团队,可以参考以下优先级路径:
- 从MLFlow起步:先用MLFlow把实验追踪和模型注册标准化,这是投入产出比最高的第一步。
- 打好治理地基:优先接入Unity Catalog,完善元数据和血缘管理,为后续高级功能铺路。
- 谨慎评估新功能:对Agent Bricks、Genie等新特性,建议先在非关键场景做PoC验证,重点考察评估逻辑、成本控制和可维护性。
- 建立监控闭环:无论传统模型还是Agent,都要在生产环境部署监控,持续追踪性能漂移和成本变化。
结语
Databricks正努力将从数据到AI Agent的全流程整合到一个平台。MLFlow这类成熟组件已成为许多团队MLOps的基石,而Agent Bricks和Genie则代表了生成式AI时代的新探索方向。正如Reddit社区讨论所揭示的,工具的价值最终由落地实践检验——真正决定MLOps成败的,往往不是选了哪个新功能,而是数据治理、评估体系和运维监控这些"看不见"的基础工作是否到位。
相关推荐

Anthropic递交S-1:半年营收163亿、净亏807亿,谁在控制公司?
Anthropic递交S-1申请纳斯达克上市:2026上半年营收163亿美元、净亏损807亿美元源于估值重估而非现金流出,创始人持Class F股份掌握50.1%投票权,发行价与日期尚未公布。

Anthropic递交S-1:163亿营收与807亿亏损背后的真相
Anthropic S-1文件披露2026上半年163亿美元营收与807亿美元净亏损,其中724亿为会计效应。文件同时揭示2656亿美元算力承诺、云协议细节及创始人50.1%投票权控制结构,IPO定价仍留白。

Anthropic财务数据曝光:营收远超算力成本,Claude推理毛利率达68%
Anthropic泄露财务数据显示,其营收约为总算力成本两倍,Claude推理毛利率达68%,而前沿训练单季烧掉28亿美元。本文拆解推理与训练两笔账,分析AI公司估值逻辑的变化与数据的审慎解读。