Datasette-MCP 0.2发布:首个稳定版本带来SQL返回格式优化
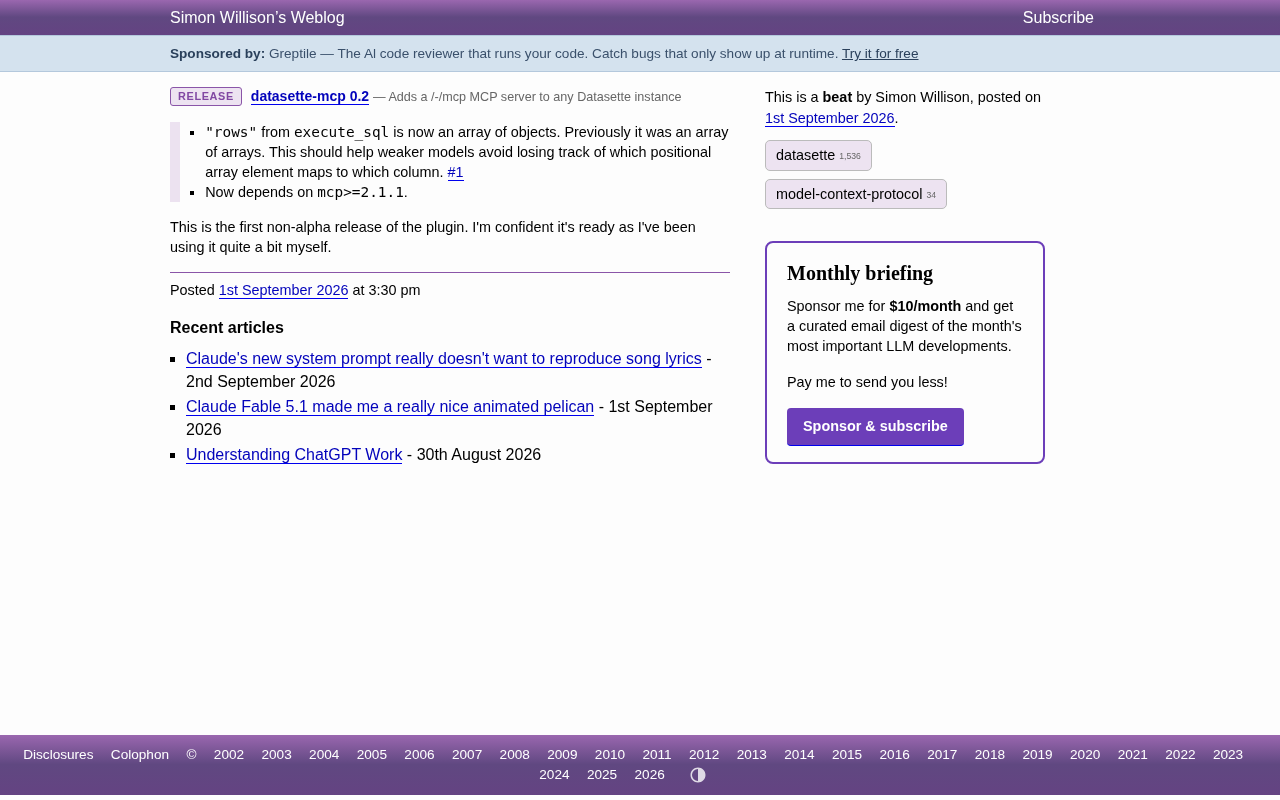
Datasette-MCP 正式发布稳定版
Datasette-MCP 经历了一段时间的 alpha 测试后,终于迎来首个非 alpha 版本 0.2 的正式发布。这款插件是 Datasette 生态系统与 Model Context Protocol(MCP)整合的关键工具,让 AI 模型能够更便捷地访问和操作结构化数据。
什么是 Model Context Protocol?
Model Context Protocol(MCP)是由 Anthropic 在 2024 年底推出的一项开放标准协议,旨在为大语言模型(LLM)提供一种统一的方式来连接外部数据源和工具。
在 MCP 出现之前,每个 AI 应用与外部系统的集成都需要定制化的 API 对接方案,导致开发碎片化严重。举例来说,如果你想让 AI 助手访问数据库、文件系统和网络 API,就需要为每种数据源编写专门的集成代码,这些代码之间缺乏统一标准,维护成本极高。
MCP 采用了类似 USB-C 的设计理念——一个标准接口兼容所有设备。协议定义了三种核心原语:Resources(资源,用于暴露数据)、Tools(工具,用于执行操作)和 Prompts(提示模板),AI 模型通过这些原语与外部系统交互。MCP 使用 JSON-RPC 2.0 作为通信协议,JSON-RPC 是一种轻量级的远程过程调用协议,它使用 JSON 格式编码请求和响应,相比传统的 REST API 更适合表达方法调用语义。MCP 支持 stdio(标准输入输出流)和 HTTP+SSE(Server-Sent Events,服务器推送事件)两种传输方式,前者适合本地进程间通信,后者适合网络环境下的实时数据推送。
目前 Claude Desktop、Cursor、Windsurf 等主流 AI 客户端已原生支持 MCP,生态系统正处于快速扩张期。
核心更新:execute_sql 返回格式从数组改为对象
此次更新最重要的改进在于 execute_sql 方法的返回格式调整。0.2 版本中,"rows" 字段从原来的数组嵌套数组结构(array of arrays)改为了对象数组结构(array of objects)。
这一改动看似简单,对 AI 模型的实际使用体验却有明显提升。要理解这一改动的意义,需要了解两种数据格式的具体差异:
数组嵌套数组形式如 [[1, "Alice", 30], [2, "Bob", 25]],需要配合单独的 columns 字段(如 ["id", "name", "age"])才能理解每个位置的含义,是一种位置依赖的格式。这种格式在传统编程中被广泛使用,因为它数据体积小、解析速度快——列名只需要传输一次。但这种优势在 AI 场景中反而成为劣势。
而对象数组形式如 [{"id": 1, "name": "Alice", "age": 30}, {"id": 2, "name": "Bob", "age": 25}],每条记录都是自描述的键值对。虽然对象数组存在键名重复带来的体积膨胀(在大数据集中可能增加 30-50% 的数据量),但它的可读性和容错性远胜前者。
对于大语言模型来说,对象数组的自描述特性至关重要——模型在生成响应时不需要维护一个位置到列名的映射表。大语言模型是基于 Transformer 架构的神经网络,它通过注意力机制处理输入序列。当数据以对象数组形式呈现时,每个 token(如 "name": "Alice")都包含了语义信息,模型可以直接通过键名理解数据含义。而数组嵌套数组要求模型跨越较长的上下文距离,将数组开头的列名定义与后续的数值关联起来,这种长距离依赖容易导致注意力权重分散。
尤其在长上下文对话中,这种显式标注能显著减少模型产生的幻觉和列名混淆错误。传统的数组嵌套数组结构要求模型记住每个位置索引对应的列名,在处理复杂查询结果时容易出现混淆。而对象数组结构直接使用键值对,每个数据字段都带有明确的列名标识,大幅降低了模型「丢失」列映射关系的风险。
这一优化对能力较弱的 AI 模型尤其友好,使它们在处理数据库查询结果时表现更加可靠。
依赖升级与稳定性保障
除了返回格式的改进,0.2 版本还将底层依赖升级到 mcp>=2.1.1,确保插件能够使用 Model Context Protocol 的最新特性,同时获得更好的稳定性和性能表现。
作者 Simon Willison 表示,经过自己大量的实际使用验证,已经对这个版本的稳定性有充足信心,因此决定将其从 alpha 状态推进到正式发布。
在开源软件发布实践中,从 alpha 推进到正式发布是一个重要的信号。软件版本管理通常遵循语义化版本控制(Semantic Versioning,简称 SemVer)规范,版本号格式为 MAJOR.MINOR.PATCH(主版本号.次版本号.修订号),可附加 alpha、beta、rc(release candidate)等预发布标识。Alpha 版本通常表示功能尚未完全稳定,API 可能发生破坏性变更,仅适合早期试验者使用,主要用于内部测试或小范围验证。Beta 版本表示功能基本完成,但可能存在 bug,开放给更广泛的测试者。RC 版本则是正式发布前的最后验证阶段。
Datasette-mcp 从 0.1a 系列跃升到 0.2,虽然仍处于 0.x 阶段(语义化版本控制中表示初始开发期,此阶段 API 尚未稳定,任何次版本号变更都可能引入破坏性改动),但移除 alpha 标签意味着项目维护者对 API 稳定性做出了承诺——至少在 0.2.x 系列内不会有破坏性变更。
值得注意的是,pip(Python 的包管理器)默认不会安装带有 alpha/beta 标签的预发布版本,用户必须显式添加 --pre 参数才能安装预发布版。因此这一变更也意味着普通用户通过 pip install datasette-mcp 就能直接获取到最新版本,无需额外添加 --pre 参数,大大降低了普通用户的使用门槛。
Datasette 与 MCP 协议的深度整合
Datasette 是一款强大的开源工具,专门用于探索和发布结构化数据。它由 Simon Willison(Django 框架的联合创始人之一,Django 是 Python 生态中最流行的 Web 框架)于 2017 年创建,最初是为了简化数据新闻工作者发布和探索数据集的流程。数据新闻(Data Journalism)是一种新兴的新闻报道形式,记者需要频繁处理政府公开数据、统计报告等结构化数据集,传统的数据库部署和 API 开发流程过于繁琐,Datasette 应运而生。
Datasette 的核心理念是将 SQLite 数据库文件直接变成可浏览、可查询的 Web API。SQLite 是一个嵌入式关系型数据库,以单文件形式存储,无需独立的数据库服务器进程,这使得数据库文件可以像文档一样被复制、分享和版本管理。Datasette 强调「不可变数据」的设计哲学——将数据打包为只读的 SQLite 文件,通过 Web 界面提供 SQL 查询、自动 JSON API、数据可视化等功能。这种不可变设计确保了数据的可重复性和可审计性,特别适合科学研究和新闻报道等需要数据溯源的场景。
Datasette 拥有丰富的插件生态,支持数据导入(CSV、JSON、Excel 等格式)、认证授权(OAuth、JWT)、可视化(图表、地图)、导出(多种格式)等数百种扩展功能,被广泛用于政府开放数据门户、新闻调查项目、个人知识管理等场景。例如美国多个州政府使用 Datasette 发布新冠疫情数据,ProPublica 等知名调查新闻机构使用它发布调查数据集。
Model Context Protocol 则是让 AI 模型与外部工具和数据源交互的标准协议。两者结合为 AI 应用开发者提供了一个优雅的方案:datasette-mcp 作为桥接插件,将 Datasette 管理的所有数据库自动暴露为 MCP 工具,使得任何支持 MCP 的 AI 客户端都能直接对这些数据执行 SQL 查询,无需额外的适配工作。这种架构的优势在于关注点分离——Datasette 负责数据管理和查询执行,MCP 负责标准化的 AI 交互接口,datasette-mcp 则作为胶水层完成协议转换。
这种整合在实际应用中有广泛的落地场景,例如:
- AI 助手查询业务数据来回答用户问题(如客服机器人查询订单数据库)
- 数据分析场景中让 AI 模型自主探索数据集(AI 可以自动生成 SQL 查询来回答分析问题)
- 构建数据驱动的 AI 应用,无需手动编写查询逻辑(降低开发门槛)
- 将 CSV、JSON 等文件通过 Datasette 转化为 SQLite 数据库后,立即提供给 AI 模型进行分析(几分钟内即可将静态数据变为 AI 可查询的资源)
对开发者的实际意义
对于使用 Datasette 的开发者来说,datasette-mcp 0.2 的发布意味着可以更放心地将其集成到生产环境中。返回格式的改进让 AI 模型的输出更可预测,减少了错误处理的复杂度。
同时,这也是开源社区快速响应实际需求的典型案例。从 GitHub issue #1 提出问题到 0.2 版本完成改进,体现了开源项目敏捷迭代的优势。
随着 Model Context Protocol 生态的不断成熟,类似 datasette-mcp 这样的桥接工具将在 AI 应用开发中扮演越来越重要的角色。MCP 的设计初衷就是消除 AI 模型与外部数据之间的集成壁垒,而 datasette-mcp 正是这一愿景的具体实践——它让开发者只需几行配置就能将任意结构化数据暴露给 AI 模型,帮助构建更智能、更数据驱动的应用系统。
相关推荐
本地部署私人DeepSeek全攻略:联网+知识库+隐私安全
手把手教你用Ollama、Chatbox、AnythingLLM搭建纯本地、可联网、带知识库的私人DeepSeek。涵盖蒸馏版模型选择、RAG知识库原理与API调用,隐私安全零门槛部署全流程干货。
AI Agent开发四阶段学习路线:从入门到企业级实战
AI Agent开发零基础学习路线全解析:从核心概念、ReAct范式,到多智能体协作、Prompt调优与企业级实战项目,系统掌握规划、记忆、工具调用、RAG与MCP,帮你少走弯路成为AI核心人才。
DeepSeek Harness 新玩法:Agent 监督 Agent 的自进化实验
一位 B 站 UP 主基于 DeepSeek Harness 实现「Agent 监督 Agent」的自进化实验:用官方原版 DSH 作稳定监督者,驱动自研 Agent 完成任务并自动修复 bug,配合台账机制和 CDP、Chrome DevTools MCP 实现近乎无人值守的软件迭代。