Deepgram 语音AI优化:Nova-3 移植 AWS Trainium2 实战
Deepgram 将 Nova-3 移植到 Trainium2,通过内核调优与自研运行时大幅降低批量转写成本。
Deepgram 与 AWS Forward Deployed Engineering 团队合作,将旗舰语音转文本模型 Nova-3 从 GPU 迁移到 AWS Trainium2 芯片,用于离线批量推理。工作分三个层面:首先通过 AWS Neuron SDK 完成推理图移植,处理自定义算子的数值正确性与回退;其次深入内核级调优,针对音频特征提取和注意力计算重写预处理逻辑、调整分块与流水线策略以缓解内存带宽压力;最后用 Rust 自研数据并行运行时,支持动态批处理与跨节点线性扩展。虽然官方未公布精确数字,但批量转写吞吐显著提升、单位成本明显下降,验证了专用 AI 芯片在语音批量推理场景的可行性。
语音 AI 公司 Deepgram 与 AWS Forward Deployed Engineering 团队合作,将其最新的 Nova-3 语音转文本模型移植到 AWS Trainium2 芯片上,用于离线批量推理。这项工作不仅涉及从 GPU 到专用 AI 芯片的代码迁移,还深入到内核级调优和自研数据并行运行时,最终在吞吐量和成本上取得了显著收益。对于关注 AI 基础设施和语音技术落地的团队来说,这是一次难得的全栈优化案例。
为什么选择 Trainium2 做批量推理
Deepgram 的 Nova-3 是其旗舰级语音识别模型,支持多语言、高准确率和低延迟的实时转录。但随着客户对历史音频批量转写需求的增长,推理成本成为关键瓶颈。AWS Trainium2 是专为机器学习训练和推理设计的加速芯片,单位算力成本低于通用 GPU,尤其适合大规模、可容忍一定延迟的批处理任务。
Deepgram 与 AWS 团队的目标很明确:在保持模型精度的前提下,将 Nova-3 的批量推理吞吐量提升数倍,同时降低单次转写的计算成本。这需要解决三个层面的问题:软件栈适配、计算内核优化以及运行时调度。
Trainium2 是 AWS 自研的第二代机器学习加速芯片,采用 NeuronCore-v3 架构,单芯片提供更高的大容量高带宽内存(HBM)与更高的 FP8/BF16 算力密度。与通用 GPU 不同,它针对大规模矩阵运算做了专门的数据通路优化,并通过 NeuronLink 支持多芯片互联,便于构建大吞吐推理集群。其成本优势主要来自两方面:一是芯片本身按性价比设计,二是以 AWS 云服务形式提供,省去自建 GPU 集群的采购与运维开销。对批量推理而言,它允许以稍高的单请求延迟换取更高的整体吞吐,这正是离线转写场景所需要的取舍。
移植到 AWS Neuron 软件栈
Trainium2 通过 AWS Neuron SDK 提供编程接口,支持 PyTorch 和 TensorFlow 等主流框架。Deepgram 的第一步是将 Nova-3 的推理图从原先的 GPU 环境迁移到 Neuron 栈。这并非简单的重新编译——语音模型包含大量自定义算子(如卷积、注意力变体和音频特征提取层),需要逐一验证其在 Neuron 上的数值正确性和性能表现。
团队利用 Neuron 的图编译器对模型进行算子融合和内存规划,并针对 Trainium2 的架构特点调整了张量布局。部分无法直接映射的算子则通过 Neuron 的自定义算子接口实现回退,保证模型功能完整。
AWS Neuron SDK 是访问 Trainium 和 Inferentia 芯片的官方软件栈,包含编译器(neuronx-cc)、运行时库和性能分析工具(Neuron Profiler)。它提供 PyTorch(torch-neuronx)和 TensorFlow 的适配层,开发者只需在原有框架代码中做少量替换,即可把计算图交给 Neuron 编译器进行算子融合、内存规划和指令调度。编译器会将图切分为可在 NeuronCore 上执行的子图,无法支持的算子则回退到 CPU 或通过自定义算子接口实现。理解这一「图编译 + 算子回退」的机制,是判断移植工作量与性能上限的关键。
内核级调优:榨取每一滴算力
移植只是起点,真正的性能提升来自内核级调优。Deepgram 工程师深入分析了 Neuron 内核在语音模型上的执行瓶颈,发现音频特征提取和注意力计算是主要热点。
针对音频前端,团队重写了部分数据预处理逻辑,使其更契合 Trainium2 的向量化指令;对于注意力层,则通过调整分块大小和流水线策略,减少了内存带宽压力。据原文披露,经过多轮调优,单芯片推理吞吐较初始移植版本有大幅提升,具体数字未公开,但足以支撑其批量转写服务的成本目标。
此外,团队还利用 Neuron 的性能分析工具定位了多个低效算子,并通过算子替换和融合将其从关键路径中移除。
内核级调优指的是在编译器生成的底层计算内核之上做进一步优化,而非停留在框架层调参。常见手段包括:调整矩阵乘的分块(tiling)尺寸以匹配芯片的片上缓存容量、重排数据布局以启用向量化指令、把多个小算子融合成一个大内核以减少内核启动与内存往返开销,以及用流水线(pipelining)掩盖访存延迟。语音模型的音频前端涉及大量非矩阵运算(如 STFT、梅尔滤波器组),这类负载往往难以被通用编译器高效映射,因此需要手写或改写内核,使其契合 Trainium2 的向量化与并行执行单元。
数据并行 Rust 运行时
批量推理的另一个挑战是任务调度。Deepgram 没有依赖现成的推理服务器,而是用 Rust 构建了一个轻量级的数据并行运行时,负责将海量音频文件切分、分发到多个 Trainium2 实例,并聚合结果。
Rust 的选择兼顾了性能与内存安全:运行时需要处理高并发的文件 I/O 和网络通信,同时保证长时间运行的稳定性。该运行时支持动态批处理(dynamic batching),根据队列长度自动调整批次大小,以充分利用芯片算力。数据并行策略则让多个 Trainium2 节点协同工作,线性扩展吞吐能力。
动态批处理(dynamic batching)是一种在推理服务中聚合请求的调度策略:系统维护一个请求队列,在极短的时间窗口内把多条待处理请求拼成一个批次送入芯片,从而摊薄单次前向计算的开销、提高芯片利用率。窗口长度与最大批次大小需要权衡——窗口越长、批次越大,吞吐越高,但排队延迟也越大。对离线批量转写而言,延迟容忍度高,因此可以采用较大的批次和激进的聚合策略。数据并行则是指在多个芯片或节点上复制模型、各处理不同数据分片,从而近似线性地扩展总吞吐,与模型并行(切分单个模型)形成互补。
吞吐与成本结果
虽然 Deepgram 和 AWS 没有公布精确的 benchmark 数字,但官方博客明确表示,迁移到 Trainium2 后,Nova-3 的批量转写吞吐量显著提升,单位音频处理成本明显下降。这一结果使得 Deepgram 能够以更具竞争力的价格提供大规模离线转录服务,同时为未来更大模型的部署预留了算力空间。
从技术角度看,这次合作验证了 Trainium2 在语音 AI 批量推理场景的可行性,也为其他希望摆脱 GPU 依赖、优化推理成本的团队提供了一条可参考的路径:从 Neuron 栈移植开始,深入内核调优,再配合自研调度运行时,逐步释放专用芯片的潜力。
对语音 AI 基础设施的启示
Deepgram 的案例表明,专用 AI 芯片的落地不是「即插即用」,而是需要模型、编译器和运行时三者的协同设计。对于推理负载相对固定、批量规模大的场景,投入工程资源做芯片级优化可以换来可观的长期成本收益。随着 Trainium 生态的成熟,语音、推荐、视觉等领域的批量推理有望迎来更多类似的优化实践。
相关推荐
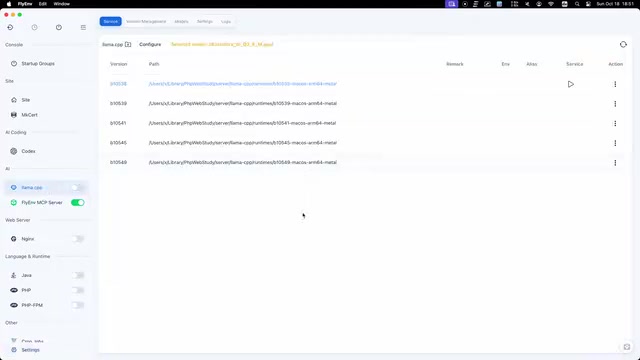
FlyEnv 插件实测:可视化运行 llama.cpp 与 GGUF 模型管理
FlyEnv 推出 llama.cpp 官方插件,提供多个 Metal 运行时并存管理、公共 GGUF 仓库索引与模型文件类型标注,以及上下文、线程、GPU 层数等推理参数可视化配置,支持模板与投机解码随模型保存,一键启动本地 LLM 推理服务。
前端如何进阶AI智能体开发?从OpenClaw拆解系统级Agent架构
从B站公开课演示的OpenClaw出发,拆解系统级AI智能体的三层架构与通用公式,分析前端开发者基于TypeScript切入Agent开发的路径、插件化设计与安全记忆层难点,附面试回答框架。
WorkBuddy实战:AI Agent如何自动批量转换与归档文件
通过B站UP主珊瑶老师的实测,对比豆包与WorkBuddy在文件批量转换任务中的表现,解析AI Agent如何从“给方案”到“直接执行”,附完整操作流程与积分消耗参考。