DeepInfer开源:DeepSig生产级推理引擎深度解析
DeepSig以Apache 2.0开源生产级推理引擎DeepInfer,展示日处理155万亿Token的工程细节与离线局限。
DeepSig 将支撑其生产服务的高性能推理引擎 DeepInfer 以 Apache 2.0 许可证开源,代码基于 vLLM 并叠加 Flash MLA、Deep GMM、Deep EP 等自研内核,同时整合投机解码、SWA 有界重放与异步零开销调度等机制。生产数据显示单集群日处理 155 万亿 Token、缓存命中率 96%,负载明显偏向高上下文复用场景。文章指出,开源的核心价值在于把调度、缓存与内核效率这些“看不见的成本结构”摊开,供中小团队借鉴。但 DeepInfer 当前是离线引擎,缺少完整 KV 缓存系统、prefill/decode 分离与负载均衡,不能直接替代 vLLM 的生产部署,更适合作为推理内核与调度的参考实现。
DeepSig 将支撑其大规模生产服务的高性能推理引擎 DeepInfer 以 Apache 2.0 许可证开源,这在推理框架领域并不常见——多数厂商只公开模型权重,而把真正决定成本与延迟的工程细节留在内部。DeepInfer 的代码公开,意味着社区第一次能系统性地审视一个日处理 155 万亿 Token 的生产引擎是如何搭建的。
一个生产引擎的技术底座
DeepInfer 并非从零自研,而是基于 vLLM 构建,并在其上叠加了自研优化内核。当前版本聚焦离线推理,支持 DeepSig V4.1 Flash 模型,硬件层面兼容 NVIDIA SM10 GPU 与华为昇腾 950 NPU,双硬件路线的支持让它在国产算力适配上具备一定想象空间。
自研内核与关键机制
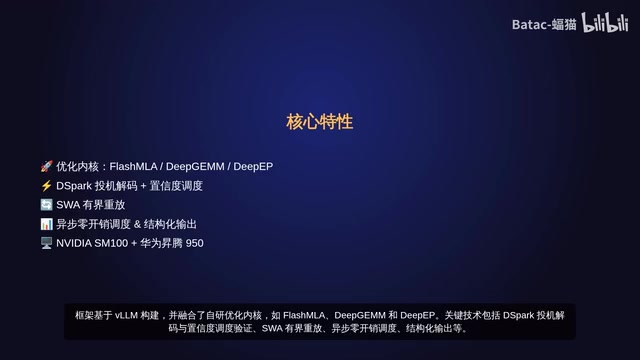
公开资料提到的核心组件包括 Flash MLA、Deep GMM 和 Deep EP 三类自研优化内核。围绕这些内核,DeepInfer 还整合了 DeepSpark 投机解码与一致性调度验证、SWA 有界重放、异步零开销调度以及结构化输出等机制。
从命名和功能组合来看,这套设计的重心在于"调度开销"与"验证成本":投机解码提升吞吐的前提是验证环节足够轻,而异步调度则试图把调度本身从关键路径上挪开。这些细节此前很少在生产引擎的开源实现中完整出现。
投机解码(Speculative Decoding) 是一种在不改变输出分布的前提下加速大模型生成的技术:先用一个轻量的小模型(或同一模型的多头)快速草拟若干候选 Token,再由大模型一次性并行验证这些候选,接受其中符合原分布的片段,拒绝的部分则回退重采样。它的吞吐收益高度依赖“验证成本”是否足够低——如果验证环节本身开销大,草拟带来的加速就会被抵消。DeepInfer 将其与“一致性调度验证”配套,正是为了在调度层面控制验证开销,使投机解码在真实负载下仍能兑现加速比。
SWA 有界重放(Sliding Window Attention, 有界重放) 指的是在滑动窗口注意力机制下,对窗口外的历史上下文进行有界长度的重放或保留,以在有限显存与计算预算内维持长上下文的一致性。它直接影响长对话与多轮场景的可用性,也是高缓存命中率能成立的前提之一——只有在窗口管理上有明确策略,前缀复用才不会因上下文截断而失效。
155万亿Token背后的生产数据
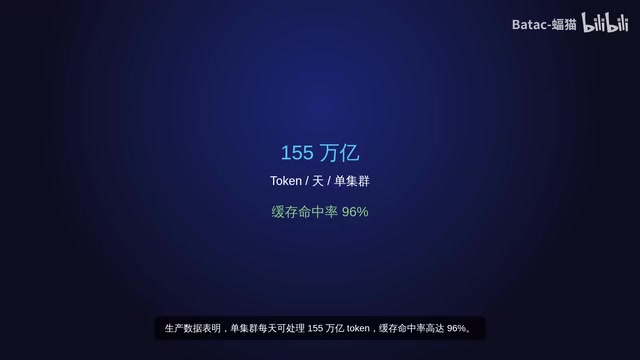
视频中给出的生产数据是理解 DeepInfer 定位的关键:单集群每天可处理 155 万亿 Token,缓存命中率达到 96%。
96% 的缓存命中率值得单独讨论。在真实服务中,高缓存命中通常来自前缀复用、系统提示共享以及多轮对话的上下文延续,这意味着 DeepInfer 的设计明显偏向"上下文高度重复"的生产负载,而非一次性、低重复度的请求场景。对于做 RAG、Agent 或长对话产品的团队,这类负载特征具有很强的参考价值。
前缀缓存(Prefix Caching)与缓存命中率 是理解 96% 这个数字的关键。在推理服务中,如果多个请求共享相同的前缀(如系统提示、少样本示例、多轮对话中已生成的历史),引擎可以把这段前缀对应的 KV 缓存复用,跳过重复的 prefill 计算。命中率越高,意味着越多 Token 的计算被省去,直接转化为延迟下降与 GPU 时节省。96% 的命中率说明 DeepInfer 面对的是前缀高度重复的负载,也说明其缓存淘汰与索引策略在生产规模下足够稳定;对于请求前缀各不相同的开放域场景,这一数字通常会显著下降。
开源的真正意义:把成本结构摊开
据视频作者的观点,DeepInfer 开源的重大意义在于让社区看到生产级推理引擎的内部实现,从而有助于降低算力成本、减少能耗,让 AI 更实惠。
这个判断有其道理。推理成本的大头往往不在模型本身,而在调度策略、缓存复用和内核效率这些"看不见的地方"。当这些实现被公开,中小团队不必重复试错,可以直接借鉴其中的调度与缓存思路,压缩自建推理服务的成本曲线。对一个日处理量以万亿 Token 计的引擎来说,哪怕几个百分点的效率改进,折算成电费和 GPU 时都是可观的数字。
局限同样明确:它是离线引擎
需要冷静看待的是,DeepInfer 当前版本是离线引擎,并不提供开箱即用的在线服务能力。视频明确指出,它缺少完整的 KV 缓存系统、prefill 与 decode 分离,以及负载均衡。
这三项恰恰是在线推理服务的核心拼图。缺少完整 KV 缓存系统意味着跨请求的上下文复用能力受限;缺少 prefill/decode 分离则难以针对两类负载分别优化资源配比;负载均衡的缺失则让它难以直接承载多副本、多实例的线上流量。换句话说,DeepInfer 更像是一份高质量的"推理内核与调度参考实现",而不是可以直接替代 vLLM 生产部署的成品。
对想要直接上线的团队,这意味着仍需自行补齐服务层;对想要研究生产引擎内部构造的工程师,这恰恰是它最有价值的部分。
Prefill/Decode 分离(PD 分离) 是在线推理服务的一项关键架构:prefill 阶段处理输入上下文、计算密集且呈大 batch 特征;decode 阶段逐 Token 生成、访存密集且对延迟敏感。两者对 GPU 资源的需求结构不同,混部在同一实例上会导致资源配比难以同时最优。PD 分离把两类负载拆到不同实例或不同卡组上,分别调优 batch 与并行策略,从而提升整体吞吐并压低尾延迟。DeepInfer 当前不提供这一能力,意味着它难以针对线上流量的混合特征做精细资源分配,这也是它被定位为离线引擎的重要原因之一。
后续演进与行业影响
DeepSig 承诺会将新模型的推理代码持续更新到该仓库。这一承诺如果兑现,DeepInfer 有可能演变为一个跟随模型迭代同步更新的推理参考库。
从生态角度看,一个由模型厂商开源、且直接来自生产环境的高性能推理引擎,会对现有推理框架格局形成压力:它既验证了 vLLM 作为底座的可扩展性,也展示了在 vLLM 之上做深度定制的上限。对于使用昇腾 NPU 的团队,DeepInfer 对 950 NPU 的支持也是值得跟踪的信号。
是否值得上手,取决于你的目标:想研究生产级推理的工程细节,它的参考价值很高;想立刻获得一个可承载线上流量的推理服务,它目前还缺关键组件,需要自建补齐。
相关推荐
AI Agent技能全指南:用Markdown打造稳健智能体
Google开发专家详解AI Agent技能机制:用Markdown文件固化重复指令与领域约定,通过技能创建器生成、评估对比验证、持续迭代,让Claude Code等智能体在正确时机加载正确上下文,打造稳健可靠的智能体工作流。
AI逆向工程新工具REA:让Claude克隆任意App
REA(Reverse Engineer Anything)是GitHub趋势榜第一的AI逆向工程工具,能让Claude Code等编程代理拆解任意App,复现功能,但也会触发安全拦截。本文详解其能力、限制与伦理边界。
如何为AI代理提供有效上下文?从简单开始,建立单一事实源
探索如何为AI代理提供有效上下文:从简单Markdown文件起步,逐步建立中央事实源,并在规模化时引入专业厂商。了解多代理协作中的上下文管理策略。