AlphaGenome Atlas详解:DeepMind如何用AI解码30亿碱基对
从基因组测序到精准预测
DeepMind近期发布了AlphaGenome Atlas,这是一个旨在解读人类基因组"生命语言"的综合性AI平台。来自埃克塞特大学的Gareth Hawkes博士指出,理解基因组就像理解生命的语言——我们需要读懂DNA的语义,并利用它来认识自身。人类基因组包含约30亿个碱基对,如果给每个碱基对一秒钟的时间,你需要花费数十年才能读完。
全基因组测序技术背景
全基因组测序(Whole Genome Sequencing, WGS)是一种能够一次性读取生物体全部DNA序列的技术。自2003年人类基因组计划完成以来,测序成本已从最初的27亿美元降至目前的数百美元,这得益于第二代测序技术(NGS)和第三代长读长测序技术的突破。第二代测序以Illumina的边合成边测序(Sequencing by Synthesis)技术为代表,通过大规模并行处理数百万条短读长片段(通常150-300bp),在数天内完成全基因组覆盖,准确率达99.9%以上。第三代测序则以Pacific Biosciences的HiFi测序和Oxford Nanopore的纳米孔测序为代表,能够产生数千甚至数万碱基的长读长,这对于解析基因组中的重复区域、结构变异和表观遗传修饰至关重要。值得注意的是,2022年T2T(Telomere-to-Telomere)联盟首次完成了人类基因组的完整无间隙组装,填补了此前约8%的序列空白,为变异注释提供了更完整的参考框架。这些技术已广泛应用于罕见病诊断、肿瘤基因组学和药物基因组学研究,是精准医疗的基础设施。
全基因组测序技术使我们能够测量人类基因组中的每一个碱基对,而研究的核心问题是:基因密码的变化如何影响人类的表型特征?这正是AlphaGenome Atlas试图回答的问题。
AlphaGenome模型如何将序列转化为影响力评分
AlphaGenome模型的工作原理是分析基因组序列片段,预测单个突变对该区域的影响。通过对"生命语言"进行建模,该模型能够判断某些基因突变是否具有潜在危害。从技术架构角度看,AlphaGenome采用了类似于大型语言模型的Transformer架构,将DNA序列视为一种"语言"——四种碱基(A、T、C、G)构成"字母表",基因调控元件构成"语法规则",而基因表达模式则是这种语言的"语义"。模型接收一段DNA序列作为输入,通过自注意力机制捕捉序列中远距离碱基之间的相互作用关系(这在生物学上对应于增强子-启动子互作等远程调控),最终输出该序列区域在不同细胞类型和生物学过程中的多维功能预测。
Transformer架构在基因组学中的适配
AlphaGenome采用的Transformer架构最初由Google在2017年的论文《Attention Is All You Need》中提出,用于机器翻译任务。其核心的自注意力(Self-Attention)机制允许模型在处理序列时,让每个位置都能"关注"序列中其他所有位置,从而捕捉长距离依赖关系。在基因组学场景中,这一特性至关重要:人类基因组中的增强子可能位于其靶基因上游或下游数十万甚至上百万碱基对之外,通过染色质三维折叠实现物理接触并调控基因表达。传统的卷积神经网络(CNN)受限于固定的感受野大小,难以建模如此远距离的相互作用。DeepMind此前的Enformer模型已展示了Transformer在基因组序列建模中的威力,其有效输入窗口达到约200kb。AlphaGenome很可能在此基础上进一步扩展了上下文窗口,并引入了更高效的注意力变体(如稀疏注意力或线性注意力)以应对超长序列带来的二次方计算复杂度问题。
然而,一个关键挑战随之而来:如何将海量预测整合成一个可操作的数值?
AVI(AlphaGenome Variant Impact)评分应运而生。AVI是一个衡量基因变异有害程度的单一数值——评分越高,该变异对表型(如疾病风险)产生影响的可能性就越大。DeepMind团队已经为人类基因组中所有90亿种可能的单碱基变化预先计算了AVI评分。
单碱基变异的生物学意义
单碱基变异(Single Nucleotide Variant, SNV)是指基因组中单个核苷酸位置发生的替换,是人类遗传变异最常见的形式。每个人的基因组相比参考序列约有400-500万个SNV,其中绝大多数是中性或良性的。从进化角度看,这些变异是自然选择的"原材料"——中性变异通过遗传漂变在群体中随机波动,而有害变异则受到净化选择的压力倾向于被清除。
然而,某些关键位置的单碱基改变可能导致蛋白质结构或功能异常,引发疾病。在编码区,变异可能是同义突变(不改变氨基酸)、错义突变(改变氨基酸)或无义突变(产生提前终止密码子)。例如镰刀型贫血症就是由血红蛋白β链基因第6位密码子从GAG突变为GTG(谷氨酸→缬氨酸)造成的,这个单碱基改变使红细胞在低氧条件下变形为镰刀状。
更具挑战性的是非编码区变异的解读——人类基因组中约98.5%的序列不直接编码蛋白质,但其中包含启动子、增强子、沉默子等大量调控元件。非编码区变异可能通过改变转录因子结合位点、影响RNA剪接、破坏染色质三维结构等机制间接导致疾病,但这些效应通常更微妙、更难预测。全基因组关联研究(GWAS)发现的疾病相关位点中,超过90%位于非编码区,这恰恰是AlphaGenome等深度学习模型最有潜力发挥作用的领域。
预测这90亿种可能变异的影响,相当于为每个基因组位点的每种可能改变(A/T/C/G的三种替换)都评估其后果,这是传统实验方法无法完成的海量任务。
AVI评分的统计学基础与临床应用前景
AVI评分的构建涉及将AlphaGenome输出的约10,000个多维预测(涵盖不同细胞类型的基因表达、染色质可及性、转录因子结合等生物学特征)压缩为一个标量值。这一过程需要解决特征加权和信息损失的权衡问题。从统计学角度看,这类似于主成分分析(PCA)或信息瓶颈理论中的降维操作——保留对致病性判断最具区分力的信号,同时过滤掉噪声。DeepMind可能采用了监督学习方法,利用ClinVar数据库中已知致病和良性变异作为训练标签,通过梯度下降优化评分函数使其在区分致病/良性变异上达到最优性能。
染色质可及性与表观遗传学的预测维度
值得特别说明的是,AlphaGenome输出的约10,000个预测维度中,染色质可及性是最关键的生物学特征之一。染色质可及性指的是DNA从核小体(由组蛋白八聚体和约147bp DNA缠绕而成的基本包装单元)中暴露出来、可被转录因子等蛋白质识别和结合的程度。实验上,染色质可及性通过ATAC-seq(转座酶可及性染色质测序)或DNase-seq等技术来测量——这些方法利用酶对开放染色质的优先切割或插入来标记可及区域。人类基因组在不同细胞类型中表现出截然不同的染色质可及性景观:神经元中开放的调控区域在肝细胞中可能被紧密包装而沉默,反之亦然。这正是同一套基因组能产生数百种不同细胞类型的分子基础。AlphaGenome能够从纯DNA序列预测不同细胞类型的染色质状态,意味着它已经隐式地学会了细胞类型特异性的表观遗传调控规则。
在临床应用层面,AVI评分需要与现有的ACMG/AMP变异分类标准(将变异分为致病、可能致病、意义不明、可能良性和良性五级)进行衔接。计算预测证据(PP3/BP4标准)是ACMG框架中重要的辅助判据,高AVI评分可作为支持变异致病性的计算证据。对于罕见病诊断而言,这一工具的价值尤为突出——全球约有3亿罕见病患者,其中约80%由遗传因素导致,但目前仅有不到一半能获得明确的分子诊断。AVI评分有望显著缩短诊断周期,尤其是在面对新发(de novo)变异或非编码区变异时,传统方法往往力不从心。
人口基因组学中心的基因组分析师Sam Bryan表示,基因组令人着迷之处在于,它在30亿个碱基对中分布着大量指令,但我们对其运作机制的了解仍然极为有限。AVI评分的设计初衷,就是将AlphaGenome输出的10,000个预测数值压缩为一个单一指标,帮助研究人员高效确定优先级。
变异效应预测的技术演进
变异效应预测经历了从基于保守性的简单算法到深度学习模型的演进。早期工具如SIFT(2001年)通过比较同源蛋白质序列的进化保守性来推断变异影响——如果一个氨基酸位置在数亿年进化中保持不变,那里的突变更可能有害。PolyPhen(2002年)则在保守性基础上加入了蛋白质三维结构特征,如变异位点是否位于活性中心或蛋白质界面。这两种工具准确率约70-80%,且只能评估蛋白质编码区的错义突变。
2014年发布的CADD(Combined Annotation Dependent Depletion)评分标志着方法论的重要转折。它基于一个巧妙的进化假设:在人类进化过程中未被固定下来的变异(模拟突变)与实际观察到的固定变异之间的差异,反映了自然选择的压力。CADD整合了63种不同的注释特征,首次能够同时评估编码区和非编码区变异,成为领域内广泛使用的标准工具。
近年来,基于蛋白质语言模型的ESM-1b(Meta AI)和基于DNA序列的Enformer(DeepMind)等深度学习方法进一步推动了性能边界。AlphaGenome代表了新一代方法的巅峰,它直接从DNA序列学习"语法规则",类似于自然语言处理中的大型语言模型。这种端到端的深度学习方法能捕捉远距离的调控关系(如相隔数十万碱基的增强子与靶基因的互作)和复杂的序列模式(如剪接调控中的组合密码),在预测非编码区变异影响方面尤其具有优势——这是此前所有方法的短板,也是基因组学中最大的未解问题之一。
AlphaGenome Atlas平台:PB级的基因组数据资源
AlphaGenome Atlas不仅仅是一个预测模型,更是一个全面的基因组数据平台。它可能是目前最全面、最准确的变异效应预测平台,包含约**1PB(1000TB)**的数据量。Atlas既是一个庞大的数据资源库,也提供了面向生物学家的Web访问界面。
PB级生物数据的存储与计算挑战
1PB(Petabyte)相当于1000TB或100万GB,足以存储约3亿人的全基因组数据。为了直观理解这一数据规模:如果将1PB的数据刻录到CD-ROM上,堆叠起来的高度将超过1.5公里。处理这样规模的数据需要分布式存储系统和高性能计算集群。DeepMind使用的基础设施可能包括Google Cloud的BigQuery用于数据管理,以及TPU(Tensor Processing Unit)集群用于AI推理。Google的TPU v4 Pod包含4096个TPU芯片,峰值算力可达1.1 ExaFLOPS,这种级别的计算资源是预计算90亿种变异评分的基础。
数据压缩技术至关重要——基因组数据通常使用CRAM或BCF等专用格式,可将原始数据压缩至原大小的1-5%。CRAM格式通过参考序列压缩(只存储与参考基因组的差异而非完整序列)实现了极高的压缩率,这一思路与视频编码中的帧间压缩异曲同工。对于AlphaGenome Atlas这样需要实时查询的平台,还必须在压缩率和访问速度之间取得平衡,通常采用分层存储策略:高频访问的热数据(如常见疾病基因区域的评分)存储在SSD上,低频访问的冷数据则归档到更经济的对象存储中。此外,针对基因组坐标的高效索引(如Tabix索引或区间树索引)是实现毫秒级区域查询的关键技术。
基因组浏览器与可视化技术
该平台内置了类似基因组浏览器的交互界面,研究人员可以从不同视角观察基因组中哪些区域被"点亮"。基因组浏览器的概念可追溯至2000年UCSC Genome Browser的发布——它首次允许研究人员通过Web界面在基因组坐标上叠加查看基因注释、保守性、表观遗传标记等多层信息。此后,Ensembl、IGV(Integrative Genomics Viewer)和WashU Epigenome Browser等工具各有侧重地丰富了基因组可视化生态。
AlphaGenome Atlas的浏览器在技术上可能采用了WebGL或类似的GPU加速渲染技术,以实现百万级数据点的流畅可视化。更重要的是,它展示的不再仅是实验观测数据,而是AI预测的"功能景观"——每个碱基位置的预测影响以热图或轨道的形式呈现,研究人员可以直观地识别功能热点区域。这种将AI预测结果与传统基因组注释无缝集成的设计,降低了使用门槛,使不具备深度学习专业知识的生物学家和临床遗传学家也能充分利用模型的预测能力。
正如研究团队所描述的,这就像"通过一扇新窗户观察基因组"——它开始成为一个蓝图,揭示每个碱基对(无论位于哪条染色体或与哪种细胞类型相关)如何精确地影响人类表型。
AI加速基因组学研究的新范式
AlphaGenome Atlas的深层意义在于,它正在构建一部"生命语言的词典"。通过缩小候选范围——用研究者的话说就是"让干草堆变小"——科学家更有可能找到那些真正导致疾病或影响性状的关键基因变异。这一比喻精准地概括了临床基因组学面临的核心瓶颈:一个典型的全基因组测序结果包含400-500万个变异,其中约2-3万个位于外显子区域,而最终致病的可能仅有1-2个。从数百万候选中筛选出关键变异,如同大海捞针。AVI评分通过为每个变异提供量化的优先级排序,可以将需要临床遗传学家手动审查的候选变异从数千个缩减至数十个,极大地提高了诊断效率。
AI驱动的生物医学智能体系统
DeepMind团队强调,AI正在从根本上改变科学研究的方式,使研究进展速度远超以往。他们正在开发更广泛的智能体框架,将AlphaFold、AlphaGenome等不同的专业化模型整合在一起,帮助科学家攻克人类面临的重大生物医学挑战。
DeepMind提出的智能体框架代表了AI应用的新范式——不再是单一模型解决单一问题,而是多个专业化AI系统协同工作。在这个框架中,AlphaFold(已预测了超过2亿种蛋白质的三维结构)负责蛋白质结构预测,AlphaGenome处理DNA序列分析,AlphaMissense(已对人类蛋白质组中7100万种可能的错义突变进行了致病性分类)预测错义突变影响,而AlphaFold 3则进一步扩展到蛋白质-DNA、蛋白质-RNA和蛋白质-小分子复合物的结构预测。
这种架构类似于生物学研究团队的分工:结构生物学家、遗传学家和计算生物学家各司其职但紧密协作。一个典型的协作场景可能是:AlphaGenome首先识别出一个高AVI评分的非编码区变异,分析表明它可能影响某个转录因子的结合;然后AlphaFold预测该转录因子的三维结构及其与DNA的结合模式;AlphaMissense评估该转录因子自身的编码区变异是否也可能导致功能障碍;最终,这些信息被整合形成完整的分子致病机制假说。
技术上,这需要统一的数据接口(如基于Protocol Buffers的标准化生物数据交换格式)、标准化的输出格式,以及一个中央协调系统来分配任务和整合结果。这种多智能体系统可能利用强化学习来优化不同模型的调用策略——例如,系统可以学习在何种情况下需要调用结构预测来辅助变异解读,在何种情况下直接的序列分析已经足够。这一框架对药物发现流程的影响尤为深远:从靶点发现(AlphaGenome识别致病变异)、靶点验证(AlphaFold确认蛋白质结构)到先导化合物设计(AlphaFold 3预测药物-靶点结合),AI有望将传统需要5-10年的早期药物发现阶段压缩至数月。
实验验证与群体多样性:迈向可信赖的临床应用
从更宏观的角度看,基因组学领域的每一步进展都可能产生深远影响。随着AlphaGenome Atlas等AI工具的不断完善,从DNA序列到疾病机制的认知路径正变得更加清晰,为精准医疗和个性化治疗开辟了切实可行的新方向。
这一愿景的最终实现还面临若干挑战。首先,模型预测需要更大规模的实验验证。MAVE(Multiplexed Assay of Variant Effect,多重变异效应检测)技术是近年来快速发展的高通量功能基因组学方法,也被称为深度突变扫描(Deep Mutational Scanning)。该技术的核心思想是在细胞中系统性地引入一个基因或调控元件的所有可能单碱基突变(利用饱和突变文库),然后通过功能性选择和高通量测序同时测量数千种变异的功能影响。例如,2018年Findlay等人对BRCA1基因的关键外显子进行了近饱和的功能评分,将该区域约4,000种变异从"意义不明"重新分类为功能正常或功能丧失。这类实验数据既可以直接用于临床变异解读,也是训练和验证AlphaGenome等计算预测工具的"金标准"。目前,Atlas of Variant Effects联盟正在协调全球努力,系统性地为人类基因组中所有临床重要基因生成MAVE数据,这将为AI模型的校准和基准测试提供前所未有的资源。
其次,不同人群的遗传多样性需要更充分的代表。截至2023年,GWAS研究中约86%的参与者具有欧洲血统,而非洲、南亚和拉丁美洲人群的代表严重不足。这种偏差不仅是公平性问题,更直接影响预测模型的准确性:不同人群经历了不同的进化历史和选择压力,等位基因频率、连锁不平衡模式和遗传结构存在显著差异。例如,非洲人群拥有最高的遗传多样性(作为人类起源地),许多在非洲人群中常见的变异在其他人群中极为罕见。如果AlphaGenome的训练数据缺乏这些人群的表型-基因型关联信息,其AVI评分在非欧洲人群中的预测准确性可能会打折扣,进而加剧精准医疗中的健康不平等。包括UK Biobank的多样性扩展计划、All of Us研究计划(目标招募100万美国人,强调多样性)和H3Africa计划等大型项目正在努力弥补这一差距。
此外,基因组数据的隐私保护和伦理治理框架也需要同步完善。但毫无疑问,AlphaGenome Atlas标志着我们距离真正"读懂"生命语言又迈进了关键一步。
核心要点
核心要点
核心要点
相关推荐
tiun.:为AI开发者打造的一站式认证与支付系统
登顶 Product Hunt 的 tiun. 为 AI 开发者提供认证、支付、账单、客户数据与分析的一体化系统,一条命令即可安装,帮助开发者当天上线付费产品。本文解析其定位、卖点与竞争格局。
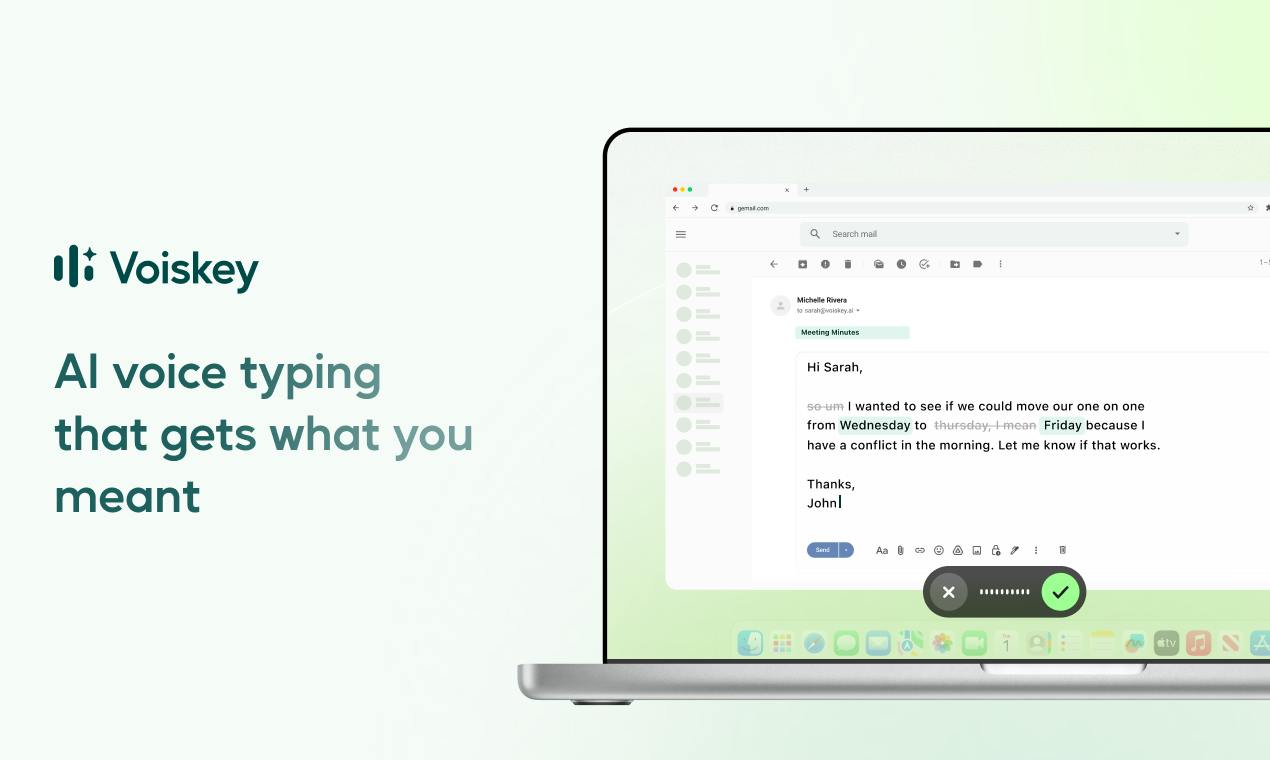
Voiskey:能读懂语境的AI语音输入工具
Voiskey是一款登上Product Hunt排名第3的AI语音输入工具,能根据场景和读者自动调整语气,比打字快5倍,支持iOS、macOS、Android、Windows四大平台及100多种语言。
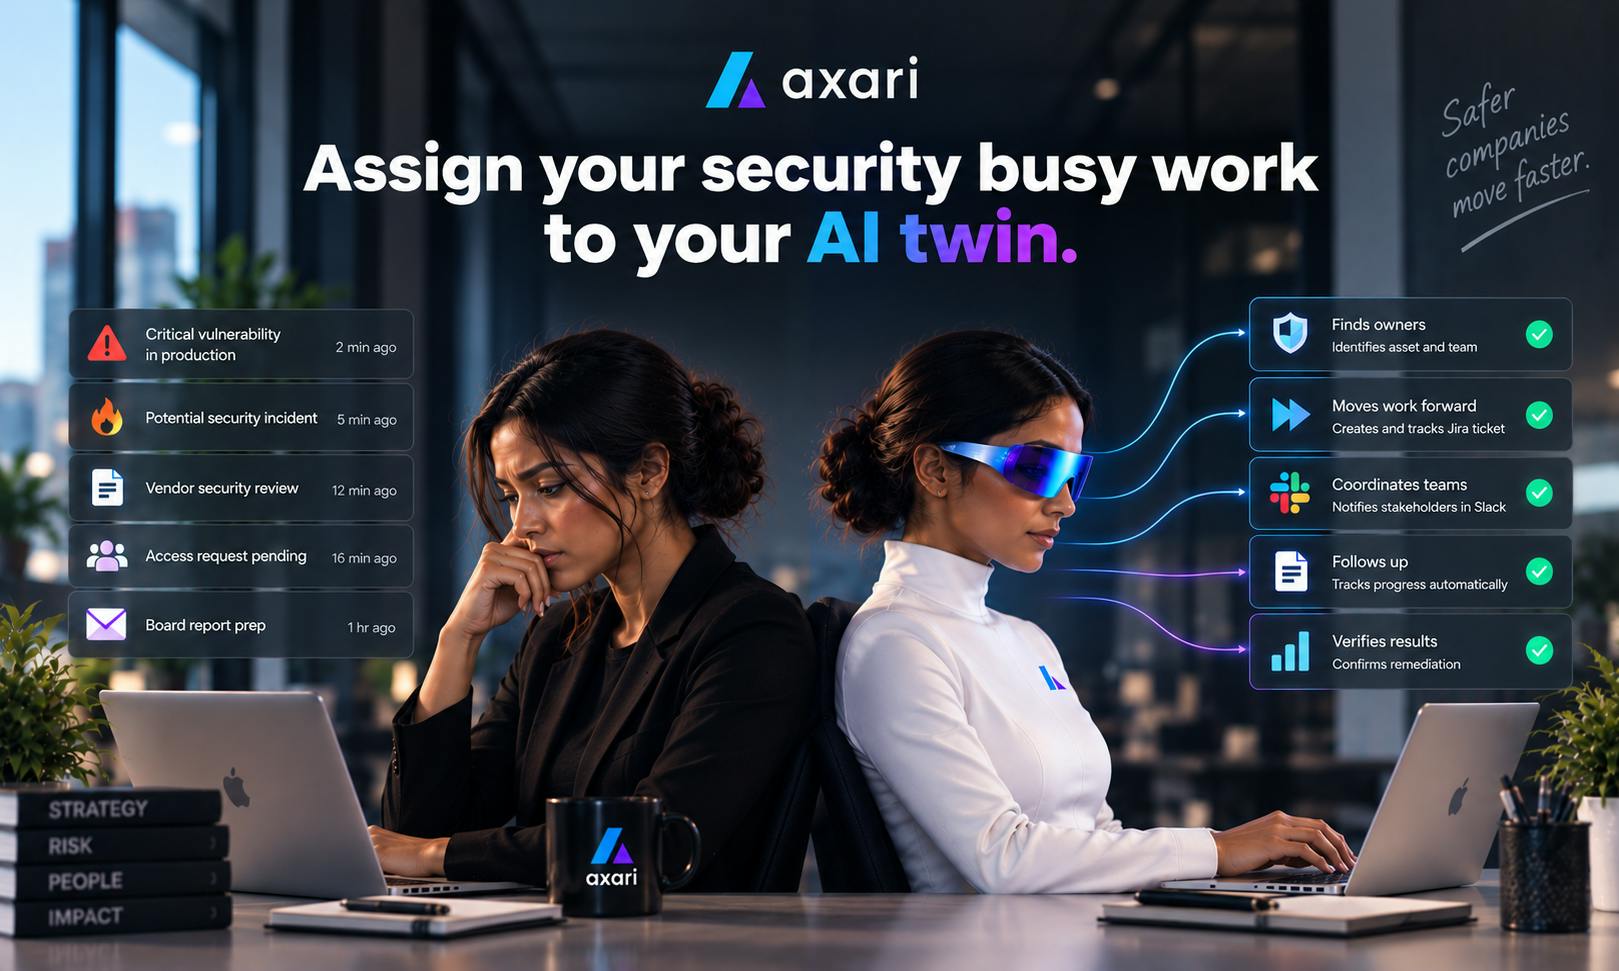
Axari:让AI分身接管你的安全运营琐事
Product Hunt新品Axari主打「AI分身」概念,帮安全团队自动处理重复性运营琐事,可在Slack、MS Teams中指派目标并自主推进任务。本文解析其产品逻辑、行业定位与需要冷静看待的问题。