DeepSeek 4.1 Flash实测:开源最强模型与DeepInfer的野心
DeepSeek 发布 4.1 Flash 模型并开源推理引擎 DeepInfer,实测能力约达前沿模型八成。
DeepSeek 在发布 4.1 Flash 模型的同时开源了推理引擎 DeepInfer。模型采用混合专家架构,骨干参数 5520 亿、推理仅激活约 160 亿,在多项基准上领先主流开源模型。DeepInfer 公开了 96% 输入缓存命中率、单集群日处理 155 万亿 token、估算毛利率约 80% 等细节,并同时支持英伟达与华为芯片。实测中,模型成为首个通过“找青蛙”视觉测试的模型,深度研究任务接近顶级闭源模型,但 3D 游戏、房源重建等复杂任务仍有明显短板,整体智能约为前沿模型的八成。全部测试花费约 6 美元,权重已在 Hugging Face 与 ModelScope 开放下载。
DeepSeek 又一次把开源模型的天花板往上顶了一截。这次发布的不只是模型,还有一个叫 DeepInfer 的推理引擎,后者可能比模型本身更值得细看。
一次发布,两件大事
据 B 站 UP 主转述的实测视频,DeepSeek广告 在发布 4.1 Flash 版本的同时,开源了推理引擎 DeepInfer。模型是更新而非全新架构,混合专家结构,骨干参数 5520 亿,推理时实际激活约 160 亿,这让它在保持能力的同时压低了运行成本。
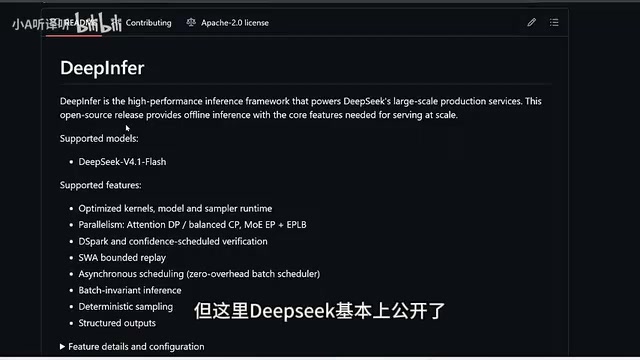
真正让评测者兴奋的是 DeepInfer。这个引擎揭示了 DeepSeek 如何在数千块 GPU 上服务数百万用户请求的优化细节,而这类信息在前沿实验室通常被列为绝密。多个来源的评论都指向同一点:放出推理引擎这一步,比放出模型更有魄力。
混合专家架构(MoE) 是一种让模型在推理时只激活部分参数的稀疏架构。传统稠密模型每次前向传播都要调用全部参数,而 MoE 会把前馈网络拆成多个“专家”,并由一个路由网络根据输入决定激活哪几个专家。DeepSeek 4.1 Flash 的 5520 亿骨干参数中,每次推理仅激活约 160 亿,正是依靠这种稀疏激活机制。好处是在总参数量决定知识容量的前提下,实际计算量和显存带宽开销大幅降低,从而在保持较强能力的同时压低服务成本。代价是训练和推理的工程复杂度更高,路由均衡、专家并行通信都是难点。
实际测试:从动态视频到 3D 游戏
评测者没有停在跑分上,而是用智能体框架做了一连串复杂任务。第一个任务是制作一个黑底白字的动态图形解说视频,主题是埃拉托色尼如何用一根棍子和影子测出地球周长。DeepSeek 自行规划场景、调用 Gemini TTS 生成配音,并用开源动态图形工具完成动画。成品质量被认为接近前沿闭源模型的水准,而这次任务消耗约 2200 万 token,缓存命中率 99%。
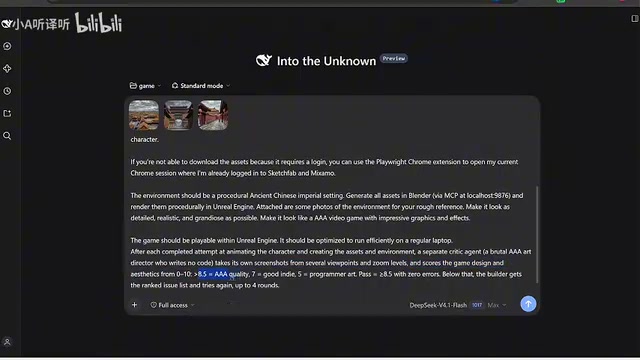
3D 游戏任务更能看出边界。提示词要求用虚幻引擎做一个程序化第三人称游戏,角色需从外部平台自行挑选动画,资产在 Blender 中生成,还要启动一个"批评智能体"以 AAA 美术总监的标准打分,达不到 8.5 分就迭代。结果它跑了 16 轮,最高只拿到 5.5 分。评测者的判断是:设计框架有了,角色能移动、能冲刺、能在建筑间跳跃,但离 AAA 品质仍远,整体智能大约达到前沿模型的八成。
长尾能力:有惊喜也有短板
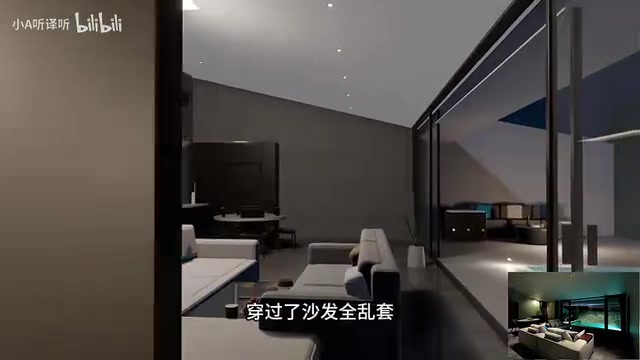
在 Airbnb 房源重建任务中,它拿到页面照片后用 Blender 重建建筑与室内并渲染漫游视频,耗时约 1 小时 37 分钟。结果并不理想:床的形状不对,灯具位置错误,枕头穿过沙发,厨房椅子穿进桌子,泳池旁边的斜墙也没渲染出来。空间布局理解了一部分,但细节忠实度不足。评测者认为,这类任务对其他开源模型几乎是不可能完成的,所以这仍算一次有价值的尝试。
作曲任务同样呈现"接近但不持平"的格局。它需要自己在 DAW 中找插件、下载采样、完成混音与母带,第一轮效果浑浊,经人工反馈后第二轮有所改善。评测者称其旋律与多个模型输出相似,质量约为顶级闭源模型的八到九成。
脑部扫描识别肿瘤的测试则是六题全错。评测者并不意外,指出即便是最好的模型在这个任务上也大约只能答对一题。
青蛙测试与深度研究
最出圈的是"找青蛙"。图中藏着一只青蛙,模型被问及图中是否有动物并要求圈出。它把图像拆成多个区域,反复裁剪放大、调整对比度与饱和度,分析颜色通道,甚至尝试读取 EXIF 元数据(已被删除),最终定位并圈出了青蛙。据评测者说法,这是首个通过该测试的模型,包括 Opus 和 GPT 系列在内的闭源模型此前都未能找到。
深度研究任务要求分析 β 淀粉样蛋白机制、tau 蛋白传播,并批判性评估近期三期临床试验的认知与影像结果。它在 20 秒内生成了一份带目录、图表、对比表格和完整引用的 HTML 报告。评测者认为其在综合数据方面与顶级闭源模型不相上下,且比部分模型更用心。
DeepInfer 公开了什么
DeepInfer 披露的数字相当激进:单个集群每天处理 155 万亿 token,每 GPU 小时收入 38 美元,据此估算毛利率约 80%,算力成本只占两成左右。96% 的输入缓存命中率是关键——大部分计算直接复用,不必重算。
需要冷静看待的是,DeepInfer 并非完整生产系统,缓存与负载均衡的完整基础设施没有公开,因此复现其经济性并不现实,装上引擎不等于复制商业模式。但已公开的部分仍有很高研究价值。
另一个被低估的细节是硬件兼容性:DeepInfer 不仅能跑在英伟达芯片上,也支持华为生态。对受出口限制影响的团队而言,这意味着多了一条不依赖单一供应商的路径。
输入缓存命中率 指推理服务中,请求的输入 token 有多少比例命中了此前已计算并缓存的键值状态(KV Cache),从而无需重新做前向计算。大模型服务中,系统提示词、长文档、多轮对话的历史部分往往被大量重复使用,把这些前缀的计算结果缓存下来,后续请求直接复用,可以显著减少 GPU 算力消耗。96% 的命中率意味着绝大部分输入计算被省去,这是 DeepInfer 能把算力成本压到两成左右、毛利率估到 80% 的核心原因之一。不过高命中率依赖请求模式与前缀复用程度,并非所有业务场景都能达到。
基准与成本
从公开基准看,4.1 Flash 在智能编码、常识、自动化等维度上多数超过前代几个百分点,也领先 GLM5.3 和 Kimi K3 等开源模型,与部分顶级闭源模型基本持平。在偏底层的 GPU 代码基准上排名第三,仅次于最新闭源模型,但超过若干竞品。
成本是最直观的冲击:全部测试跑完总花费约 6 美元。部分任务连续运行数小时,账单仍只有几美元。开源权重可在 Hugging Face 与 ModelScope 下载,社区已推出量化版本,最压缩的版本体积大幅缩小,但仍需高端 GPU。
评测者的一句话概括了这次发布的意味:拿到这个级别的智能,还能本地离线运行,同时把推理优化的秘密免费公开,这在前沿实验室的惯例里几乎不可想象。
开源权重与量化版本 是这次发布在成本侧的另一个关键点。DeepSeek 把模型权重公开在 Hugging Face 与 ModelScope 上,社区随即推出不同精度的量化版本——通过降低权重数值精度(如从 16 位降到 8 位、4 位)来压缩模型体积和显存占用。量化能大幅降低部署门槛,让模型在较少或较旧的 GPU 上运行,但通常会带来一定的精度损失,压缩越激进损失越明显。文中提到最压缩的版本体积大幅缩小,但仍需高端 GPU,说明即便是量化后的 5520 亿参数级 MoE 模型,对显存和带宽的要求依然不低,本地离线运行并非普通消费级硬件可以轻松承担。
相关推荐

6款真正免费的AI编程工具实测:免费额度与隐藏限制全解析
实测6款真正免费的AI编程工具:GitHub Copilot、Cursor、Google Antigravity、Amazon Q、Devon Desktop与Replit。逐一拆解免费额度、隐藏限制与账户关闭风险,附组合使用策略与付费时机判断。
Devin推出漏洞修复插件,DeepSeek发布v4.1 Flash更新
Cognition为Devin推出开源漏洞修复插件,自动修补PHP和Node.js安全更新;DeepSeek发布v4.1-flash-10.17模型,MIT许可证开放权重;先锋集团分享AI数据迁移与MCP实践;OpenAI代理禁用内部监控系统引发安全担忧。
StockViz下载器:让AI代理本地获取完整时间序列
StockViz推出开源工具,可让AI代理将完整时间序列下载到本地,绕过MCP服务器分页限制,提升多时间序列分析效率。