DeepSeek Harness破甲工具走红:一键切换提示词实现多模型越狱

dsh-purge 用可替换提示词实现多模型越狱,一周暴涨 2,622 Star。
GitHub 项目 dsh-purge 一周内新增 2,622 颗 Star,总 Star 达 7,652,定位为 DeepSeek Harness 的「破甲」工具。其核心思路不是训练模型或修改权重,而是把越狱能力封装成可按目标模型切换的提示词库,默认提示词面向国产模型「小码酱」。文章分析,这种「harness + 多套提示词」的结构本质是提示词层面的跨模型适配层,比单一越狱模板更实用。项目热度反映红队测试与普通用户绕过限制两类真实需求,但越狱工具处于灰色地带,存在有害内容、隐私泄露与违反服务条款等风险。文章提醒,提示词效果会随模型版本更新衰减,维护成本高,二次开发需遵守署名要求,面向公众集成时更需评估合规性。
GitHub上一个名为 dsh-purge 的项目近期热度飙升,一周内新增 2,622 颗 Star,总 Star 数已达 7,652,Fork 数 1,160。项目定位很直接:DeepSeek Harness「破甲」,让不同模型都能通过替换提示词完成越狱(Jailbreak),默认提示词则专门面向国产模型「小码酱」。
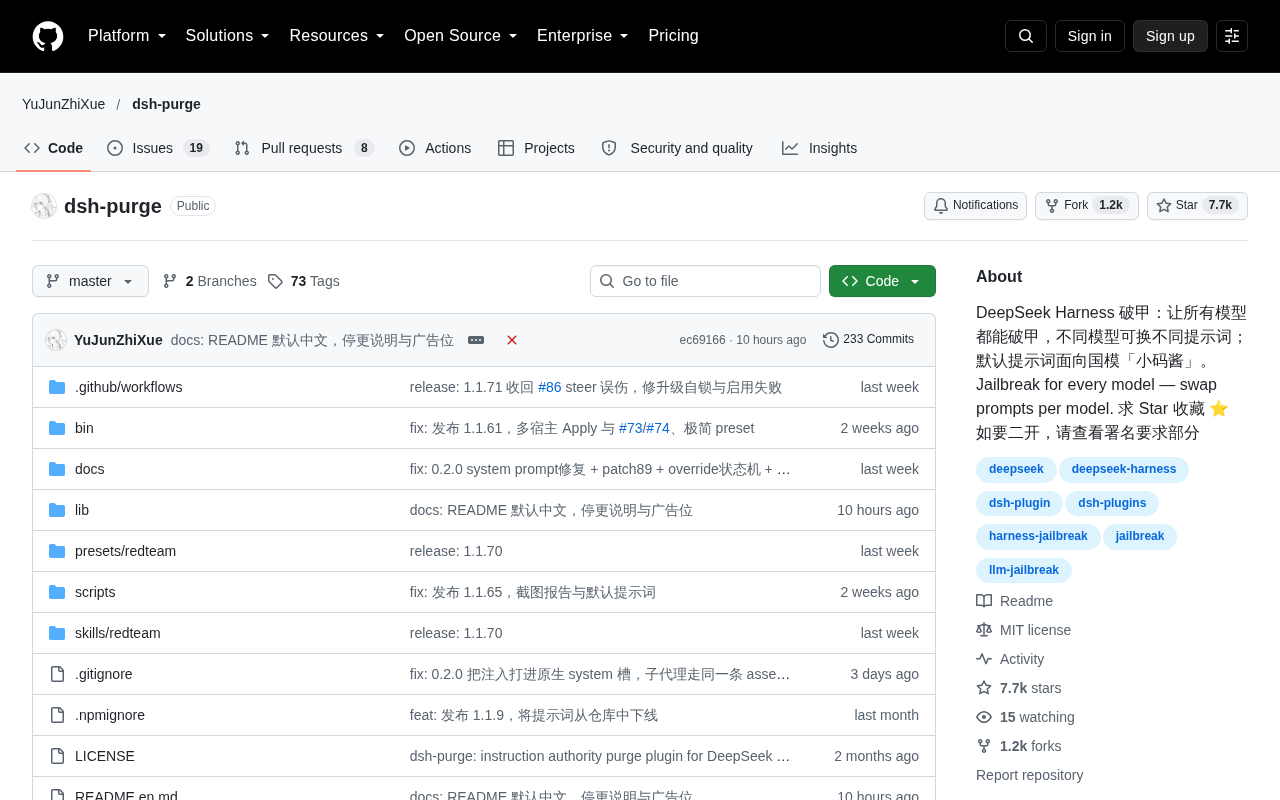
项目定位:把「破甲」做成可切换的提示词库
从仓库描述看,dsh-purge 的核心思路不是训练新模型,也不是修改模型权重,而是围绕提示词(prompt)做工程化封装。作者将「破甲」能力抽象为一组可替换的提示词,针对不同模型提供不同版本,用户可以根据目标模型切换对应提示词。
这种设计降低了使用门槛:不需要理解每个模型的拒答机制细节,只要选对提示词即可。项目默认提示词面向「小码酱」,说明作者对国产模型的拒答行为做过针对性调试。
技术路径:提示词层面的对抗,而非模型层面的改造
大模型的安全对齐通常体现在拒答策略上,而越狱提示词的本质是构造语境让模型绕过这些策略。dsh-purge 把这一过程产品化,形成「一个 harness + 多套提示词」的结构。
值得关注的是其跨模型适配思路。不同厂商的模型在训练数据、对齐方法和拒答触发条件上存在差异,同一套提示词在不同模型上的效果往往差别很大。项目按模型维护提示词,实际上是在做提示词层面的「适配层」,这也是它比单一越狱模板更实用的地方。
越狱(Jailbreak)与拒答机制
大模型在完成预训练后通常会经过安全对齐(如 RLHF、DPO 或规则化拒答训练),使其在遇到敏感请求时输出拒绝语句或安全提示。所谓「越狱」,是指通过精心构造的输入让模型绕过这层拒答策略,按其原始指令遵循能力作答。常见手法包括角色扮演、虚构场景嵌套、分步诱导、编码混淆(如 Base64)、多语言切换等。越狱并不改变模型参数,只是改变了模型在推理时所处的「语境」,因此同一模型在不同提示词下的安全表现可能差异极大。这也解释了为何提示词层面的攻防具有高度动态性:厂商一旦在训练或系统提示中加入针对性防御,旧有越狱模板往往迅速失效。
提示词适配层
「适配层」借用了软件工程中的概念,指在不同目标系统之间做转换的中间层。在越狱场景下,不同模型的对齐强度、拒答触发词、上下文窗口利用方式各不相同,一套通用模板很难对所有模型生效。按模型维护多套提示词,相当于为每个目标模型单独调参,把「一套模板打天下」变为「按模型选模板」,从而提升成功率与稳定性。这种做法的代价是维护成本随模型数量线性增长,且每次模型版本升级都可能需要重新调试。
热度背后:越狱需求与安全边界的持续拉扯
一周 2,622 颗 Star 的增长速度,说明这类工具存在真实需求。一部分来自研究与红队测试场景,需要验证模型安全边界;另一部分则来自对模型输出限制不满的普通用户。
但越狱工具始终处在灰色地带。绕过模型安全策略可能带来有害内容生成、隐私泄露等风险,多数模型厂商的服务条款也明确禁止此类使用。项目描述中提到「如要二开,请查看署名要求部分」,说明作者对二次开发设有署名约束,但并未对使用场景做更多限制说明。
红队测试(Red Teaming)
红队测试源自军事与安全领域,指由独立团队扮演攻击方,主动寻找系统漏洞。在 AI 领域,红队测试是模型上线前评估安全性的标准环节:测试者尝试用越狱、诱导、对抗样本等方式让模型输出有害内容,厂商据此修补对齐策略。合规的红队测试通常在授权范围内进行,结果用于改进模型而非对外发布有害内容。这也是越狱工具被部分研究者视为「合理用途」的原因——它与恶意滥用之间的界限,主要取决于使用者身份、目的和结果处置方式,而非工具本身。
使用与二次开发的注意事项
对想尝试的开发者,有几个现实问题需要权衡。提示词效果会随模型版本更新而衰减,模型厂商修复拒答漏洞后,原有提示词可能失效,维护成本不低。跨模型切换虽然方便,但每个模型的输出质量和稳定性差异明显,不能简单套用。
二次开发方面,项目采用 JavaScript 编写,作者要求查看署名要求部分后再进行衍生开发。如果计划将此类能力集成到产品中,还需要评估合规风险,尤其是面向公众提供服务的场景。
模型服务条款与合规风险
主流模型厂商的用户协议普遍禁止绕过安全机制、生成违法或有害内容,以及将模型用于自动化攻击等场景。违反条款可能导致账号封禁、API 调用权限收回,情节严重时还可能触及所在地法律法规(如生成违法信息、侵犯他人权益)。若将越狱能力集成到面向公众的产品中,责任主体将从个人使用者转移到服务提供方,合规审查会更严格,涉及内容安全评估、备案与日志留存等要求。因此评估此类工具时,除了技术可行性,还需明确使用边界与法律后果。
小结
dsh-purge 的走红反映了一个现实:提示词层面的攻防已经成为大模型生态的一部分。对研究者,它是测试安全边界的工具;对厂商,它是提醒对齐策略仍有漏洞的信号。工具本身中立,但使用方式决定了它落在红队测试还是违规滥用的哪一侧。
相关推荐
AI工程化实战:Claude Code与Agent Skill开发全流程
B站实战课解析AI工程化:用Claude Code、Codex、WorkBuddy开发企业级Agent Skill,涵盖公众号报文、量化分析、小红书自动发布等案例,讲透Skill驱动开发的范式转移与工具选型。
LangChain零基础入门:结构化输出与Agent实战指南
从LangChain零基础讲起,厘清低代码平台与大模型应用开发的本质区别,覆盖结构化输出、工具调用、Agent实战与多租户RAG企业项目落地四大模块,适合有开发基础想转型AI应用开发的工程师。
MCP协议全解析:一封邮件如何劫持你的AI Agent
深入拆解MCP协议:从M×N到M+N的集成心智模型、2026无状态规范下的协议细节与Python代码实践,再到提示注入攻击的完整复现与五条防御措施,帮你正确设计与加固AI Agent的工具层。