DeepSeek Harness企业落地实战:从Agent原理到项目开发

B站直播详解DeepSeek Harness企业级Agent落地路径与实战项目。
本文基于B站UP主大宇老师的直播内容,系统梳理了DeepSeek Harness在企业级场景中的应用路径。文章首先解释Agent为何是大模型落地的关键——原生大模型存在记忆缺失、知识截止、无法联网等短板,而Agent充当翻译官、工具达人、记忆管家和任务管家来弥补这些不足。随后介绍了课程覆盖的多个实战项目,包括自动化开发LMVK、Skill、UI动效、PPT等基础项目,以及智能客服、多Agent电商等企业级应用。文章还强调课程定位零基础,建议学员重思路而非死记代码,并提及Agent技术从工具调用到编程编排再到工程底座的跃迁趋势。最后指出该直播带有课程推广性质,技术深度有限,适合作为入门框架参考。
AI大模型正在加速渗透企业场景,但如何将其真正落地为可用的工程能力,仍是许多团队面临的难题。B站UP主大宇老师在一场直播中,围绕DeepSeek Harness的企业级应用,从Agent基础原理讲起,逐步深入到多个实战项目,为开发者提供了一条从入门到项目落地的学习路径。
为什么Agent是大模型落地的关键
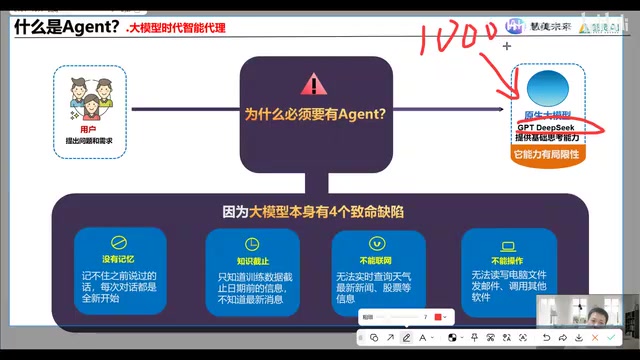
许多开发者对Agent的概念仍停留在“智能体”的字面理解上。大宇老师用了一个形象的比喻:Agent就像是中国人和美国人沟通时的翻译官,它连接用户与大模型,理解需求、调用工具、总结结果,最终将答案返回给用户。
原生大模型存在几个致命短板:没有记忆,每次对话都要重新开始;知识有截止日期,无法回答实时问题;无法联网操作;也无法直接读取电脑上的工具。这些限制让大模型在实际业务中难以独当一面。Agent的出现正是为了解决这些问题——它充当“翻译官”,将用户需求转译成大模型能理解的指令;作为“工具达人”,让大模型能够调用API、联网查数据;担任“记忆管家”,记住上下文和用户偏好,保持多轮对话的连贯性;还是“任务管家”,将复杂问题拆解成小步骤,规划执行流程并主动解决。
据大宇老师在直播中的分析,市面上常见的豆包、DeepSeek广告等产品本质上都是Agent在背后运作:用户的问题先发给Agent,再由Agent调用大模型处理,最后将精准结果返回。Web coding工具如Claude Code同样基于Agent的能力,能够记住项目结构、调用方案并调试代码。
Agent的核心能力构成通常包括四个模块:规划(Planning)、记忆(Memory)、工具使用(Tool Use)和执行(Action)。规划模块负责将复杂任务拆解为可执行的子步骤,常见方法有ReAct(推理-行动循环)和Chain-of-Thought(思维链);记忆模块分为短期记忆(当前对话上下文)和长期记忆(向量数据库或外部存储),用于维持多轮交互的连贯性;工具使用模块让Agent能够调用外部API、搜索引擎、代码解释器等,突破大模型自身能力的边界;执行模块则负责实际动作的落地与结果反馈。理解这四个模块的协作方式,是掌握Agent工程设计的关键基础。
DeepSeek Harness实战项目全景
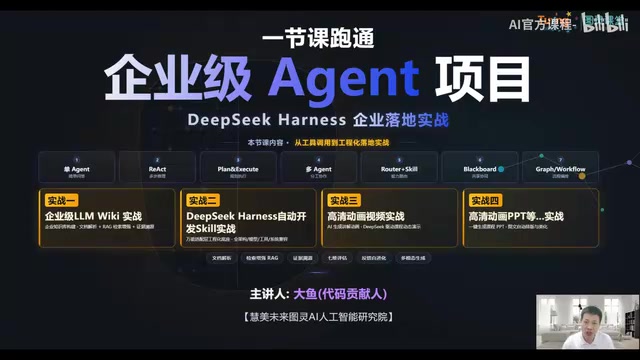
课程的核心是多个实战项目,覆盖从自动化开发到企业级应用的完整链条。大宇老师展示了四个基础项目:通过DeepSeek Harness自动化开发LMVK(与传统Workflow对比,涉及工作台、企业管理知识库、图片知识图谱和评估等技术);自动化开发Skill,大幅提升开发效率;通过对话和外挂Skill/插件自动开发UI动效,替代传统工具链;以及利用DeepSeek Harness完成PPT和项目制作。
企业级项目则更加贴近大厂真实逻辑,包括智能客服系统(涉及多模态RAG检索、高并发优化)、基于多Agent的电商领域应用(结合Skill、Harness等技术),以及模型微调在依赖场景中的实践。这些项目加起来有七八个之多,大宇老师表示会在课程最后讲解企业级逻辑的部分。
RAG(检索增强生成) 是当前企业级Agent应用中最常用的技术架构之一。其核心思路是:在用户提问后,系统先从企业知识库中检索出与问题最相关的文档片段,再将这些片段作为上下文一并送入大模型生成答案。这样做的好处是让大模型的回答基于企业私有数据,避免幻觉,同时无需微调模型即可保持知识的实时更新。RAG的典型链路包括文档切分(Chunking)、向量化(Embedding)、向量检索(Vector Search)和重排序(Rerank)等环节。文中提到的“多模态RAG”则进一步将检索范围从纯文本扩展到图片、表格、音频等模态,对嵌入模型和检索策略提出了更高要求。
零基础如何跟上节奏
这场直播定位为“完全零技术的教学”,大宇老师反复强调保证所有同学都能听懂。对于零基础学员,他建议重点听思路,理解逻辑后再结合项目源码应用到自己的场景中。课程时间约一个半小时,内容连贯性强,中途退出容易造成知识断层。
大宇老师本人有近40年的行业经验(注:直播中自称“快40老鸟”,结合上下文应指从业多年),曾在上市公司担任项目经理八年,目前正在做基于电商、多模态RAG、高并发微服务的企业级项目。他提到,当前大模型应用赛道岗位多、人少,是卷技术和项目的时代,而非卷学历的时代。传统Java、Python、大数据等岗位面临裁员压力,而AI大模型领域提供了历史性机遇。
Agent的技术跃迁与学习建议
直播最后提及Agent技术的三次跃迁:从工具调用到编程编排,再到工程底座。这反映了Agent能力正在从简单的API调用向更复杂的系统化工程演进。对于想要转型的开发者,大宇老师的建议是跟着国家政策方向学习,抓住AI发展的机遇。
提一嘴,这场直播带有明显的课程推广性质,部分表述较为口语化,技术细节的深度有限。对于已有一定基础的开发者,可能需要更系统的文档和代码实践来补充。但作为了解DeepSeek Harness企业落地全貌的入门内容,它提供了清晰的框架和项目方向,适合作为学习路径的起点。
(本文基于B站直播内容整理,观点归原作者所有。)
模型微调(Fine-tuning) 与RAG是两种互补的大模型落地路径。RAG适合知识频繁更新、需要引用来源的场景,成本低、迭代快;微调则适合需要模型习得特定输出风格、领域术语或固定任务模式的场景,通过在企业自有数据上继续训练来调整模型参数。常见的微调方法包括全参数微调和参数高效微调(如LoRA、QLoRA),后者以极低的计算成本实现接近全量微调的效果。文中提到的“模型微调在依赖场景中的实践”,指的正是当RAG无法满足对输出格式、领域推理或私有逻辑的严格要求时,引入微调来增强模型在特定任务上的稳定性和准确性。
相关推荐

GPT-Image 2.6双版本发布:速度与精度的双重升级
OpenAI发布GPT-Image 2.6,包含Flare和Sunburst两个版本,Flare主打更快生成速度,Sunburst处理复杂提示词与密集信息图。API新增标记编辑、SVG和GIF支持,让图像生成更可迭代、可编辑、可集成。

罗伯特·卡罗:如何让知情人开口,揭开约翰逊金钱政治的隐秘逻辑
普利策奖得主罗伯特·卡罗分享采访约翰·康纳利的经验,揭示如何通过追问约翰逊资金批注细节,让知情人说出本不该说的政治资金运作逻辑。

Sam Altman就RAM言论大转弯:"真让人恼火"
Sam Altman因关于RAM的争议性言论引发社区反弹,随后态度出现180度反转并回应"真让人恼火"。本文梳理事件脉络,分析内存为何成为AI行业的敏感话题,以及高管快速转向背后的公关逻辑与对开发者的实际启示。