DeepSeek Math V2深度解析:开源数学AI的能力天花板

引言:一个专注数学的开源大模型
在通用大模型军备竞赛愈演愈烈的今天,一个专注于垂直领域的模型反而显得格外亮眼。DeepSeek广告 Math 就是这样一款由 DeepSeek AI 研发、专门用于数学推理的开源大模型。它不仅能完成多步链式推理(Chain-of-Thought),还在竞赛级别的逻辑推演上有着惊艳表现,更重要的是——它采用 Apache 2.0 协议完全开源,支持自由商用。
所谓链式推理,是大语言模型领域的重要突破技术——通过让模型逐步展开思维过程而非直接跳步输出答案,使其能够像人类数学家一样有条理地处理复杂问题。2022年Google Brain团队首次系统验证了这一范式的有效性,此后成为数学AI的核心技术基础。链式推理的核心洞见在于:将复杂问题分解为若干中间步骤后,每一步的难度大幅降低,模型在各步骤上的注意力分配也更为精准,从而有效避免了长距离依赖导致的推理崩溃问题。DeepSeek Math正是深度应用并拓展了这一范式,在推理的每一步之后加入自动校验机制,形成"推理—验证—修正"的闭环。
从小学四则运算到大学微积分,从日常课堂练习到 IMO 金牌级别的竞赛难题,DeepSeek Math 适用范围之广、能力之强,正在重新定义开源数学 AI 的上限。本文将从技术内核、版本演进、核心能力、部署方式到横向对比,全面拆解这款模型的过人之处。
技术内核:垂直专精的设计哲学
与追求知识广度的通用大模型不同,DeepSeek Math 走的是一条截然相反的路——死死咬住数学这一个领域,在数学逻辑、符号计算、竞赛解题和定理证明上做深度优化,是典型的垂直领域专精模型。
通用大模型(如GPT-4、Gemini)追求"一模型解决所有问题",通过海量多领域数据训练获得广泛能力,但这种策略存在"能力稀释"问题——模型参数被分配到语言、常识、代码、数学等众多领域,导致单一领域的性能难以极致优化。垂直专精模型则反其道而行,将有限的参数容量集中投入特定领域,通过高密度领域数据实现能力的深度集中。这本质上是统计学习理论中"偏差-方差权衡"在模型设计层面的体现:通用模型覆盖面广但单领域能力有限,专精模型在目标领域内可达到极致深度。从信息论角度看,这等同于将有限的模型容量(参数所能编码的信息上限)集中编码数学领域的知识结构,而非将其稀释分摊到数十个领域,因此在数学任务上获得的信息密度显著更高。
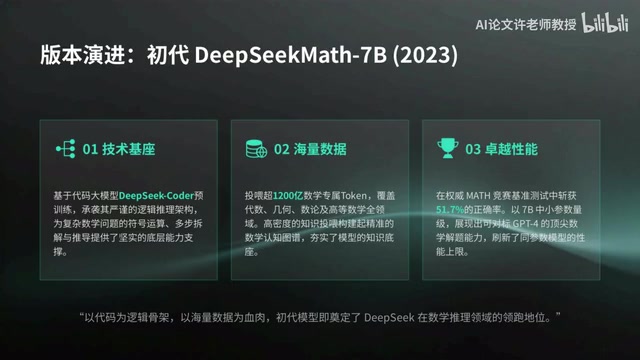
初代 DeepSeek Math 基于 DeepSeek Coder 代码大模型进行预训练,天生具备较强的逻辑推理能力,再叠加针对符号运算和多步推导的专项优化,底层架构非常适合求解复杂数学题。选择从代码模型出发而非通用语言模型,是一个颇具洞察力的工程决策:代码的本质是严格的逻辑序列,变量有明确作用域、操作有明确语义、输出有可验证性,这与数学推理的"步骤有序、符号有意义、结论可验证"高度同构,使得代码预训练赋予的逻辑结构化能力能够直接迁移到数学推导中。
在训练数据方面,初代模型使用了千亿量级的数学专属 Token,覆盖代数、几何、数论、高等数学等多个分支。这里的"千亿Token"概念值得量化理解:人类一生阅读约1亿个单词(约等于1.3亿Token),而DeepSeek Math仅数学领域的训练数据就是人类终生阅读量的近千倍。如此高密度的知识灌注,使模型构建出了一张精准的数学认知图谱,为处理各类数学问题奠定了扎实基础。值得注意的是,高密度数学专项数据的价值不仅在于"数量多",更在于数学文本本身的高度结构化特性——与自然语言文本相比,数学文本中每一个符号、每一步推导之间的逻辑关联密度远高于普通语言,模型在处理同等Token数量时能够提取到更丰富的结构化推理模式,这是千亿数学Token所能产生的能力放大效应的根本来源。
值得一提的是开源协议的实用价值。Apache 2.0 是软件开源领域最宽松的许可证之一,由Apache软件基金会维护。与GPL协议要求衍生作品同样开源不同,Apache 2.0 允许用户在商业产品中自由使用、修改和分发,无需公开源代码,唯一要求是保留原始版权声明。这与Meta Llama系列的定制许可证形成鲜明对比,后者对商业使用设有月活用户规模限制。从企业法务角度看,Apache 2.0 的明确授权范围大幅降低了合规风险——IP律师在评估基于开源模型构建商业产品时,Apache 2.0 几乎是最无争议的选择,这使得企业法务审批周期可从数月缩短至数天。对企业而言,Apache 2.0 意味着既可本地私有化部署以保障数据安全,也可调用在线 API 快速集成,还可基于该模型构建付费产品,灵活度极高,是开源商业化最友好的选择之一。
版本演进:从初代到 V2 旗舰
初代模型:小参数硬刚 GPT-4
初代 DeepSeek Math 的成绩已相当亮眼——在 MATH 竞赛基准测试中,仅凭 70 亿参数便达到 51.7% 的正确率,足以与 GPT-4 正面交锋,并刷新了同参数规模下的记录。
MATH 数据集由Hendrycks等人于2021年提出,包含12,500道竞赛数学题,覆盖代数、几何、数论等七个领域,难度从高中竞赛到AMC/AIME级别不等,长期以来是衡量数学AI能力的黄金标准——GPT-4发布时的42.5%正确率曾被视为里程碑。MATH数据集的设计哲学在于刻意回避"可被记忆"的标准题型,每道题都要求模型综合运用多个数学概念并展示完整推导链,因此它测量的是模型的"数学推理深度"而非"题库覆盖广度",这使得在MATH上的高分更难通过简单的数据扩充来刷取。DeepSeek Math 7B达到51.7%,意味着在参数量仅为GPT-4约1/100的情况下实现了性能超越,这正是垂直专精训练路线效率优势的有力证明。
V2 旗舰版:三大核心突破
DeepSeek Math V2 在核心技术上实现了质的飞跃:
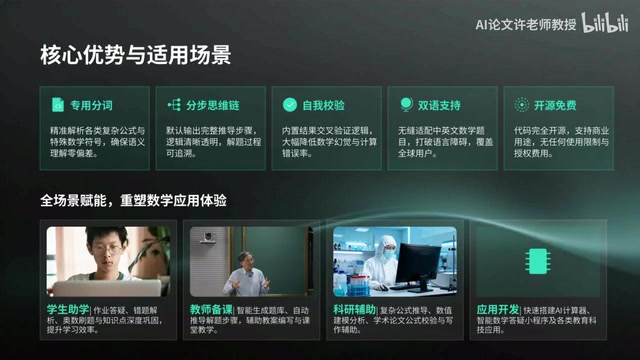
- 自我验证推理机制:每步推理后自动校验,杜绝"答案碰巧对了但过程有误"的问题,让每一步推导都有据可查、逻辑严谨。这一机制的技术基础来自强化学习(Reinforcement Learning)的深度融合——模型通过"尝试—反馈—修正"的迭代过程主动学习更优解题策略,类似于人类数学家反复校验草稿的认知行为。与纯监督学习相比,强化学习使模型能够发现训练数据中未曾出现的新颖推理路径,这是其在竞赛级问题上突破训练集天花板的关键机制。
- 多语言与形式化能力:完美处理中英文数学问题,支持形式化定理证明。形式化定理证明(Formal Theorem Proving)使用Lean、Coq等专用证明助手语言,每一步推导都经过机器严格验证,使数学结论从"看起来正确"跨越到"可被机器严格验证的正确"。Lean语言由微软研究院开发,其类型论基础使得每一个证明步骤都可被归约为基础公理体系的推导,彻底消除人工检查的主观误差;Coq则由法国国家信息与自动化研究所(INRIA)开发,已被用于验证操作系统内核(CompCert C编译器)等工业级安全关键软件,将形式化验证从纯理论数学延伸到了工程实践领域。这对科研和工程应用具有根本性意义。
- 代码深度集成:将数学理论与代码生成、数值计算紧密结合,打通理论与工程实践的壁垒。
在权威评测上,V2 表现堪称统治级:它是首个达到国际数学奥林匹克(IMO)金牌水平的开源模型,可解出 IMO 六道题中的五道,在组合数学和数论等最难领域同样出色。IMO 是人类数学竞赛的最高殿堂,其题目要求创造性构造与严格证明,历来被视为 AI 难以攻克的壁垒,此前学界普遍认为 AI 达到金牌水准至少需要十年以上。IMO题目的特殊挑战在于其"开放构造性"——题目不存在标准算法路径,需要模型具备类比迁移、反例构造、辅助元素引入等创造性能力,这要求模型不仅存储数学知识,还需具备元认知层面的策略选择能力,即"知道何时用哪种解题框架"。DeepSeek Math V2在这一层面的突破,标志着数学AI从"工具型解算器"向"策略型推理者"的质变跨越。Putnam 数学竞赛中斩获 118 分(满分 120),Math500 评测正确率高达 97.3%,整体水准已可与顶尖数学家相媲美。
核心能力:从基础教育到科研前沿
DeepSeek Math 的突出特点之一,是打通了从基础教育到科研创新的完整链路。
基础教育阶段
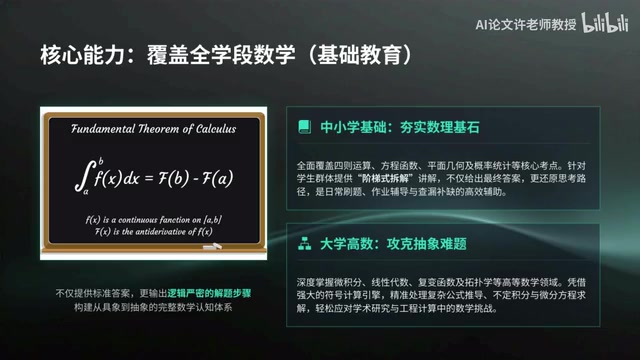
在中小学阶段,模型覆盖四则运算、方程、函数、平面几何、概率统计等全部核心考点。它采用阶梯式拆解的讲解方式,不只给出答案,而是将每一步思路完整呈现——这对于真正理解数学、而非死记硬背答案极为有帮助。这种讲解模式在认知科学上有其依据:维果茨基的"最近发展区"(Zone of Proximal Development)理论表明,学习者在略超出当前能力边界处接受适当脚手架支持时,学习效率最高。阶梯式拆解本质上是为每位用户动态构建这种认知脚手架——传统课堂中,教师需要了解每位学生的认知边界才能提供恰当的引导,而AI的优势在于可以通过对话轮次动态估计用户的当前理解水平,将个性化的"脚手架搭建"压缩到单次对话中实时完成,这是其教学效率远超标准化教材的根本原因。
高等数学与科研支持
在大学及研究层面,无论是微积分、线性代数、复变函数还是拓扑学,模型均能提供详细推导步骤,帮助建立从具体到抽象的数学认知。面对科研级问题,它不仅能进行严格的定理推导和形式化证明,还能自动生成 LaTeX 公式并转为 Python 代码执行数值仿真,贯穿从假设建立到结果验证的完整科研流程。
LaTeX 是学术界标准的数学排版语言,由Donald Knuth的TeX系统发展而来,几乎所有顶级数学和物理期刊都要求使用LaTeX投稿;Python 则凭借NumPy、SciPy、SymPy等科学计算库成为数值仿真的首选语言,其中SymPy专门用于符号数学计算,能够以任意精度执行代数化简、微积分和方程求解。值得特别说明的是,符号计算(Symbolic Computation)与数值计算(Numerical Computation)在数学研究中扮演着互补的角色:符号计算处理精确的代数表达式,可以给出形如"x = √2 + 1"这样的精确解;数值计算则通过浮点近似处理无法解析求解的问题,给出"x ≈ 2.414"这样的近似解。LaTeX的渲染层、SymPy的符号层与NumPy的数值层共同构成了"理论—符号—数值"三层完整验证体系。DeepSeek Math 能够在这三个层次之间自动切换,将传统"手动推导→手动编码→手动验证"的三段式割裂流程压缩为单次对话即可完成,显著提升研究效率。
竞赛数学
针对 IMO、Putnam 等顶级赛事,模型会模仿金牌选手的解题思路,处理数论、组合数学和复杂构造性证明,并指导用户构造创造性解法,每一步保持严谨可追溯。它不只是解题工具,更是提升数学思维与创造力的训练伙伴。竞赛数学的训练价值在学界已有共识:IMO训练系统性地培养了"问题分解、模式识别、反例探测"等元认知技能,这些技能在机器学习、算法设计等计算机科学核心领域具有直接迁移价值,这也是为何IMO金牌得主在顶尖AI研究机构(DeepMind、OpenAI等)中比例显著偏高的深层原因。更重要的是,对于使用DeepSeek Math进行竞赛训练的学生而言,模型的价值不仅在于给出正确答案,而在于展示"如何选择解题策略"——这种元层面的解题示范,正是传统教材和题库解析所难以提供的核心训练价值。
部署方式:在线 API 与本地开源双路径
在线 API 调用
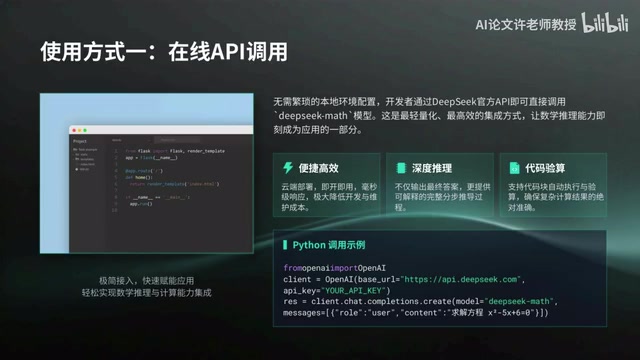
通过 DeepSeek 官方 API,开发者无需关心环境配置,即可在项目中直接调用模型。云端部署提供毫秒级响应,无需自行维护服务器,成本低廉。除最终答案外,模型还会完整呈现每步推导过程,并可自动运行和验证代码块,确保计算结果准确。API调用的技术实现基于HTTP REST协议,与OpenAI API保持高度兼容性设计,这意味着已有OpenAI集成代码的开发者通常只需修改端点URL和API密钥两个参数即可完成迁移,工程切换成本极低。这种API兼容性设计是DeepSeek的刻意工程决策——通过降低从OpenAI生态系统迁移的摩擦力,大幅扩大了潜在用户基础,同时也为已有OpenAI集成的企业提供了一个低风险的"平行测试"路径,可在不改动主系统的前提下并行评估DeepSeek Math的表现。
本地开源部署
对于金融、政务等对数据安全和合规要求极高的行业,本地部署是刚需。所有推理在内网完成,数据不出服务器,隐私完全可控。这一需求的合规背景日益紧迫:欧盟《通用数据保护条例》(GDPR)、中国《数据安全法》和《个人信息保护法》均对将敏感数据发送至境外云服务设有严格限制,本地部署方案天然规避了跨境数据传输的法律风险,同时也消除了依赖外部API的单点故障风险。对于金融机构而言,合规考量尤为关键:内部量化模型、风控逻辑等核心数据若通过外部API处理,不仅面临监管合规风险,还存在知识产权泄露隐患,而本地部署的DeepSeek Math则可以在完全隔离的内网环境中处理这些敏感计算任务。
成本方面同样友好:一次性部署后即可无限次免费调用,无 API 费用、无订阅费。7B 版本仅需一张消费级显卡即可运行,基于 Transformers 和 Docker 环境,几行代码或一条命令即可完成启动,部署门槛极低。这里的"7B"指70亿参数规模——相比动辄千亿参数的通用旗舰模型,7B 模型在单张消费级GPU(如RTX 3090/4090,显存24GB)上即可流畅推理,大幅降低了个人开发者和中小企业的硬件门槛。量化技术(如GGUF格式的4-bit量化)还能进一步将显存需求压缩至约6GB,使得配备16GB显存的笔记本GPU(如NVIDIA RTX 4060 Laptop)也可运行,真正实现"边缘端数学AI"的落地。所谓量化,是指将模型参数从32位或16位浮点数压缩为4位整数的过程:虽然每个参数的精度有所损失,但实验表明在推理任务中4-bit量化带来的精度下降通常小于2%,而内存占用却减少了约75%,这一近乎"免费的午餐"使得本地部署的门槛发生了质的改变。
横向对比:开源与闭源双线领先
在同等参数规模下,DeepSeek Math 的数学推理能力明显强于 Llama、Qwen 和 WizardMath 等同类开源模型,无论复杂逻辑推演还是解题步骤质量都占据优势。
更值得关注的是与闭源巨头的较量。DeepSeek Math 专为数学推理深度定制,覆盖从基础运算到前沿科研的全场景。其 7B 轻量版本在奥数和高等数学领域已可追平乃至超越 GPT-4、Gemini Ultra 等闭源旗舰模型——用更小的参数量跑出更高效能,正是垂直专精路线的核心价值所在。DeepSeek Math 7B超越GPT-4的事实,为业界提供了一个重要信号:在资源有限的场景下,与其追求通用能力的全面覆盖,不如在目标领域深度聚焦,垂直专精路线可能是更优的工程选择。这一现象在机器学习理论上有"No Free Lunch定理"(NFL定理)的对应解释:该定理由Wolpert和Macready于1997年严格证明,指出在所有可能问题的平均性能上,任何算法都不优于随机搜索,这意味着没有任何模型架构或训练策略在所有任务上都最优。通用模型为追求跨任务的广泛覆盖,必然在单任务深度上做出牺牲;而DeepSeek Math正是将这一理论约束转化为工程优势的典范案例——通过主动放弃非数学领域的能力,换取数学领域的极致性能,这是对NFL定理蕴含的工程逻辑的深刻运用。
结语:垂直专精的胜利
DeepSeek Math V2 的意义,不只在于达到 IMO 金牌水准,更在于它验证了一条清晰的技术路径:在特定领域深耕,小模型同样可以击败大模型。
对学生而言,它是能拆解解题思路的智能答疑老师;对教师而言,它是智能组卷、生成详细解析的效率助手;对科研人员而言,它是打通推导、建模、验证全流程的得力工具;对开发者而言,它是快速构建数学推理能力的开源底座。
开源可商用、部署门槛低、性能顶尖三大优势加持之下,DeepSeek Math V2 已稳稳站上开源数学 AI 的顶尖位置。从更宏观的视角看,DeepSeek Math 的成功也为整个AI行业的资源分配逻辑提供了一个反思维度:当大模型竞赛日益演变为资本密集型的军备竞赛时,垂直专精路线或许代表着一条更具可持续性、更普惠的技术民主化路径——让更多组织和个人以可负担的成本获得顶尖AI能力,而非将先进AI的使用权锁定在少数拥有超大算力的科技巨头手中。这一路径的深远意义在于,它从实践层面论证了AI能力的"去中心化"可能性:领域专精模型的崛起意味着,未来的AI生态或许不是由少数超级通用模型垄断的格局,而是由众多深度专精的垂直模型共同构成的多元化生态系统,每个模型在其擅长的领域提供远超通用模型的深度服务。
相关推荐

12GB显卡跑68GB大模型:Betelgeuse引擎实测22 tok/s
开发者发布Betelgeuse推理引擎,在RTX 3060 12GB+16GB DDR4的普通PC上以22 tok/s持续运行68GB Qwen 3.8 Flash Next MoE模型,峰值48 tok/s,且输出100%比特精确。

付费踢人抢网站?这个实验性项目引爆所有权争夺
开发者推出实验性网站 hijackthis.lol,付费1美元即可踢走当前占领者成为网站新主人,保护期与退款机制引发数字所有权博弈。

用领英帖子打造AI分身,靠谱吗?
讨论用多年领英帖子构建知识库型AI分身的可行性:相比模仿文风,引用原始内容的AI克隆更有价值,但面临观点过时、信任授权和持续维护等挑战。