DeepSeek V4.1 Flash编程实测:速度飙升,一句话出活

DeepSeek V4.1 Flash 正式上线,速度大幅提升,一句话可生成3D场景与完整桌面应用。
DeepSeek 正式发布 V4.1 Flash,官网所有模型自动完成升级。B站UP主小刘的实测重点覆盖前端与应用生成场景:响应速度接近实时阅读节奏,一句话即可生成 3D 大楼场景(含自动门开合逻辑)、学生管理静态页面(配色能根据语义自动匹配风格)以及功能完整的桌面端物流管理系统(含新建运单、车辆调度、财务等多模块)。此外还生成了带日历视图的 Markdown 日记应用和提词管理工具,后者经两轮对话迭代完成。UP主特别推荐搭配 DeepSeek Harness 工具使用,认为其适配优于 Claude Code,但这一观点来自单一来源。总体看,本次测评以前端和桌面应用生成任务为主,复杂后端与算法场景尚待更多独立验证。
DeepSeek V4.1 Flash 正式上线
DeepSeek广告 正式发布了 V4.1 的正式版本,此前访问的 V4 Pro 模型会自动切换到 V4.1 Flash 的服务。换句话说,用户在官网上使用的所有模型,背后都已经升级到了这套新版本。
从 B站UP主小刘的实测来看,V4.1 Flash 最直观的变化就是速度——用他的原话说是"快得离谱",输出几乎能跟上肉眼阅读的节奏。对于高频编程和写代码的用户而言,这种响应速度的提升往往比参数指标更有体感价值。
值得一提的是,UP主在视频中反复强调搭配 DeepSeek Harness 工具使用,并直言它对 DeepSeek 模型的优化"完全不是同一个东西",甚至把它和 Claude Code 做了横向对比,认为前者在适配上更有针对性。这一点属于单一来源的个人体验,供参考。
一句话生成 3D 场景与静态页面
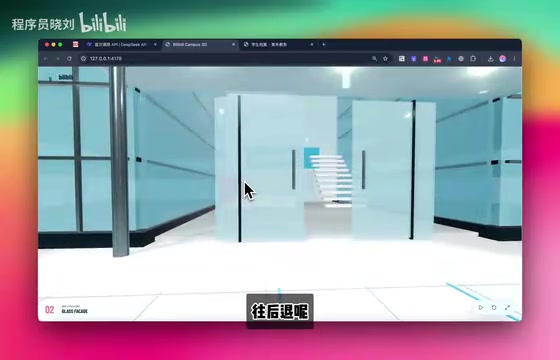
实测的第一个案例,是让模型用一句话生成一个类似 B站的 3D 大楼场景。生成结果令人意外——不仅画面效果不错,模型还自动给自动门加上了开合逻辑:角色往前走门自动打开,往后退门会关闭。虽然画面存在一定卡顿,但整体交互实现得相当完整。
第二个案例是生成一个学生管理系统的静态页面,同样一句话完成。这里体现出一个明显的进步:配色的容错率大幅提升。以往大模型生成前端页面时,常常默认套用紫色或粉红色渐变这类千篇一律的风格;而 V4.1 Flash 会根据需求语义自动匹配配色——做学生管理系统时,它选择了偏素净的商务风格,而非生硬的渐变模板。这种"懂场景"的审美判断,是实用性上的关键改善。
「一句话生成」在大模型领域通常指 zero-shot 或 single-turn prompt——用户无需提供结构化需求文档、示例代码或多轮澄清,模型直接从一条自然语言指令推断出完整的功能结构、技术选型和代码实现。这对模型的意图理解与代码规划能力要求极高:它需要在没有约束条件的情况下自行决策用哪个渲染框架、如何组织文件结构、交互逻辑应覆盖哪些边界情况。3D 场景生成通常依赖 Three.js 或 Babylon.js 等 WebGL 封装库,实现碰撞检测和门控逻辑还需要额外的状态机或事件监听代码——这些都需要模型在没有提示的情况下主动补全,因此「自动加上开合逻辑」并非偶然细节,而是衡量模型主动补全能力的一个有效信号。
桌面端应用:从物流系统到完整交互
真正展现模型能力深度的,是桌面端应用程序的生成。UP主让它做一个桌面端物流管理系统,同样一句话完成。
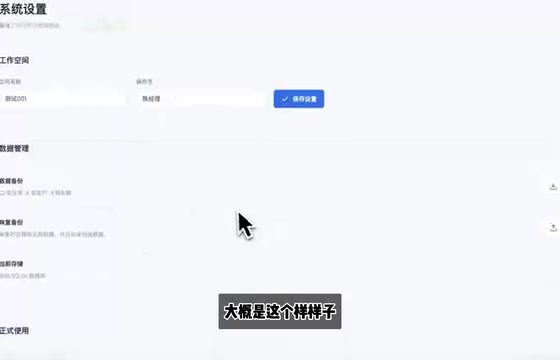
这个程序并非网页,而是运行在桌面端的独立应用。功能覆盖了新建运单、图表渲染、车辆调度、仓储管理、客户管理以及财务情况等多个模块。UP主特别称赞了其中的设置功能——可以配置系统名称并实时保存生效,细节完成度超出一句话 prompt 的预期。
对于一个由单条指令生成的复杂应用来说,能同时组织起多个业务模块并保持交互可用,说明模型在结构化代码生成和功能规划上有了实质进步,而不只是堆砌界面。
「桌面端独立应用」的生成难度通常高于网页,因为它涉及运行时环境的选择。目前主流的跨平台桌面应用框架包括 Electron(基于 Chromium + Node.js)、Tauri(基于系统 WebView + Rust 后端)以及 PyQt/Tkinter 等原生 GUI 框架。不同框架的打包方式、文件 I/O 权限模型和 UI 组件库差异显著,模型需要在未被明确告知的情况下选择一套可运行的技术栈并生成完整的项目结构,而不只是一个 HTML 文件。这也是「一句话生成桌面应用」比「一句话生成网页」更能反映模型工程规划能力的原因:它考验的是模型对完整软件交付链路的认知,而非单纯的界面渲染。
实用工具:日记应用与提词管理
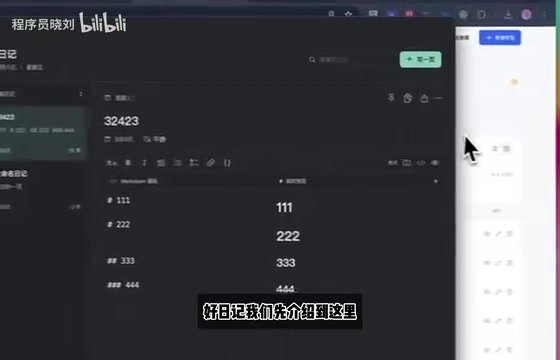
接下来是两个更贴近日常需求的小工具。第一个是 Markdown 日记应用,用于每天记录日记。
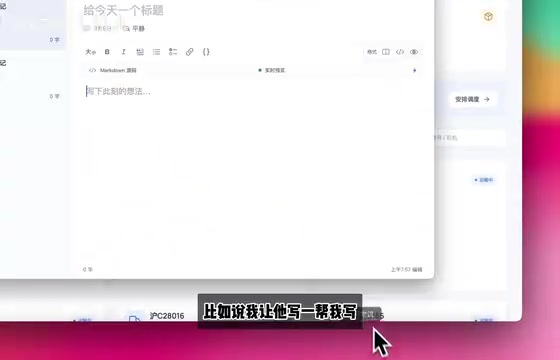
这个应用在一句话生成的基础上,还附带了剪贴板功能、日历视图以及多主题颜色切换,整个过程没有做二次修改。对于轻量级个人工具来说,这样的开箱即用程度已经相当可观。
第二个工具源于 UP主自己的真实痛点——每次写提词都要重复书写,于是让模型做了一个"提词匣管理"工具,支持创建提词、按分类管理、新建分类等功能。这个案例大约经过了两轮对话调整(第一轮未成功),最终效果令人满意。这也提醒我们:复杂需求下,一次生成不一定完美,但模型的多轮迭代能力足以快速收敛到可用结果。
实测总结:速度与能力的双重升级
综合这几个案例,DeepSeek V4.1 Flash 给出的信号比较清晰:
- 速度显著提升,响应快到接近实时阅读节奏;
- 一句话生成能力更强,从 3D 场景、静态页面到完整桌面应用都能应对;
- 审美与容错率改善,不再是千篇一律的渐变配色;
- 细节完成度高,自动门逻辑、设置项实时生效等小功能都有照顾到。
需要客观看待的是,本次测试均来自单一UP主的个人体验,样本以前端和应用生成类任务为主,并未涉及复杂算法、后端架构或长链路工程场景。模型在这些更硬核任务上的表现,仍有待更多独立评测验证。对于日常开发者而言,V4.1 Flash 配合 Harness 工具,确实值得一试。
DeepSeek Harness 是专门为 DeepSeek 系列模型设计的 AI 编程辅助工具,定位类似于 Claude Code 或 GitHub Copilot Workspace,但针对 DeepSeek 的模型架构和输出格式做了专项适配。Claude Code 是 Anthropic 推出的命令行 AI 编程助手,能在终端环境中直接读写文件、执行命令并完成多步骤编程任务,以其强大的上下文管理和工具调用能力著称。两者的核心差异在于模型-工具的耦合程度:通用工具在对接不同模型时需要兼顾输出格式差异,而专属工具可以针对特定模型的 token 输出习惯、停止符和结构化代码块做深度优化,理论上能减少解析错误并提高代码注入的稳定性。这也是 UP主认为 Harness 在 DeepSeek 适配上「不是同一个东西」的技术背景。
相关推荐

AI检测误判风波:作家被指用AI写作,谁该举证?
2026年英联邦短篇小说奖地区获奖者被Pangram检测工具判定100% AI生成,最终靠草稿自证清白。这起事件揭示了AI检测工具的误判风险与创作者面临的举证困境,以及作家协会承认没有可靠AI检测方法的现实。

Paul Ford新作引热议:Web本身已经足够
Paul Ford 文章《The Web Is More Than Enough》在 Hacker News 引发讨论,主张 Web 标准已足够承载应用开发,反对动辄引入封闭平台。本文梳理其核心论点、与当前 AI 应用潮流的张力,以及对开发者技术选型的实际含义。

斯坦福如何教授AI原生工程:CS146S课程揭秘
斯坦福CS146S课程直面AI一键生成作业的挑战,探索AI原生工程教育。Mihail Eric分享如何将AI作为工程伙伴,培养系统设计和代码审查能力,为工程教育提供新范本。