DeepSeek V4.1 Flash实测:效率革命还是精心挑选的图表?

DeepSeek V4.1 Flash凭借MoE与编解码分离架构实现低成本智能体推理,但"击败前沿"的跑分说法存在对手过时与基准选择偏差等问题。
DeepSeek于9月10日以MIT协议开源V4.1 Flash,该模型拥有5520亿总参数,但通过混合专家(MoE)架构与创新的编码器-解码器分离设计,读取阶段每token仅激活80亿参数,KV缓存足迹仅890字节,使百万token上下文的内存压力大幅降低,缓存输入成本约为同类竞品的1/25。官方跑分在Terminal Bench 2.1等"简单"基准上领先Claude Opus 5和GPT-5.6 Sol,但在Terminal Bench 3.0/4.0等更难任务上差距显著扩大;更关键的是,对比对象在发布12天后就被新版本超越,且同一模型因评测框架(harness)不同得分可相差近9分。独立评测显示其输出冗长(输出token量约为同类中位数的1.8倍)、事实召回能力弱于更大的V4 Pro,且OpenAI GPT-6 Luna发布后其价格优势已被大幅压缩。该模型真正的定位是输入密集型智能体场景下的高性价比选项,而非全能前沿模型。
DeepSeek新发布的V4.1 Flash在Terminal Bench 2.1上拿下90.6分,超过了Claude Opus 5的89.1和GPT-5.6 Sol的88.8。更惊人的是,它每处理一个输入token只激活55.2亿参数中的80亿。数字很漂亮,但一位海外技术博主翻遍了模型卡、技术报告和独立评测后发现,故事没那么简单——这究竟是一次真实的效率飞跃,还是一张精心挑选的图表?
DeepSeek到底发布了什么
V4.1 Flash于9月10日以MIT开源权重发布,DeepSeek广告称它是新架构家族中"最小"的模型。但所谓最小是相对的:它拥有5520亿参数,几乎是被替代的V4 Flash(2840亿)的两倍。
三项核心更新值得关注:原生视觉能力,图像与文本从预训练之初就在45万亿token上联合训练,此前的实验性视觉模型被弃用;100万token的上下文窗口;以及一套专为让"输入密集型"智能体任务变便宜而重新设计的架构。
有个小插曲:DeepSeek起初宣布9月14日起V4 Pro的请求将重定向到V4.1 Flash,但在用户反对后收回了决定。V4 Pro仍以同样的计费方式提供,因此Flash并非取代旗舰模型,官方公告也指向了尚未发布的V4.1 Pro。
一张截图进去,一个三文件补丁出来
博主找到的最有说服力的演示来自Datacamp。数据工程师Khalid Abdulladi搭建了一个名为Nimbus Analytics的小型Flask看板,然后在三个文件里各植入一个bug:Python里的计算错误、CSS里的颜色错误、JavaScript里不匹配的Canvas ID。智能体事先并不知道bug在哪,只拿到一张"正确效果"的参考截图,以及列文件、读文件、跑测试、用无头浏览器自截图、批量改文件的工具。
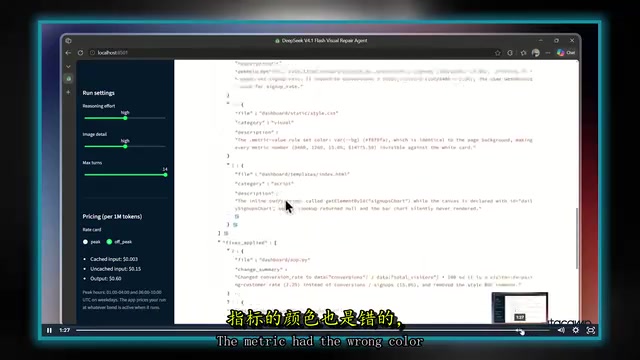
它没有急着动手。前两轮纯观察,第三轮跑测试,第四轮才提交一个补丁:转化率公式错把访客数写成了注册数,指标颜色错误,JavaScript指向了错误的canvas。五项测试全部通过。
但有个博主特意留到最后讲的细节:测试全绿,每张新截图却仍显示15%转化率和空白图表。原因是服务器仍在跑旧代码——它启动时关闭了debug模式,没有任何机制重新加载打过补丁的Python或模板,只有CSS改动生效了。智能体在第14轮(也是最后一轮)准确诊断出了这个问题,却没有重启服务器的工具,只能由人来完成。
诚实的解读是:模型修好了代码,也正确判断出自己为何无法验证成果,但无法独立收尾。作者的结论是,缺失的是一个"重启工具",而不是又一个补丁。整个过程15次请求、约15.7万输入token(其中87%命中缓存)、1.1万输出token,非高峰时段总成本约1美分。
5520亿参数为何能这么便宜
答案在架构里,博主拆解出三个关键技巧。
第一是混合专家(MoE)。每一层有1个共享专家和384个路由专家,但每个token只激活其中6个路由专家,网络大部分在任意时刻都处于闲置。
第二是全新的编码器-解码器分离设计。预填充(读prompt)阶段由20层编码器工作,解码(写答案)阶段的记忆直接从编码器最终输出投影而来,而非逐层计算。DeepSeek称这让读取时每token激活80亿参数、写入时激活160亿。对比之下,老的V4 Flash每token激活130亿,V4 Pro激活490亿——更大更新的模型,读取反而用更少参数。
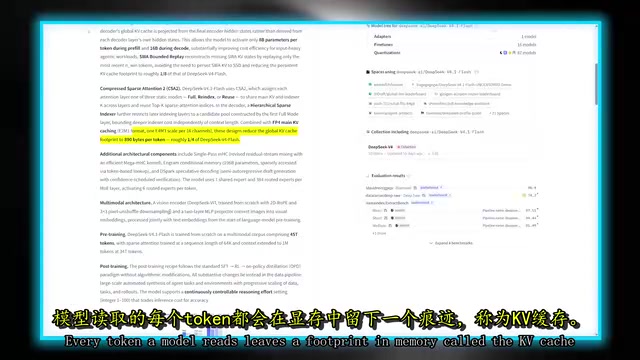
为什么这样设计?因为智能体任务是"输入密集型"的。在Datacamp的运行中,模型每写1个token要读约14个,每一轮都要重发文件、工具输出和历史记录。让读取变便宜,命中的正是token的最大头。
还有让长上下文变便宜的关键:每个被读token在内存里留下的KV缓存足迹。V4.1 Flash每token仅占890字节,约为V4 Flash的四分之一,据模型卡比DeepSeek首个模型小约437倍。100万token乘890字节不到1GB(博主自己的粗算,未计其他状态),这解释了百万级窗口在这里为何不再是内存噩梦。
混合专家(MoE)架构的核心思想是将单一的大型前馈网络替换为多个并行的"专家"子网络,再由一个轻量级路由器动态决定每个token应该交给哪几位专家处理。由于每次只有少数专家被激活,模型的总参数量(决定模型上限)与推理时的计算量(决定速度和成本)被有效解耦——这正是V4.1 Flash能以5520亿总参数却仅激活80亿来完成读取的根本原因。路由策略的设计本身也是一门学问:专家分配过于集中会导致部分专家过载、其余空转(称为"负载不均衡"),DeepSeek在这里引入了384个路由专家加1个共享专家的设计,共享专家负责处理所有token都需要的通用特征,路由专家则捕捉更专门化的模式,两者协作兼顾了泛化能力与专业化效率。
编码器-解码器分离设计在传统大语言模型中并不常见。主流的仅解码器(decoder-only)架构对读取和生成使用完全相同的层堆叠,而V4.1 Flash将预填充阶段独立为20层编码器,解码器则直接从编码器的最终隐藏状态投影初始记忆,跳过了逐层"回放"输入的开销。这一设计在长prompt场景下收益显著,因为编码器只需对输入做一次前向传播,其结果可被缓存复用,后续每轮生成无需重新计算输入部分的注意力。
那张所有人都会截图的跑分表
DeepSeek用最大推理强度的V4.1 Flash对比Claude Opus 5、GPT-5.6 Sol等模型。它领先的地方集中在"简单"任务:Terminal Bench 2.1得90.6,DeepSWE 74.2对Opus 5的74.0(仅领先0.2分),CyberGym 88.1对84.5。
但一看更难的题就变了:Terminal Bench 3.0,30.0对Opus 5的43.3;Terminal Bench 4.0,31.2对Opus 5的51.8;无工具版"人类最后考试"36.8对Opus 5的56.3。博主的判断是——简单测试挤在顶部,难测试拉不开的差距就露馅了。
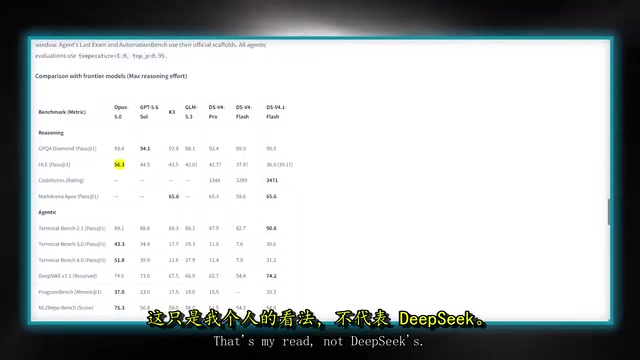
DeepSeek自己的模型卡还有个警告:同一模型在DeepCWE上,因智能体框架(harness)不同,得分从65.5到74.2不等。头条用的是官方harness,也就是区间上限;在Claude Code的harness下只有69.8。
更关键的是对手问题。这张表9月10日发布,而Anthropic在9月22日推出了Opus 5.5,OpenAI同日推出GPT-6 Sol和Luna。发布12天后,表里的两个主要对手都已被超越。V4.1 Flash是快速低成本模型,它真正的同类应该是Gemini 3.8 Flash和GPT-6 Luna。与Gemini Flash相比,差距只有1.2和0.5分,比harness带来的波动还小。
公允的总结是:DeepSeek在当前快速梯队中有竞争力,但"击败前沿"的说法建立在过时的对手之上。
**评测基准(benchmark harness)**指的是围绕模型能力测试而构建的完整评估框架,包括任务描述的格式、工具的调用方式、结果的判定逻辑,以及在多轮智能体任务中如何管理上下文和执行环境。不同harness对同一模型给出截然不同的分数并非罕见——模型卡里DeepCWE得分从65.5到74.2的波动就是典型案例。这意味着"在X基准上得Y分"这类陈述,其隐含条件是"在特定harness下",脱离这一前提进行跨模型比较容易产生误导。Terminal Bench 2.1与3.0/4.0之间的巨大分差(30分对90分)同样说明,任务难度分布的选取会让同一模型呈现出截然不同的能力面貌;发布方倾向于选取己方优势区间的基准,是行业内公认的常见做法,独立评测机构存在的意义正在于此。
独立评测补充了什么
Artificial Analysis的独立评测支持DeepSeek的部分说法:新Flash在其智能指数上得39分,超过更大的V4 Pro的36分,远高于同类开源模型中位数,但低于领先的前沿模型。它测得约232 tokens/秒,相当快,不过含思考在内首个token约需10秒。
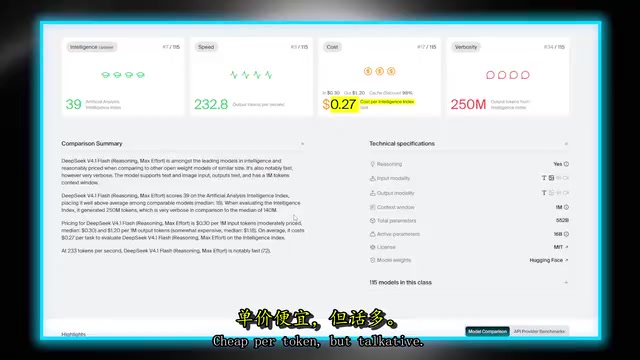
代价是"话痨"。完成整个指数它生成了2.5亿输出token,而同类模型中位数是1.4亿,单任务成本达0.27美元——每token便宜,但产出太多。在事实召回测试SimpleQA上,V4.1 Flash仅得42.3,而更大的V4 Pro基座为55.2,效率是有代价的。
关于价格,DeepSeek不再是最便宜的:9月22日OpenAI的GPT-6 Luna报价每百万输入token 0.10美元、输出0.50美元,低于DeepSeek非高峰的挂牌价。DeepSeek唯一仍独树一帜的是缓存输入——非高峰0.003美元,比Gemini 3.8 Flash便宜25倍。对每轮重发相同历史的智能体来说,这让输入成本极低。
至于自己部署,权重虽开源,但检查点重达510GB,托管指南建议用4卡Blackwell或8卡H200,对大多数人来说API才是现实路径。至于流传的"以1%成本达到GPT-6 98%质量"的说法,博主在模型卡、技术报告和独立评测里都找不到依据,应视为未经证实。
**KV缓存(Key-Value Cache)**是Transformer推理中存储注意力机制中间结果的数据结构。在自回归生成过程中,模型每生成一个新token都需要与所有历史token计算注意力,若不缓存历史token对应的Key和Value向量,这部分计算将随序列长度呈平方级增长。KV缓存将这些向量保存在显存(GPU内存)中,以空间换时间。对长上下文模型而言,KV缓存的内存占用往往成为瓶颈:一个百万token的上下文窗口,若每token占用数KB,总计可能消耗数十GB显存。V4.1 Flash将每token的KV缓存足迹压缩到890字节,这一优化的技术路径通常来自降低注意力头的数量或维度(如多查询注意力MQA/分组查询注意力GQA),或结合量化技术,使得百万token窗口的缓存总量降至可管理范围,同时也使API侧的缓存命中价格优势得以在商业上成立。
结论:这是一个效率故事
V4.1 Flash的核心价值是效率:读取阶段一半的活跃计算、四分之一大小的缓存、以及开源模型里几分之一美分的缓存输入。这让长的、输入密集的智能体循环变得便宜,而且这一点在DeepSeek文档、Datacamp实测和独立评测中都站得住脚。
站不住脚的是"击败前沿"。在更难更长的任务上它落后,对最新快速梯队大致持平,且价格优势在Luna发布那一刻就被压缩了。
博主的建议是:如果你的智能体需要大量读取(代码仓库、截图、日志)且预算敏感,值得一试;但它不是最难的长周期任务的首选。若要基于它开发,Datacamp的清单值得参考——限制轮数和成本、限制文件访问、校验每个工具参数,并给智能体一个重启被测环境的方式。
背后还有个更大的问题:智能体的大部分token都花在读取上。如果其他实验室都去复制这套"让读取变便宜"的设计,这次发布的意义将远超一张排行榜。
相关推荐
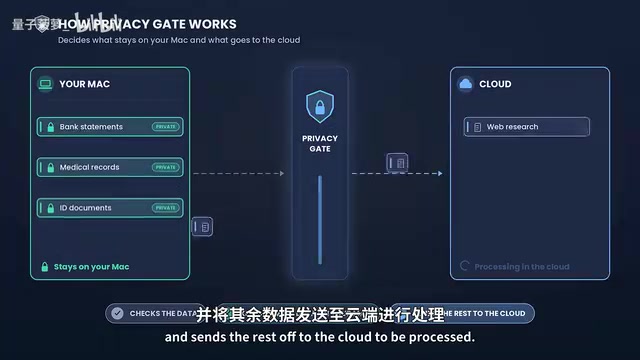
Perplexity混合计算实测:隐私数据不出Mac
Perplexity Hybrid Compute 实测:PrivacyGate 如何拦截敏感数据、本地模型与云端模型如何分工、16GB 与 32GB Mac 的模型差异,以及银行流水、医疗记录等真实场景下的隐私保护表现。
大肥鱼锐评国内外主流大模型:豆包登顶、DeepSeek并列第一
B站UP主大肥鱼锐评国内外主流大模型:豆包凭情绪价值登顶,DeepSeek以开源性价比并列第一,文心、海螺、元宝、Kimi、Qwen、可灵、Claude、Gemini、Grok各被贴上鲜明人设标签。本文梳理这份「最不客观」榜单背后的产品逻辑与选型启示。
AI Agent上生产前如何真测?一套可落地的测试与监控框架
BotGage创始人Pramin Pradeep分享AI Agent上生产前的测试方法:Agent注册可见性、红队测试、生产环境可观测性三步框架,附QA成本从18万美元降至8万美元的真实案例,以及IT角色向Agent监督者转型的分析。