DeepSeek V4 Pro实测:7个项目揭示真实编程能力与性价比

万众期待的DeepSeek V4 Pro,交出怎样的答卷?
DeepSeek 悄然发布了 V4 Pro 模型正式版,这款模型此前吊足了无数开发者的胃口。据 B 站 UP 主充值 300 元、用 7 个真实项目进行的全方位实测,结果却出人意料——用一句话概括就是「等了几个月,等来这么个玩意儿」。
从官方参数来看,V4 Pro 的规格相当亮眼:支持 100 万上下文、384K 最大输出,进一步增强了 Agent 能力,并且专门适配了 Responses API,可以直接接入 Codex 等命令行工具。上下文窗口(Context Window)是大语言模型一次性能「看到」和「记住」的文本长度。100万token的上下文意味着模型可以一次性处理约75万个英文单词或约50万个中文字符,相当于一次性阅读十几本书——此前主流模型的上下文窗口多在12.8万到20万token之间,100万token是一个数量级的提升。而384K最大输出则意味着模型单次回复可以生成约28万个英文单词,这对于生成完整的代码项目、长篇报告等场景至关重要。这两个参数的组合使V4 Pro在理论上具备了处理大型代码仓库和长程开发任务的能力。值得注意的是,超长上下文并非没有代价——随着上下文长度增加,模型对中间部分信息的「注意力」会逐渐衰减,这就是研究界所说的「Lost in the Middle」现象。此外,更长的上下文也意味着更高的推理延迟和计算成本。因此,100万上下文更多是提供了一个理论上限,实际使用中模型在不同位置的信息检索精度是否均匀,仍需进一步验证。
Responses API是OpenAI在2025年推出的新一代API接口标准,旨在替代此前的Chat Completions API。它原生支持工具调用(Tool Use)、文件搜索、代码执行等Agent能力,允许模型在对话过程中主动执行操作而非仅返回文本。与传统的Chat Completions API相比,Responses API最大的变化在于引入了「有状态会话」的概念——服务端可以自动管理对话历史,开发者无需每次请求都手动拼接完整的消息列表。同时,它将工具调用从一个需要开发者手动编排的功能升级为一等公民,模型可以在单次响应中连续调用多个工具并基于结果进行推理。Codex CLI则是OpenAI开源的命令行AI编程助手,开发者可以在终端中直接用自然语言描述需求,AI会自动读取项目文件、编写代码、执行命令并验证结果。它的核心设计理念是「沙箱执行」:所有代码修改都在隔离环境中运行,开发者可以审查diff后再决定是否接受更改。DeepSeek V4 Pro适配Responses API意味着它可以直接接入这一生态,实现自主编程的完整工作流——这也是DeepSeek从「替代性API」向「生态兼容层」战略升级的重要一步。
最吸引眼球的是终端编程能力跑分——V4 Pro 拿到了 87.9 分,而目前全球顶级的 Claude(Sonnet 系列)为 88.0 分,仅相差 0.1 分。这里的跑分通常指SWE-bench等标准化编程基准测试。SWE-bench由普林斯顿大学研究团队于2023年发布,从GitHub上12个知名Python开源项目(如Django、scikit-learn、sympy等)中抽取真实的bug修复任务,要求AI在完整代码仓库中定位问题并提交正确的修复补丁。每个任务都有对应的单元测试来自动验证修复是否正确。87.9分与88.0分在统计上几乎没有差异,但正如本次实测所揭示的,基准测试分数与真实开发体验之间往往存在显著鸿沟——基准测试的任务通常边界清晰、规模有限(平均每个补丁只涉及几十行代码修改),而真实项目涉及审美判断、多文件协调、用户体验、架构设计等维度,这些很难被标准化测试覆盖。业界因此也出现了「Benchmark Hacking」的担忧——模型可能针对特定测试集进行优化,导致分数虚高但泛化能力不足。
然而,跑分归跑分,真实场景下的表现才是检验模型的唯一标准。这次实测直接把 V4 Pro 接入 Codex 命令行工具执行任务。由于 V4 Pro 是纯文本模型,无法通过截图查看网站效果,这里需要特别解释一下纯文本模型与多模态模型的关键差异:纯文本模型只能处理和生成文字,无法理解图片、截图或任何视觉信息;而多模态模型(如Claude Sonnet系列、GPT-4o等)可以同时处理文本和图像输入。在AI编程场景中,这一差异的影响远比表面看起来要深远。多模态模型生成网页代码后可以通过截图查看渲染效果,发现布局错位、配色不协调、字体层级混乱等视觉问题并自主修复——这形成了一个「编码→渲染→视觉反馈→修正」的闭环。而纯文本模型对于「好不好看」「对不对齐」完全没有感知能力,它只能根据代码逻辑推断输出是否正确,无法验证最终的视觉呈现。这就解释了为什么V4 Pro在后端逻辑上表现不错,但前端视觉效果频频翻车——它根本「看不见」自己做出来的东西长什么样。
为了弥补这一缺陷,测试者专门为V4 Pro搭建了一套基于 Playwright 的 Harness。Playwright是微软于2020年开源的浏览器自动化框架,是Puppeteer(Google Chrome团队的自动化工具)的精神继承者,由同一批核心开发者打造。它支持Chromium、Firefox和WebKit三大浏览器引擎,可以模拟真实用户操作——点击按钮、填写表单、截取屏幕截图、检查DOM元素属性等。与Selenium等传统方案相比,Playwright的优势在于原生支持自动等待机制和多页面/多浏览器并发,执行速度更快且稳定性更高。这套Harness本质上充当了「AI的眼睛替代品」:自动打开生成的网页、检查页面元素是否正确渲染、验证交互功能是否可用,然后将检查结果以结构化文本形式反馈给AI。这是一种巧妙的工程补丁方案,但显然不如多模态模型的原生视觉理解能力来得直接和高效——它只能告诉AI「按钮存在且可点击」,却无法传达「按钮的颜色与背景撞色导致看不清」这样的视觉信息。随后借助 Cursor 并行调用多个 Codex 命令,7 个项目同时开跑,约一小时全部完成。
前端编程能力:与Claude等顶级模型差距明显
前端能力是这次测试暴露问题最集中的环节。
交互式动画讲解网站
第一个项目要求 AI 先联网搜索技术细节确保内容准确,再制作交互式动画讲解网站。结果 V4 Pro 的表现令人失望:动画简单敷衍,动画块里的文字直接溢出边框;核心机制的示意图线条连接错误,节点之间明显错位;交互演示部分几乎没有交互性可言。
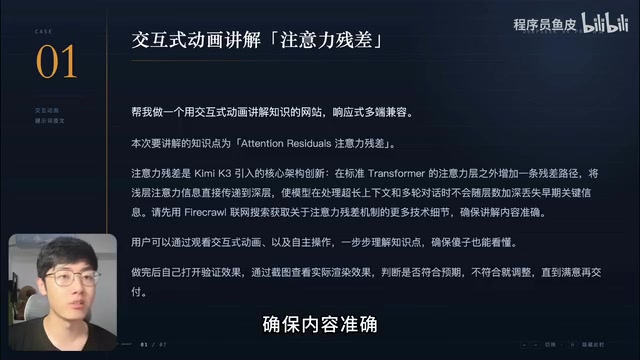
作为对比,同样的提示词下,Kimi K2 版本动画流畅、审美在线,节点与线条位置准确;Claude Sonnet 4.5 更是做得全面,背景有漂浮光点,还自主加入了随堂测验题,俨然一个系统化的知识讲解网站。相比之下 V4 Pro 显然掉队了。Claude在前端任务中表现突出的一个重要原因是Anthropic在训练过程中大量使用了「Artifact」功能产生的人类反馈数据——用户在Claude对话中直接预览和修改生成的网页/代码,这些交互数据帮助模型建立了对「什么样的前端效果看起来好」的深层理解。
3D 动画与仿真游戏
第二个 3D 版知识讲解网站,V4 Pro 表现「中规中矩」——配色科技风、粒子效果、3D 旋转缩放都能正常运行,没有明显错位卡顿,但相比 Kimi 和 Claude 简单不少。
第三个项目是竹蜻蜓仿真网页游戏,同时考察前端、物理引擎和声音合成。声音合成在Web端通常依赖Web Audio API,这是浏览器原生提供的音频处理接口,允许开发者通过JavaScript创建振荡器(Oscillator)、滤波器(Filter)、增益节点(Gain)等音频处理单元,组合出各种声音效果。模拟自然界的声音(如竹蜻蜓旋转的「哇哇哇」声)需要精确控制频率调制和包络变化,这对AI来说是一个非常考验「物理直觉」的任务——它需要理解声音的物理本质并将其转化为参数配置。前端界面平平,声音合成更是「翻车」——本该是「哇哇哇」的效果,却做成了「嗡嗡嗡」。有趣的是,用 V4 Flash 版本跑同样的提示词,结构和声音反而更接近预期,效果略胜 Pro 版一筹。
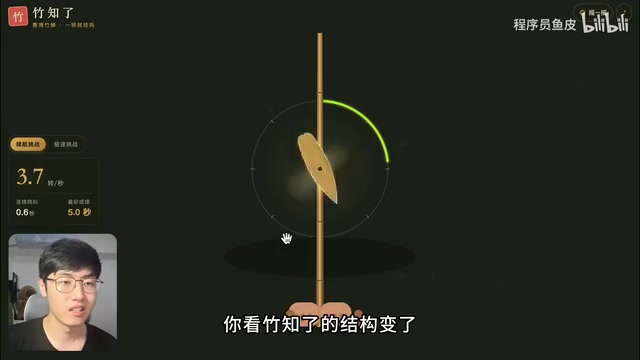
这里V4 Flash反超V4 Pro的现象值得关注。Flash通常是Pro的轻量级蒸馏版本,参数量更小、推理速度更快、成本更低。按常理,更大的模型应该表现更好,但在实际任务中「大力未必出奇迹」——较小的模型有时反而因为训练数据配比、蒸馏过程中的知识提纯等因素,在特定任务上表现更优。这也呼应了测试者「Pro与Flash可当同一档」的判断。
后端与全站工程:意外的亮点
如果说前端是短板,那么后端工程能力则是 V4 Pro 值得肯定的地方。
网页 PPT 生成工具
第四个项目让 AI 制作可交互的 PPT 生成工具,既测编码能力也测内容生成能力。整体界面布局合理,但存在明显 bug——所谓的「实时输出」并非真正实时,而是全部生成完才流式输出。这里涉及流式输出(Streaming)的技术实现:真正的实时流式输出通常基于Server-Sent Events(SSE)或WebSocket协议,服务端每生成一小段内容就立即推送到前端,用户可以看到文字逐字出现;而V4 Pro的实现疑似采用了「伪流式」——先在后端完成全部生成,再模拟逐字输出的效果,这导致用户需要等待较长时间才能看到第一个字符出现,体验大打折扣。最终 PPT 效果也很难评,文字全堆在左侧,右侧大量留白。对比之下,Claude 做出的更像一个成熟的工具产品。
在线抽奖系统
第五个项目考察工程严谨度:同一个人不能重复中奖、名额绝对不能超发。这类需求看似简单,实际上在高并发场景下极具挑战——多个用户同时抽奖时,如果不使用数据库事务、乐观锁或分布式锁等并发控制机制,就很容易出现超发(同一个奖品被多人抢到)或重复中奖的问题。V4 Pro 的前端样式较为粗糙,但功能完全可用——新建活动、配置名额、扫码报名、查询中奖都正常,经其他 AI 验证,后端逻辑没有重复中奖或超发问题。**唯一硬伤是前端太丑。**这再次印证了纯文本模型的特点:逻辑能力强,视觉呈现弱。
类以撒的肉鸽游戏
第六个项目复刻经典 Roguelike 游戏《以撒的结合》核心玩法,图形素材全用代码绘制。这个测试最能拉开模型差距。
Roguelike(肉鸽)是一种以随机生成关卡、永久死亡(死后重来)、丰富道具组合为核心特征的游戏类型,源自1980年的经典游戏《Rogue》。这个名字本身就是「Rogue-like(像Rogue一样的)」的缩写。《以撒的结合》(The Binding of Isaac)是这一类型中最具代表性的作品之一,由Edmund McMillen于2011年发布,玩家操控角色在随机生成的地下室中探索,通过收集道具叠加强化能力,对抗各种怪物和Boss。该游戏拥有超过700种道具,道具之间的组合效果(Synergy)是其最大魅力——比如追踪眼泪+分裂眼泪+穿透眼泪可以组合出极其华丽的弹幕效果。用AI复刻这类游戏极具挑战性,因为它涉及程序化内容生成(Procedural Content Generation,即用算法而非手工设计来创建游戏关卡)、物理碰撞检测、复杂的数值平衡系统、多层Boss AI行为树(一种用于定义NPC决策逻辑的树状数据结构)、道具效果叠加计算等多个技术维度,是检验AI综合编程能力的理想测试项目。
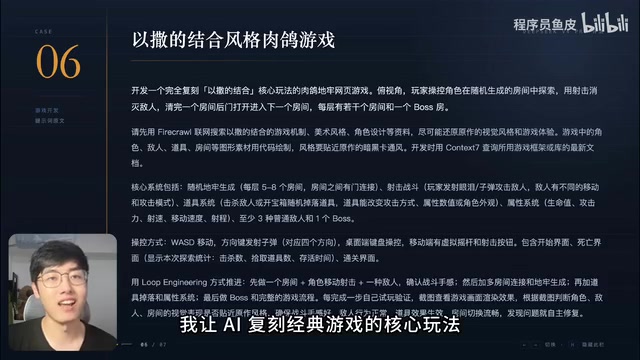
结果 V4 Pro 做出的游戏「地下室:泪之回廊」竟然能正常游玩,怪物有原版味道,数值系统、宝箱机制、Boss 战都有还原,难度适中——只是游戏只有一层,离成品尚远。而 Claude 的版本几乎神似原版,Boss 机制高度还原,差距依然明显。
长程任务:能跑通但选择另起炉灶
最后一个项目直接拉满难度:克隆 VS Code 开源代码,在此基础上开发一个复刻 Cursor 核心体验的 Web AI 编程工具。VS Code(Visual Studio Code)是微软于2015年开源的代码编辑器,基于Electron框架构建(即使用Web技术——HTML/CSS/JavaScript——来开发桌面应用),其源代码库规模庞大,包含数百万行TypeScript代码。而Cursor是2023年爆火的AI代码编辑器,正是基于VS Code的开源代码进行二次开发,在其基础上深度集成了AI对话、代码补全、多文件编辑等功能。让AI在VS Code源码基础上复刻Cursor,本质上是要求AI理解一个超大型开源项目的架构,并在其中进行有意义的功能扩展——这可能是目前AI编程领域最具挑战性的任务之一。
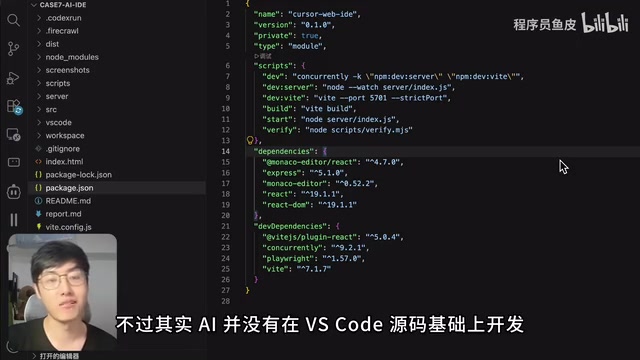
V4 Pro 的成品虽然与真实 Cursor 差距甚大,但整体布局合理,编辑器能打开编辑文件、支持代码提示与高亮,AI 对话模式还能执行命令、调用工具、自主编写代码,甚至能开发出可正常游玩的推箱子游戏。这说明 V4 Pro 执行长程任务的能力还是不错的。
不过一个关键细节是:AI 并没有在 VS Code 源码基础上开发,而是另起炉灶自己写了个前端应用(可能是出于性价比考量)。这种「避重就轻」的策略在AI编程中相当常见——面对一个复杂的现有代码库,AI可能会判断理解和修改现有代码的成本高于从头编写,因此选择重新实现。这在某种程度上反映了当前AI在「代码理解」与「代码生成」之间的能力不对称:生成新代码相对容易,但深度理解一个大型项目的架构、依赖关系和设计模式仍然极具挑战。而 Claude 的版本几乎完整保留了 VS Code 的精髓——代码高亮、小地图、管理面板一应俱全,堪称降维打击。
真实感受与AI编程模型选型建议
综合 7 个项目的实测,可以得出几个清晰结论:
- 前端编程能力远低于预期:生硬、机械,与 Claude 差距明显。
- 后端编程能力不错:全站项目可以一把梭跑通完整业务流程。
- 致命短板是缺乏视觉理解能力:作为纯文本模型,写完页面无法自己截图检查效果,因此发现不了布局和配色问题——这对 AI 编程影响极大。这一缺陷可能在未来通过DeepSeek推出多模态版本来解决,但在当前版本中,它是一个结构性的能力缺失。
- Pro 与 Flash 版本差距不明显:测试者个人认为可当作同一档模型。
最令人震撼的是性价比:7 个项目跑下来仅花费约 5 块钱,缓存命中率高达 99%。这一数据背后的关键在于DeepSeek激进的KV Cache(键值缓存)策略。KV Cache是Transformer模型推理加速的核心技术:在注意力机制中,模型需要为每个token计算Key和Value向量,当上下文很长时,这些KV对的计算量和显存占用极为庞大。KV Cache将已计算过的KV对缓存起来,新增token只需计算自身的KV对并与缓存中的历史KV对进行注意力计算即可。DeepSeek更进一步,在服务端实现了跨请求的KV Cache共享——当多次请求中有大量重复的上下文内容(如相同的系统提示词、相同的代码文件)时,服务端会缓存这些计算结果,后续请求只需为新增部分付费,缓存命中的token价格通常只有正常价格的1/10甚至更低。DeepSeek V3/V4系列采用的MLA(Multi-head Latent Attention)架构通过将KV对压缩到低维潜空间,进一步降低了缓存的显存成本,使大规模缓存在经济上变得可行。在Codex这类Agent工作流中,AI会反复读取同一个项目的代码文件——每次工具调用后,完整的项目上下文都需要重新输入模型,因此缓存命中率极高。这解释了为什么7个项目仅花费5元——实际上绝大部分输入token都命中了缓存。而此前用 Claude 跑类似 7 个任务花了 900 多块——相差近 180 倍。这一价格差异不仅来自缓存策略,也反映了两家公司截然不同的商业模式:Anthropic以高价格维持高毛利,而DeepSeek采用激进的低价策略来快速获取开发者市场份额。
该怎么选?
基于这次测试,给出的实用建议是:
- 如果你刚学 AI 编程,或做日常小工具、内部系统、快速验证想法等不需要精细前端的任务,用 DeepSeek 完全没问题,能大幅节省成本。
- 如果你要做面向用户的产品,可以先用 DeepSeek 跑一遍 Demo、调通提示词、明确功能、跑通业务流程,再切换到 Claude 级别的模型做系统开发,既省钱又高效。这种「双模型工作流」正在成为越来越多专业AI开发者的标准实践——用低成本模型进行探索和原型验证,用高性能模型进行最终交付,在成本和质量之间取得最优平衡。
需要强调的是,这只是一次测试,不代表普遍规律。但至少在这次实战中,DeepSeek V4 Pro 的表现「远远不及预期」。它更像一个性价比极高的「打草稿」工具,而非能独当一面的产品级模型。你会把主力模型换成它吗?
相关推荐

SimpliSafe新款可视门铃:AI+真人保安主动盯防你的家门
SimpliSafe推出售价199.99美元的Video Doorbell Series 2可视门铃,搭配Active Guard主动安防服务,结合AI分析与真人监控坐席,实现家门口的主动威胁侦测与干预。本文解析其技术分工、订阅模式与隐私问题。
富士 Instax Pal 2 迷你相机:补齐屏幕短板的升级之作
富士发布 Instax Pal 2 迷你数码相机,相比初代新增屏幕与取景器,采用微缩化相机造型,补齐了初代盲拍的核心短板,成为一款更实用的便携即时成像设备。
Linux from Scratch:从零手工构建你的Linux系统
Linux from Scratch(LFS)是一个教你从源代码手工构建 Linux 系统的开源项目。本文介绍 LFS 的核心价值、BLFS/ALFS 项目生态及适用人群,帮助你理解 Linux 底层机制。