DeepSeek V4深度解析:混合注意力+流形约束+MOM优化器三大创新全解读

DeepSeek V4发布,以三大技术创新重登开源大模型王座
DeepSeek V4正式发布Flash和Pro两款模型,支持100万Token上下文窗口。Pro模型在推理、编程、Agent等核心指标上全面追平Claude Opus 4.6等顶尖闭源模型,同时API成本仅为其数分之一。底层架构实现混合注意力架构、流形约束超连接、MOM优化器三大技术创新,并全面适配国产昇腾芯片,摆脱对英伟达GPU的依赖。
DeepSeek V4概述:重登开源王座
DeepSeek广告 V4正式发布,这是继DeepSeek R1之后的首个大版本更新。本次共发布两款模型:主打超高性价比的DeepSeek V4 Flash,以及性能旗舰DeepSeek V4 Pro。两款模型全面升级至100万Token上下文窗口,其中Pro模型在推理、编程、Agent等核心指标上全面追平Claude Opus 4.6、Gemini 3.1 Pro、GPT 5.4等顶尖闭源模型,同时在开源模型中遥遥领先,堪称当前开源大模型的扛鼎之作。
更值得关注的是,DeepSeek V4在底层架构上实现了三大技术创新:混合注意力架构、流形约束超连接、以及MOM优化器,从根本上重构了模型的底层能力边界。
性能评测:全面对标顶尖闭源模型
官方基准测试成绩
根据官方评测数据,DeepSeek V4 Pro在多个维度展现出顶尖实力:
- 代码能力:CodeForces取得3206高分,MMT-266评测达到95.2%通过率
- Agent任务:SWE-Verify取得80.6分,BrowsCamp取得83.4分
- 综合表现:超越或持平GPT-5.4与Gemini 3.1 Pro的平均水平
不过在纯知识问答领域,DeepSeek V4与顶尖闭源模型仍有差距。在高度依赖参数记忆的SimpleQA评测中,Gemini 3.1 Pro以75.6分领先,DeepSeek V4 Pro得分57.9分。但横向对比开源阵营,DeepSeek V4各项指标全面领先于Qwen 3.5、Kimi K2.6和Gemma 5.1。
编程能力实测:兼容Claude Code
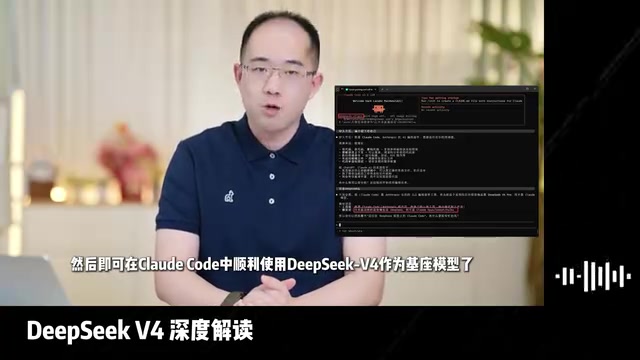
DeepSeek V4的API全面升级支持Anthropic端点,与Claude Code完全兼容。Anthropic为其Claude系列模型定义了一套标准化的API接口规范,包括消息格式、工具调用(Tool Use)协议和流式输出格式。MCP(Model Context Protocol)是Anthropic提出的开放协议,旨在标准化AI模型与外部工具、数据源之间的交互方式,类似于AI领域的「USB接口标准」。DeepSeek V4全面兼容Anthropic端点意味着开发者无需修改任何代码,即可在Claude Code、Cursor等工具中将底层模型替换为DeepSeek V4,同时保留MCP工具调用、长期记忆等全部高级功能。实测中,只需在配置项中写入DeepSeek官方的Anthropic接口端点,即可在Claude Code中直接使用DeepSeek V4作为基座模型。
团队将DeepSeek V4接入自研的Claude Code外部端项目后,MCP、Skills、Memories、Agile Teams等各项功能均能流畅运行,兼容性表现满分。
实测亮点:在接入Claude Code Agile Teams工具的情况下,DeepSeek V4 Pro仅需5分钟即可搭建出一整套Kapashi AM Wiki知识库检索系统——不仅能流畅展示知识库文档间的关联,还能顺利收发文档、流畅问答、深挖知识细节。
智能体性能:比肩Opus 4.6
将DeepSeek V4接入复范Open Cloud系统后,无论是Agent运行时的多步工具调用,还是Skills、MCP等扩展功能的加载运行,无论是长期记忆维护优化还是Computer Use操作本地电脑,体验都与Opus 4.6几乎没有差距。可以说DeepSeek V4 Pro的智能体性能已达到全球最顶尖水准。
性价比与部署方案
DeepSeek V4在保持顶尖性能的同时,API调用成本极具竞争力:
| 指标 | DeepSeek V4 Pro | Claude Opus 4.6 |
|---|---|---|
| 输入价格 | 12元/百万Token | 约36元/百万Token |
| 输出价格 | 24元/百万Token | 约168元/百万Token |
输入成本约为Opus 4.6的三分之一,输出成本不到七分之一,性价比优势非常明显。
在私有化部署方面,得益于MoE架构和底层创新带来的效率提升。混合专家架构(Mixture of Experts, MoE)是现代超大规模语言模型的核心设计范式:将模型的前馈网络层替换为多个「专家」子网络,每次推理时由门控路由器动态选择少数几个专家激活,而非激活全部参数。这使得模型可以拥有极大的总参数量(提升知识容量),同时每次推理只需激活一小部分参数(控制计算成本)。DeepSeek V4 Pro的1.6万亿总参数、每次仅激活49B的设计,正是MoE架构的典型体现——理论上拥有稠密模型的知识广度,实际推理成本却接近一个49B的小模型:
- V4 Pro:1.6万亿总参数,每次激活49B,实际运行显存约800G,双节点8卡A100/A800即可运行
- V4 Flash:284B总参数,每次激活13B,显存需求约150G,双卡A800或8卡4090即可运行
此外,DeepSeek V4支持混合推理模式自由切换,并全面适配国产昇腾系列芯片,彻底摆脱对英伟达GPU的依赖。华为昇腾(Ascend)系列AI芯片是目前国内最成熟的大规模AI训练和推理硬件平台,其软件栈CANN(Compute Architecture for Neural Networks)对标英伟达的CUDA生态。由于美国对华芯片出口管制持续收紧,H100、A100等高端英伟达GPU的获取受到严格限制,DeepSeek V4全面适配昇腾系列芯片,不仅对自身供应链安全具有战略意义,也为整个国内大模型生态提供了一个经过验证的「去英伟达依赖」技术路径参考——这是国产大模型发展进程中的一个重大里程碑。
三大核心技术创新深度解读
创新一:混合注意力架构——百万上下文的降本利器
标准Transformer的自注意力机制计算复杂度为O(n²),即序列长度翻倍,计算量和显存消耗将增加四倍。这意味着将上下文窗口从32K扩展到100万Token,若不做任何优化,显存需求将增加约1000倍,在工程上完全不可行。DeepSeek V4为此设计了三根管线同步作业的混合注意力机制,各司其职:
- CSA(压缩稀疏注意力):像智能漏斗,将历史信息按4:1轻度压缩,再用闪电索引器精准挑选最有价值的部分
相关推荐
 产品体验
程序员桌面布局指南:打造让你「回到家」的高效工作空间
探索程序员如何打造高效舒适的桌面布局。从多显示器配置到人体工学设计,解析技术工作者的桌面哲学,帮助你构建提升专注力与生产力的个人工作空间。
 产品体验
Qoder vs Cursor实测对比:同样20美金谁更强?
实测对比Qoder和Cursor两款AI IDE,从Agent自主修复能力、人工沟通次数、架构决策等维度评测。Qoder仅需2次沟通完成任务,Cursor需8次。详细分析两者差异,帮你选择最适合的AI编程工具。
 产品体验
Cursor云Agent演示:打通软件开发全链路瓶颈
深度解析Cursor云Agent最新Demo,展示如何通过云端虚拟机、自动测试产物和全链路控制平面,系统性消除软件开发生命周期中的人类瓶颈,让Agent自主运行、人按需介入。