DeepSeek工程师:开源是为了让AGI更快到来

DeepSeek工程师认为开源是为加速AGI到来,真正对手是时间而非同行。
文章围绕DeepSeek研究工程师对开源动机的分享展开,核心观点是开源并非为了打败同行,而是为了跑赢时间、加速AGI到来。作者指出,技术壁垒对单个公司是护城河,对行业却可能成为减速带,长期看会延缓整个AGI进程。DeepSeek因此选择放弃短期独占优势,换取领域加速演进的长期收益。在竞争心态上,文章强调大模型竞赛的真正对手是时间而非国内其他公司,同行不是零和博弈的对手,而是共同推进同一目标的参与者。开源还能带来外部反馈加速迭代、降低中小团队创新门槛等双重价值,并可能推动行业竞争逻辑从封闭比拼转向技术流动速度的比拼。
在人工智能领域,开源与闭源的路线之争从未停歇。DeepSeek研究工程师近日在B站分享了他对开源动机的思考,以及如何看待大模型公司之间的竞争。他的观点直白而深刻:开源不是为了打败同行,而是为了跑赢时间。
开源的核心动机:加速AGI的到来
这位工程师坦言,DeepSeek广告之所以将辛苦研究的成果开源,答案“非常简单”——推动AGI更快到达。在他看来,如果通过技术创新构建技术壁垒,短期内确实能阻挡对手追赶、获得领先优势,但把时间视野拉长,这种壁垒在阻挡别人的同时,也可能延缓整个AGI进程。
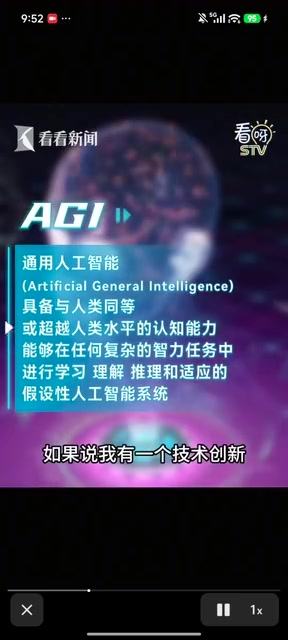
技术壁垒的双刃剑效应值得深思。对单个公司而言,壁垒是护城河;对行业而言,壁垒可能是减速带。DeepSeek选择开源,本质上是放弃短期独占优势,换取整个领域加速演进的长期收益。
AGI(通用人工智能) 是人工智能研究的一个长期目标,指能够在广泛任务上达到或超越人类水平能力的智能系统,与当前专注于特定任务的“窄人工智能”(如语音识别、图像分类、大语言模型问答)相对。AGI 并非一个严格定义的技术规格,而更像一个方向性概念:它强调跨领域泛化、自主学习和迁移能力。正因目标宏大且路径不确定,AGI 的进展高度依赖整个研究社区的协同探索,任何单一机构都难以独立完成全部基础突破。这也解释了为何“加速 AGI 到来”会成为一些团队选择开源的底层动机——开源能扩大参与面、加快试错频率,从而缩短从当前大模型能力到更通用智能之间的探索周期。
竞争心态:对手是时间,不是友商
“在人工智能的竞赛中,我个人认为我们的对手不是国内的其他大模型公司,而是时间。”这句表述点明了DeepSeek看待竞争的底层逻辑——无论哪家公司取得成果,本质上都是人类向AGI迈进的一步。
这种视角转换意味着,同行不是零和博弈的对手,而是共同推进同一目标的参与者。在算力、数据、人才都相对有限的现实约束下,开源能减少重复造轮子,让更多研究者站在已有成果上继续向前。
零和博弈 是博弈论中的概念,指一方所得恰为另一方所失、总收益恒为零的情形。在商业竞争中,零和视角假设市场份额、用户和利润是固定蛋糕,同行成功必然意味着自己失败。然而在大模型与 AGI 研发中,这一假设并不完全成立:基础模型能力的提升、工具链的成熟和评测方法的公开,往往具有正外部性,能被整个行业复用。DeepSeek 将“对手是时间”作为竞争框架,本质上是把同行关系从零和博弈重新定义为正和博弈——各方在共同推进技术前沿的过程中都能获益,竞争的重点转向谁能为整体进程贡献更多有效进展。
开源的双重价值
从工程角度看,开源带来的外部反馈能加速模型迭代,社区贡献的优化、工具链和评测方法,往往比闭门造车更高效。从生态角度看,开源降低了中小团队和研究者的准入门槛,让更多创新在开源基座上发生。DeepSeek的实践表明,开源并非慈善行为,而是一种战略选择——用生态的厚度对冲单点领先的脆弱性。
技术壁垒 通常指企业通过专利、专有数据、独特算法或工程经验构建的竞争护城河,使竞争对手难以在短期内复制其能力。在大模型领域,技术壁垒可能表现为高质量训练数据、分布式训练基础设施、对齐与评测方法等。壁垒对持有者而言能带来定价权和领先窗口,但对整个行业而言,重复研发和封闭探索会降低知识流动效率。开源则相当于主动降低部分壁垒,把内部成果转化为公共知识资产,使外部研究者能在同一基座上继续改进。这种策略并不否定壁垒的价值,而是权衡其短期保护作用与长期可能延缓行业整体进展的风险。
对行业的启示
当头部模型公司开始将“对手是时间”作为共识,大模型竞争的逻辑可能从比拼谁更封闭,转向比拼谁能让技术更快流动。开源不是放弃竞争,而是把竞争提升到更高维度:比谁对AGI进程的贡献更大。这一判断是否正确,最终要看时间给出的答案。
相关推荐

GPT-6 Astra读权重绝技:仅限小网络,实用靠写代码
GPT-6 Astra能直接读网络权重,但无工具设置仅限约17万权重的小网络。修复QUEN 3.5 0.8b推理循环靠写Python和50批练习,实测识别游戏耗时近一小时。本文梳理能力边界与两个安全提醒。

GPT-6 Astra 改写 Qwen 权重:7.9% 到 48.1%,是学会了数学还是学会了停?
MIT研究者用GPT-6 Astra直接编辑Qwen权重,数学得分从7.9%升至48.1%,全程无训练。但独立复现显示,提升主要来自修复循环、让模型学会终止作答,而非新增数学能力。

Qwen 3.8 27B 真能读懂神经网络权重?16GB 实测揭秘
MIT 研究声称大模型能直接读取神经网络权重并识别训练游戏。我们在 16GB 显卡上实测 Qwen 3.8 27B,发现信号真实存在,但“原生读取”说法不成立,25 行 Python 脚本即可秒级还原答案。