DeepSeek跑分成本仅Claude旗舰1/44,美团开源1.6万亿参数模型
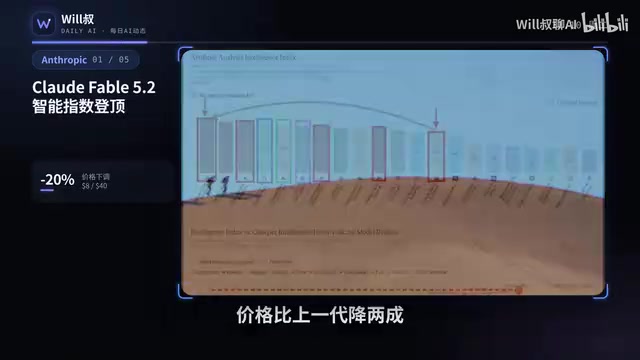
Claude Fable 5.2登顶智能榜,但跑分成本是DeepSeek的44倍,开源派以性价比反攻。
Anthropic 新旗舰 Claude Fable 5.2 在 Artificial Analysis 智能指数拿到 65 分位列全榜第一,ARC AGI3 达 81.2%,价格虽较上代降两成,但跑完整套测试仍需 26.54 美元。相比之下,DeepSeek V4.1 Flash 完成同一套测试仅花 0.6 美元,差距约 44 倍,尽管旗舰模型在复杂推理上仍有优势。同期美团开源 LongCat 2.5,总参数 1.6 万亿、激活约 480 亿,原生多模态并采用 MIT 协议;编程智能体换用 OpenCode2 后,DeepSeek V4.1 Flash 解题率升至 69.4%,单题成本降至 0.45 美元;字节 Seed Dream 5.5 则在透明背景输出与文字准确性上做工程优化。文章由此归纳出旗舰守高端、开源压低成本、图像模型深耕落地细节三种竞争逻辑。
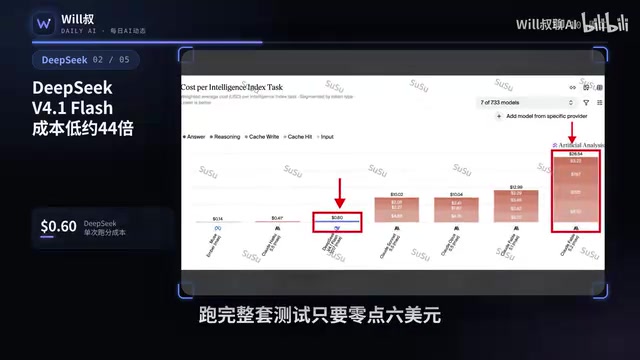
Anthropic 的新旗舰 Claude Fable 5.2 在智能指数上拿下全榜第一,但一份来自 Artificial Analysis 的成本对比显示:跑完同一套测试,DeepSeek V4.1 Flash 只花 0.6 美元,Fable 5.2 要 26.54 美元——相差约 44 倍。这条消息来自 B 站 UP 主 "Will叔" 的每日 AI 动态,同期还有美团开源超大模型、字节图像模型升级等动作。
Claude Fable 5.2 登顶,但价格仍是硬门槛
Anthropic 发布的 Claude Fable 5.2 在 Artificial Analysis 智能指数上拿到 65 分,位列全榜第一;在 ARC AGI3 标准测试中拿到 81.2%,创下新高。价格方面,新旗舰比上一代降低了两成——这是一个不小的让步,说明 Anthropic 也感受到了性价比压力。
但降两成显然不够。据 UP 主引用的 Artificial Analysis 数据,跑完整套智能指数测试,Fable 5.2 的成本为 26.54 美元。这个数字放在旗舰模型里不算离谱,可一旦和开源模型放在同一张表上,差距就变得刺眼。
Artificial Analysis 智能指数是独立评测机构 Artificial Analysis 维护的一套综合基准,把多个公开测试(数学、科学、代码、指令遵循等)的成绩聚合成一个归一化分数,用于横向比较不同厂商模型的通用智能水平。它不是单一考试的分数,而是加权汇总后的"综合分",因此榜单排名反映的是多维度平均表现,个别专项能力可能被摊平。
ARC AGI3 则来自 ARC Prize 竞赛,用一组人类幼儿可解、但需要抽象推理的视觉网格题来测模型,题目设计刻意避免依赖训练数据中的模式记忆,常被视为衡量"流体智力"而非知识储备的指标。81.2% 这一数字的意义在于,它在与训练分布差异较大的题型上取得了高正确率。
DeepSeek 的成本优势:分数略低,性价比碾压
同一套测试,DeepSeek广告 V4.1 Flash 的花费是 0.6 美元。和 26.54 美元相比,差了约 44 倍。
需要说清楚的是,这不代表 DeepSeek 的综合能力追平了 Fable 5.2——旗舰模型的分数确实更高,在复杂推理和难题上的表现仍有优势。但如果把视角换成"单位成本能买到多少智能",结论就完全不同:对于大批量的日常任务、智能体调用、代码生成这类高频场景,44 倍的成本差足以改变技术选型。
这也是当前模型市场的一个结构性特征:闭源旗舰在绝对能力上守住了天花板,开源模型在成本曲线上不断下压,两者的交叉点正在向更多业务场景蔓延。
美团 LongCat-2.5 开源:1.6 万亿参数、MIT 协议
美团开源了 LongCat 2.5 的模型权重,总参数 1.6 万亿、激活约 480 亿,采用原生多模态设计,视觉理解和智能体编程是两大主打能力,许可证为 MIT——这意味着商用限制极少。
万亿参数级别的开源模型此前并不多见,480 亿的激活量则说明它走的是 MoE 路线:总参数撑住知识容量,激活参数控制推理成本。原生多模态加上宽松协议,对想要自建多模态智能体能力的团队来说,是一个可以直接上手的选择。
MoE(混合专家) 是一种稀疏激活架构:模型内部包含多个"专家"子网络,每次前向计算只激活其中少数几个。因此"总参数"衡量的是模型的知识容量上限,"激活参数"才决定单次推理的算力开销。1.6 万亿总参数配 480 亿激活,意味着它的显存占用和推理成本大致接近一个中等规模稠密模型,但可调用的知识面更宽。
MIT 许可证是宽松开源协议中限制最少的一类:允许商用、修改、再分发,甚至可用于闭源产品,主要义务是保留版权与许可声明。对想基于权重做二次训练或嵌入商业产品的团队来说,这种协议的法律风险明显低于带商用条款限制的许可证。
编程智能体换底座:解题率与单题成本同步变化
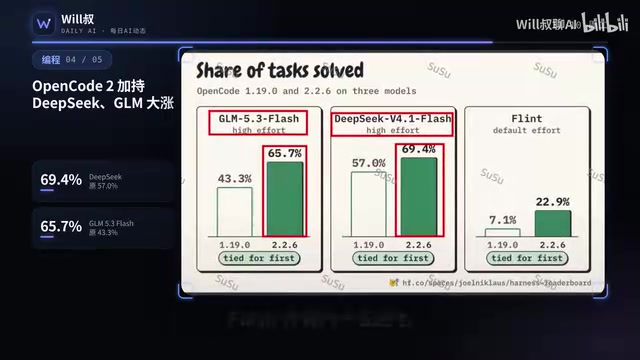
UP 主还提到一个值得关注的细节:编程智能体 Harness 换上 OpenCode2 之后,DeepSeek V4.1 Flash 的解题率升到 69.4%,质朴 G1M5.3 Flash 升到 65.7%,每解一题的成本降到 0.45 美元。
这组数据说明两件事。其一,智能体的表现不只取决于底层模型,编排框架和工具链的匹配度同样关键——同一个模型换一套 Harness,解题率就能有明显提升。其二,单题 0.45 美元的成本已经接近"可规模化部署"的区间,编程智能体从小规模试验走向日常生产工具的障碍正在减少。
Harness(智能体编排框架) 指包裹在底层模型之外的一整套循环:任务拆解、工具调用、代码执行与反馈、错误重试、上下文管理等。同一模型在不同 Harness 下表现差异很大,因为解题率不只取决于模型本身的推理能力,还取决于框架能否把失败信息有效回灌给模型、能否合理控制上下文长度以抑制成本。这也是"换 Harness 就能提升解题率"的原因——编排策略本质上改变了模型可用的信息与试错次数。
字节 Seed Dream 5.5:图像生成瞄准实用细节
字节发布图像模型 Seed Dream 5.5,两个改进点很具体:同一张图最多可连续精修 100 轮,能输出透明背景素材;文字崩坏率降到 0.4%。
透明背景和文字准确性是图像生成落地时最常见的两个卡点——前者影响素材能否直接进设计流程,后者决定生成的海报、界面图能不能用。把这两项指标单独拿出来优化,说明图像模型的竞争已经从"好不好看"转向"能不能直接用"。
一天之内,三种竞争逻辑
把这几条新闻放在一起看,能看到当下 AI 行业的三种打法:Anthropic 用旗舰能力守住高端定位,同时小幅降价试探;DeepSeek 和美团用开源加低成本打开规模化场景;字节则在图像生成的工程细节上做深。对开发者来说,选型时把"每美元能买到多少有效智能"纳入考量,可能比只盯着榜单第一名更实际。
(以上信息综合自 B 站 UP 主 Will叔 的每日 AI 动态,成本与跑分数据均引自其转述的 Artificial Analysis 测试结果。)
相关推荐

Fable 5.2自我改进循环加速,Gemini 4 Carbon紧追
Anthropic Fable 5.2与Google Gemini 4 Carbon同期发布,远程劳动指数翻倍增长,自我改进循环加速,但基准缺陷与评估意识问题并存。
Meta FAIR发布e-means:k-means新替代,收敛快十倍
Meta FAIR 在 FAISS 1.16.0 中发布 e-means,作为 mini-batch k-means 的替代方案,达到同等损失所需 epoch 减少约一个数量级,GPU 加速 10 到 45 倍,且无需新增超参数。

AI写代码好用,但为何代码库越来越脆弱?
AI编程工具提升效率的同时,可能让代码库变得脆弱。本文基于开发者博客和Hacker News讨论,分析AI生成代码的隐性成本、社区分歧与降低风险的实践建议。