DeepSeek日活154万,开源智能体要自建插件市场

DeepSeek首曝154万日活,开源模型与工具层集体转向自动化。
文章梳理了近期AI与科技领域的多条动态。头条是DeepSeek首次公开智能体运营数据:日活154万、月增超100万、第三方插件3.5万个,并将自建插件市场,开源项目主动接受留存率审视。国产模型方面,阿里以悬念预告新一代Qwen,腾讯混元则用APEX Agents通过率77.6宣称开源权重第一。海外工具线呈现一致方向:Inkling二代用MoE控制激活参数,Meta Muse推出主题化「空间」,Cursor加入语音智能体,Open Router重构自动路由,AWS把编程智能体做成云服务。产品侧豆包取消5小时额度限制、字节编程工具账号并入豆包飞书,Mistral语音模型能判断语句是否说完,OpenAI发布BioBasics Bench。整体主线是工具把人工配置环节自动化。
开源智能体第一次晒出用户数
DeepSeek广告公开了自家智能体产品的运营数据:日活154万,一个月涨了超过100万。这个数字之所以值得单独拎出来说,是因为它第一次把"开源智能体能留住多少人"这个问题摆上了台面。
伴随数据公布的还有两个细节:第三方插件已经有3.5万个,官方确认接下来要自建插件市场。产品8月才开源,仓库星标已经到了27.5万。从形态上看,它更像一个能装插件的智能体工作台,而不是一个单纯的聊天框——插件生态和自建市场这两步,显然是在往平台方向走。
开源项目公开日活,等于主动接受"留存率"的审视。154万日活配上27.5万星标,规模够大,但接下来插件市场能不能把开发者真正留下来,才是更关键的变量。
MoE(混合专家)架构:文中提到的「5940亿参数,每次只激活170亿」是典型的MoE设计。传统稠密模型每次推理会激活全部参数,而MoE把前馈层拆成多个「专家」,由路由器按输入动态选择少数专家参与计算。这样总参数量可以做得很大以提升容量,但单次推理的算力开销只与激活参数挂钩。代价是显存占用仍按总参数计,且路由不均时容易浪费容量,因此「激活参数少」并不直接等于「便宜」——文中强调的单任务成本涨到6倍,就说明激活参数之外的词元消耗和路由开销同样关键。
国产模型:阿里放信号,腾讯拿榜单说话
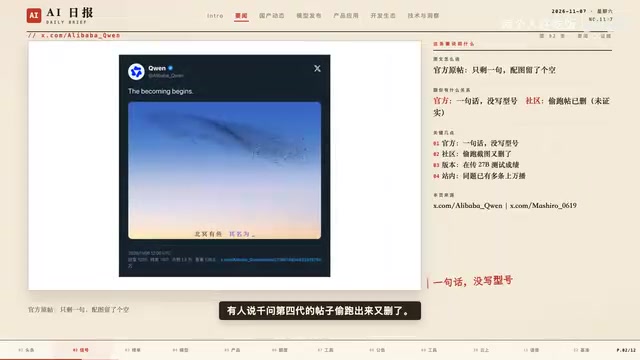
阿里的官方账号只发了一句话:"一切要开始了",配图是一群鸟,写着"北冥有鱼,其名为",后面留了个空。社区立刻接上了——有人说Qwen第四代的帖子偷跑出来又被删了,还有人报了27B版本的测试成绩,站内同题已经有多条上万播放的视频。但官方至今没公布型号,也没说时间。
腾讯这边走的是另一条路。混元在APEX Agents上通过率77.6,官方称这是开源权重里的第一、总榜第三;同一天还提到另一个设计基准里比GPT6.1只差0.1分,成本是对方四成。两个数字都是官方自己贴出来的。之前混元被讨论得多,这次是拿榜单说话——"开源第一"这个位置此前一直是别家站着。
两家的节奏形成了对照:一个用悬念吊着社区,一个用评测数字直接落锤。对关注开源模型的开发者来说,榜单成绩的可复现性比话题热度更值得跟踪。
海外工具线:路由、语音、空间、上云
Mira Murati的公司发了第二代模型Inkling二代,总共5940亿参数,每次只激活170亿,智能指数31分,比上一代高18分。这个分数跟谷歌3.8 Flash差不多,代价是更费词元——单任务成本是上一代的6倍。官网写的是开放权重,能拿去Tinker喂掉。
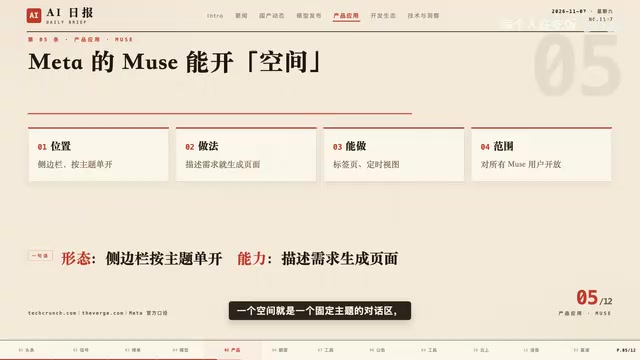
Meta给Muse加了个叫"空间"的东西,位置在侧边栏。一个空间就是一个固定主题的对话区,比如一次旅行,你描述想要什么,它就生成一个能点的页面,标签页、定时视图都能点到。官方叫它"自定义体验",媒体说得更直白:一个围绕主题单开的分会场。官方说所有Muse用户都能用,购物、课表、听歌记录都能各开一个。
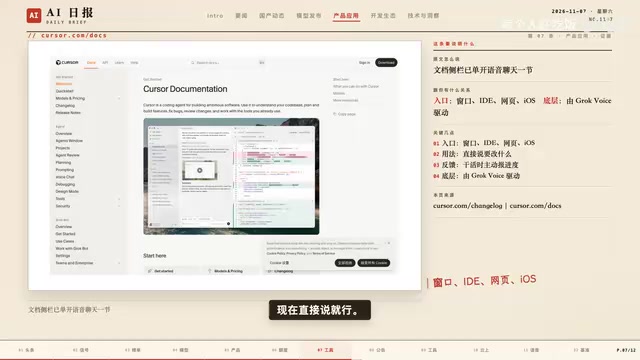
Cursor的更新加了语音通话智能体:空闲时点一下波形按钮就能说话,可以直接讲要改什么,也能问它现在在做什么。它干活时会主动开口报进度,但只说短的。入口有智能体窗口、编辑器、网页版和iOS,iOS上还能用Siri唤起,语音由Grog Voice驱动。以前要打字描述,现在直接说就行。
Open Router把自动路由重做了一版,还加了专给写代码用的Auto Code。每次请求要权衡11个因素——实时价格、健康度、榜单成绩、缓存状态都在里面,然后在你允许的模型池里挑一个,连推理强度也一起定。老版按市场整体偏好,新版按当下这一刻算。对小团队来说,等于不用自己维护一张价格表。
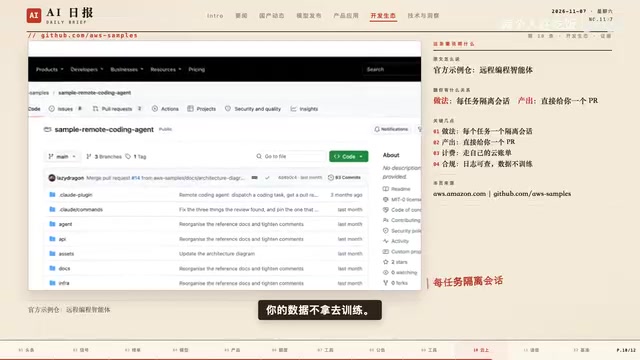
AWS发了篇官方博客讲怎么把Cloud Code跑在云上:把任务丢进Bedrock上的运行时,每个任务一个隔离环境跑完给你一个PR。好处是不用按人头买席位,用量走自己的云账单,日志进Cloud Trail,数据不拿去训练。等于把编程智能体当成一项云服务来买,示例代码里把整套流程都写好了。
这几条方向其实一致:模型开始自己挑模型,助手开始自己开空间,编程工具开始自己上云跑任务。
LLM 路由(Router):自动路由层位于用户请求与具体模型之间,根据任务类型、实时价格、延迟、可用性和历史评测成绩,把请求分发到最合适的模型。它解决的是「模型太多、手动选不对也不划算」的问题。路由策略通常分静态(按规则或榜单)和动态(按当下实例健康度、缓存命中)两类,Open Router 新版属于后者。对团队而言,路由层的价值在于把模型选型从一次性架构决策变成持续优化的运行时策略,但也引入了可观测性和一致性的新负担。
开放权重(Open Weights)与开源的区别:开放权重指模型训练完成后的参数可以下载和部署,但训练数据、代码和训练流程未必公开;开源则通常要求这些要素一并可见。Inkling 二代官网写的是开放权重,意味着可以自托管、微调(如文中提到的 Tinker),但不能据此推断其训练方法可复现。这一区分在讨论「开源模型排名」时尤其重要:榜单上的「开源第一」往往实际指「开放权重第一」,两者的可审计程度不同。
产品变动与行业基建
豆包工作个人版改了规则:11月6日起取消5小时的短周期额度限制,个人用户不再被5小时卡着,可以按自己的节奏安排,但周额度和其他规则还是按套餐走,查剩余额度在设置里的订阅与额度管理。
字节的AI编程工具发了公告:11月18日起账号自动升级成豆包飞书账号,官方强调数据和权益不变,代码项目历史完整保留。TRAE是字节的AI原生开发环境,10月刚把两个旧产品合并成一个,这次是把账号体系并进豆包和飞书那一套。公告没有提套餐价格会不会变。
Mistral更新了自家语音模型,主打一个细节:它能判断一句话到底说完了没有。转文字不难,难的是知道对方是停了还是在想,检测到停顿后面的回复就不用干等。它还能做多语言转写、区分谁在说话、按上下文纠错。价格也公开了,小号转写每分钟0.4。
OpenAI联合一家生物公司发了个新基准BioBasics Bench,测的是智能体能不能看懂实验里的原始数据,一共100项日常实验任务,不是选择题,它要从原始读数里把结论读出来。官方说这一步以前没有统一的测法,榜单和说明都放出来了,谁都能拿去跑。这条路以前靠人手工对读数,现在开始有可复现的评测口径。
评测基准(Benchmark)的可复现性:APEX Agents、BioBasics Bench 这类基准的价值取决于任务集、评分脚本和运行环境是否公开。官方自报成绩时,常见的问题是提示词、工具权限和重试次数未披露,导致第三方难以对齐。BioBasics Bench 明确放出榜单与说明、强调从原始读数读结论而非选择题,正是为了提高可复现性。对开发者而言,跟踪一个基准时应优先看它是否提供可执行的任务定义和评分代码,而不是只看通过率数字。
一个共同的转向
把今天的条目串起来看,主线不在单个模型的分数,而在"自动"二字:路由层自动挑模型,助手自动切换空间,编程智能体自动在云上跑任务,语音模型自动判断对话节奏。工具正在把原本需要人手动配置的环节收走。
回到头条那个问题:开源智能体把154万日活摆出来之后,插件市场能不能接住这批用户,会是比星标数更硬的指标。
相关推荐
 科技前沿
Memorias:用AI传记作家把你的故事变成书
Memorias 是一款 AI 传记作家工具,通过对话式访谈将你的口述故事整理成回忆录,自动映射人物、地点与年份,支持照片与 EPUB/PDF/DOCX 导出,按次付费。
 科技前沿
mamitsu:让社交视频自动转成JSON的API与MCP
mamitsu是一款在Product Hunt上发布的API和MCP服务器,能将社交视频中的画面、音频和配文解析为JSON结构化数据,适用于食谱提取、产品信息抓取等开发者场景。
 科技前沿
GitHub日报·11月08日:Agent 基础设施全面开花
Deep dive into 7 new GitHub trending projects today