DeepSeek语音接口实测:10种语言自由切换,1元搭建语音助手

DeepSeek语音接口实测:十语种自动识别,但文档未写的格式、时长、流式合成和计费坑需注意。
DeepSeek 新开放的语音接口提供海星和暗潮两个音色,支持中文、粤语、英语等十种语言自动识别,无需手动标注语种。将语音合成、语音识别与联网搜索、文件读取串联,可拼出完整语音助手,实测首字延迟约3秒,但日期等实时信息需每次注入上下文。文档未写的三个坑包括:Chrome默认录音格式不被识别需转WAV、识别音频超过120秒报错、流式合成实际要等文字发完才开口。计费方面,联网搜索按查询词数量计费导致界面显示与账单不符,max tokens设太小会被搜索过程消耗导致回答为空。两轮测试总花费不到1元,成本门槛低,但接入产品前需确认音频格式转换、长音频切段、上下文注入、搜索计费和输出预算等清单项。
DeepSeek 在语音交互上迈出了实质性一步。最新开放的语音接口支持同一音色讲十种语言,还能自动识别语种、联网搜索、朗读文件。B站UP主用不到一块钱实测后,发现了几个文档里没写清楚的坑,这些细节对想把它接入产品的开发者尤其重要。
两个音色,十种语言,不用告诉它说的是什么
接口提供两个音色:女声「海星」和男声「暗潮」。同一句话用两种音色念出来,风格差异明显,但都保持了自然流畅的节奏。
最省心的地方在于语种自动判断。你不需要提前标注「这是粤语」「这是阿拉伯语」,模型自己会识别。实测覆盖十种语言:中文、粤语、英语、马来语、印尼语、日语、韩语、泰语、越南语和阿拉伯语。
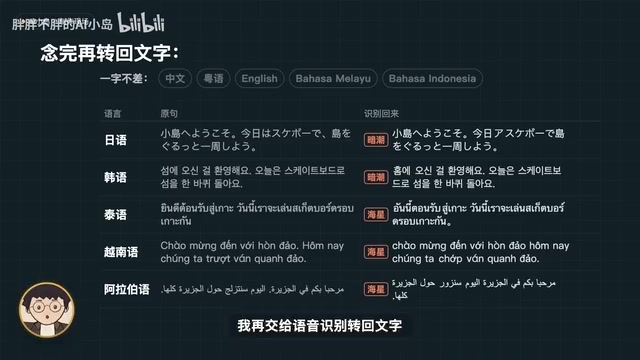
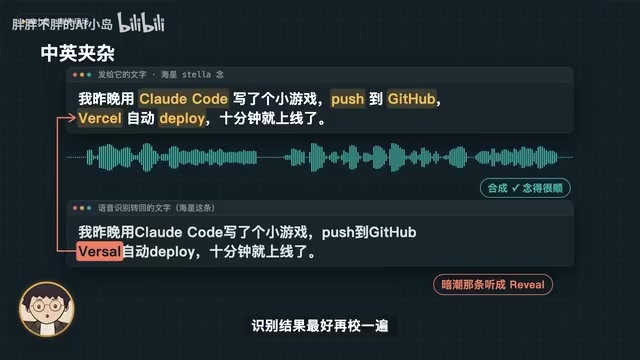
把合成语音再交给语音识别转回文字,前十种语言里中文、粤语、英语、马来语、印尼语一字不差,日语、韩语、泰语、越南语和阿拉伯语则各有个别词听错。更贴近日常的场景是中英夹杂——「我昨晚用 cloud code 写了个小游戏 push 到 github,Vercel 自动 deploy,十分钟就上线了」这种句子念得很顺,但转回文字时 Vercel 被听成了 Vercel。专有名词密集的地方,识别结果反而最好,这符合语言模型对上下文依赖的直觉。
能听、能说、还能连网,拼起来就是一个语音助手
语音合成和语音识别单独拿出来都不新鲜,但把它们和联网搜索、网页读取、文件读取串在一起,就能拼出一个完整的语音助手。
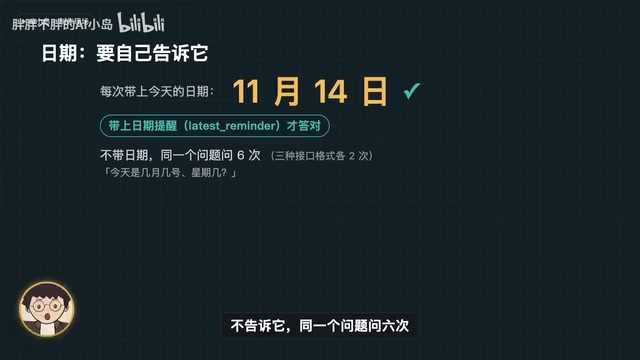
UP主用自己的声音做了测试:问「今天几号,杭州明天会下雨吗」,从说完到模型开口用了 4.7 秒,其中听懂问题用了 0.9 秒,3 秒出第一个字,第一句话一写完就立刻合成,不等整段文本生成完。这个流式策略让首字延迟控制在可接受范围内,日期也答对了——前提是每次对话都告诉它「今天几号」。
如果不给日期上下文,同一个问题问 6 次会得到 5 个不同的日期,没有一个是对的。而且这条日期消息必须紧挨着用户的提问,中间插一条系统提示,接口直接报错。这说明模型本身没有内建时钟,时间感知完全依赖上下文注入。
首字延迟(Time to First Token, TTFT)是衡量语音交互体验的关键指标,指的是从用户说完最后一个字到系统输出第一个语音片段之间的时间间隔。在人类对话中,自然的轮转间隔通常在200毫秒到1秒之间,超过2秒就会明显感到卡顿。语音助手场景下,首字延迟由三部分构成:语音识别耗时(音频转文字)、语言模型生成首字耗时、语音合成启动耗时。文中提到的4.7秒总延迟中,识别占0.9秒,生成首字约3秒,剩余时间用于合成启动。业界通常通过流式识别、流式生成和流式合成三段流水线并行来压低这一指标,但受限于模型推理速度,目前多数语音助手端到端首字延迟仍在2-4秒区间。
上下文注入是大模型应用中的常见工程手段,指在用户提问前通过系统提示或前置消息向模型提供其训练数据中不具备的实时信息,如当前日期、用户位置、账户状态等。由于大语言模型的知识截止于训练数据的时间点,且推理时无法主动获取外部实时状态,任何涉及“今天”“现在”的查询都必须依赖外部注入。文中日期消息必须紧挨用户提问、中间插入系统提示即报错的现象,说明该接口对消息顺序有严格约束,开发者在构造多轮对话时需将动态上下文作为紧邻的用户侧消息或特定角色消息传入,而非随意插入系统提示。
文档没写的三个坑:格式、时长、流式合成
识别不收 Chrome 默认录音格式。 Chrome 浏览器默认录出来的音频格式不被接口接受,需要自己转成 WAV 再上传。
超过 120 秒直接报错。 语音识别有硬性时长上限,长音频必须自己切段。
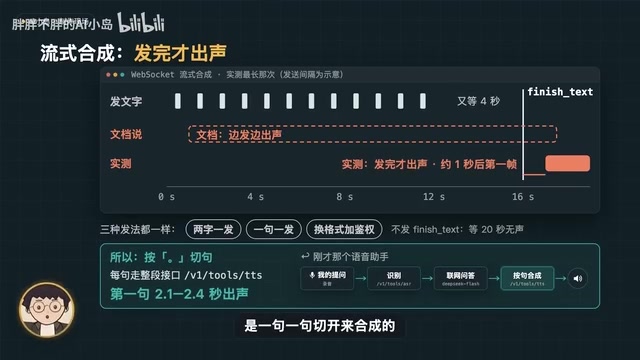
流式合成不是「边说边出」。 文档说可以边发文字边出声,但实测三种发法都要等用户把文字发完,模型才开口。所以前面那个语音助手是一句一句切开、逐句合成的,不是真正的边输入边输出。
流式合成(Streaming TTS)与流式生成(Streaming LLM)是两个不同层面的概念。流式生成指语言模型逐 token 输出文本,流式合成指语音合成引擎在接收到部分文本时即开始生成音频,二者结合理论上可实现“边生成边出声”。但实际系统中,流式合成往往需要等待一个完整的语义单元(如一句话或一个子句)才能启动,因为语音合成对文本的韵律和上下文有依赖,过短的碎片会导致音质下降或语调断裂。文中“要等用户把文字发完才开口”的现象,说明该接口的流式合成并非真正的 token 级流式,而是以完整请求为单位的批处理,开发者需自行按句切分调用来模拟流式体验。
账单里容易忽略的两处计费细节
联网搜索在服务端完成,读网页、读文件都不用自己实现,但账单上有两个地方要盯紧。
第一处是搜索次数。界面上只显示搜了一次,账单却记了 4 次,因为计费按查询词数量算,一次请求带多个查询词就按多个计。
第二处是 max tokens。设成 300 时,钱花了、搜了 6 次,回答却是空的——输出预算被搜索过程和中间步骤消耗掉,留给最终回答的空间不够。参数设置需要给搜索留出余量,不能按纯文本生成的直觉来配。
max tokens 是大模型 API 中控制单次请求输出长度的参数,但它的计量范围通常包括模型生成的全部 token,而不仅是最终回答。在带联网搜索的请求中,模型可能需要先生成搜索查询词、再根据搜索结果生成中间推理步骤,这些 token 都计入输出预算。若 max tokens 设置过小,预算可能在搜索和推理阶段就被耗尽,导致最终回答为空。业界建议在启用工具调用的场景下,将 max tokens 设置为纯文本生成场景的 2-3 倍,或根据查询复杂度动态调整,以确保最终回答有足够的输出空间。
接入产品前值得整理的那张清单
前后两轮测试总共花了不到一块钱,成本门槛很低,但要把这套接口接进真实产品,至少需要确认几件事:音频格式转换链路是否就绪、长音频切段策略是否明确、日期等实时信息是否每次注入、搜索计费是否按查询词预估、max tokens 是否给最终回答留够空间、流式合成是否按句切分调用。UP主把这些整理成了一张清单,截图就能直接用。
以不到一块钱的成本,换来一个会说十种语言、能联网、能读文件的语音助手原型,这个投入产出比相当可观。剩下的问题不是「能不能做」,而是「你会拿它做个什么」。
相关推荐

12k星开源神器free-claude-code:免费模型接入Claude客户端
free-claude-code开源项目获1.2万星,通过反向代理层将免费模型接入Claude客户端,支持61家模型源、RTK上下文压缩和智能熔断多Key轮换,本文深度解析其工作原理、部署方式与性能实测。

团队如何共用 Claude Code?约定文件、评审与权限边界
团队共用 Claude Code 时,如何通过约定文件统一上下文、建立代码评审机制并设置权限边界?本文基于实际演示,梳理三个关键实践,帮助团队安全高效地利用 AI 编程助手。

DeepSeek开放App全套API能力,Qwen4定档11.17|AI日报
DeepSeek将官方App的联网搜索、文件解析、OCR、语音识别与合成等能力开放为API并开源前端Demo;阿里Qwen4定档11月17日主打编程与Agent;腾讯混元HY4安全指数登顶并开源Flash TopK大幅提速;OpenAI解散机器人团队。