Devin 推出 Code Scans:让工程目标自动转化为代码改进
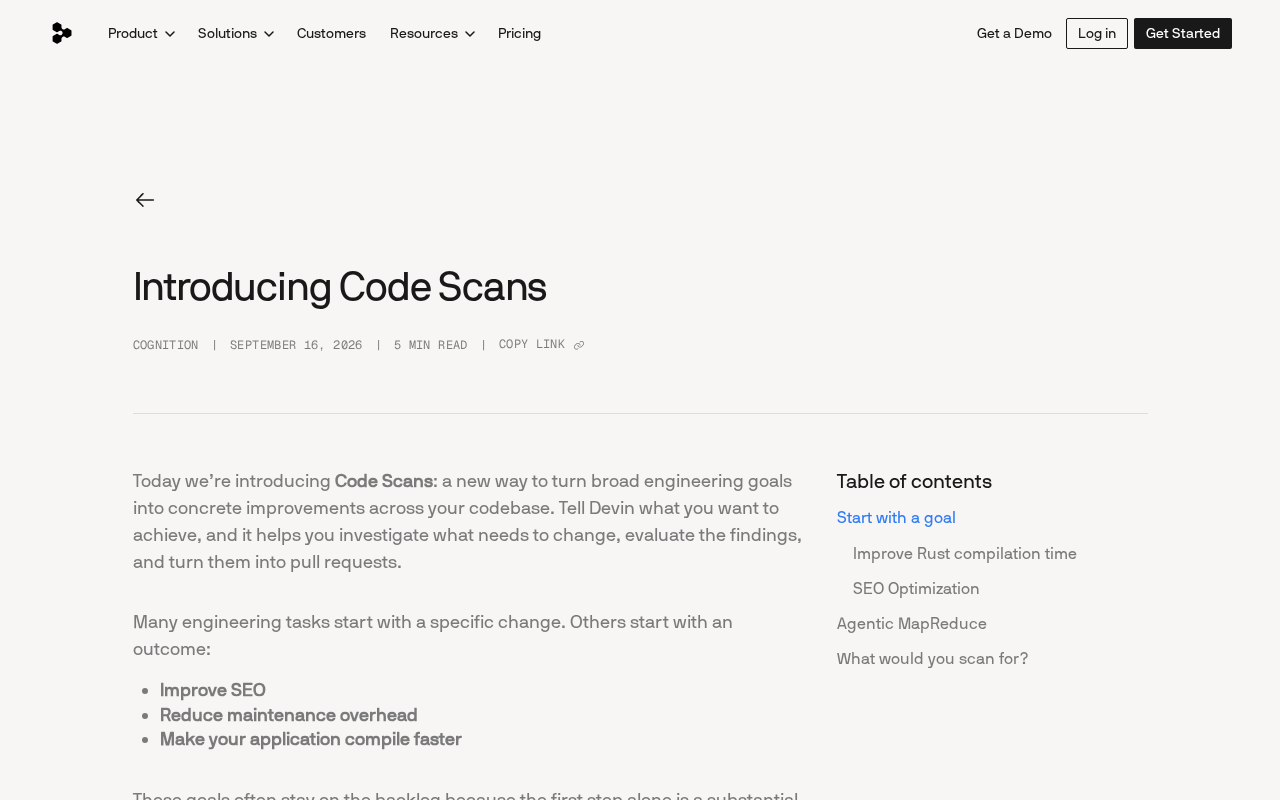
Devin新功能Code Scans可将模糊工程目标自动转化为可审查的Pull Request,让AI从指令执行者升级为主动代码库维护者。
Cognition旗下AI软件工程师Devin推出的Code Scans功能,旨在填补AI编程工具长期以来的空白:处理"提升代码整体质量"这类目标宽泛、范围广的任务。其工作流分为调查、评估、生成PR三个阶段——Devin先主动扫描代码库定位问题,再筛选真正值得改动的部分,最终以Pull Request形式输出,保留人类开发者的最终审查权。这种"意图驱动"的交互模式更贴近架构师视角,适合技术债清理、代码规范统一、大范围重构等横向任务。当前官方信息较简略,评估准确率和大型代码库表现等关键细节仍待实际验证。
Code Scans 是什么
Cognition 旗下的 AI 软件工程师 Devin 近期发布了新功能 Code Scans。它的核心理念很直接:将宽泛的工程目标转化为代码库中的具体改进。开发者只需告诉 Devin 想要达成什么,它就会主动调查哪些地方需要修改、评估这些发现的价值,并最终把它们变成一个个可审查的 Pull Request(PR)。
这一功能填补了 AI 编程助手长期以来的一个空白:大多数工具擅长响应明确、具体的指令(如"修复这个 bug"或"给这个函数写测试"),但很难处理"提升代码库整体质量"这类目标模糊、范围广的任务。Code Scans 试图让 AI 从被动执行者转变为主动的代码库维护者。
Devin 是 Cognition AI 于 2024 年发布的 AI 软件工程师产品,定位为能够独立完成端到端软件开发任务的智能体(Agent),而非单纯的代码补全或问答工具。与 GitHub Copilot 等以"辅助建议"为核心的工具不同,Devin 能够自主调用终端、浏览器、代码编辑器等环境,执行多步骤的复杂任务。Code Scans 是建立在这一 Agent 架构之上的新能力——正是因为 Devin 具备主动探索和规划的底层能力,才使得"给一个宽泛目标、让它自行拆解执行"这种交互方式成为可能。
从目标到 PR 的工作流
根据官方描述,Code Scans 的运行逻辑可以拆解为三个阶段。
调查阶段
当你设定一个高层目标——例如"减少代码库中的技术债"或"统一错误处理模式"——Devin 会先主动扫描整个代码库,定位与该目标相关的具体位置。这一步的价值在于,它把人类通常需要花大量时间做的"发现问题在哪里"的工作自动化了。
评估阶段
找到潜在改进点后,Devin 并不会盲目动手,而是对这些发现进行评估(evaluates the findings)。这意味着系统会判断哪些修改真正值得做、哪些可能引入风险,从而对结果进行筛选和优先级排序。这一步对于避免"噪音式改动"至关重要。
生成 PR 阶段
最后,Devin 将评估后的改进转化为 Pull Request。这一设计保留了人类开发者的最终把关权——所有改动都以 PR 的形式呈现,团队可以按照既有的代码审查流程进行 review、讨论和合并,而不是让 AI 直接改动主分支。
Pull Request(PR)是现代软件团队中最核心的协作机制之一。开发者在独立分支上完成修改后,通过 PR 向目标分支发起合并请求,团队成员可在合并前对代码进行逐行审查、留下评论、触发自动化测试(CI/CD)。这一流程既是质量把关的关卡,也形成了完整的变更历史记录。Devin 选择以 PR 而非直接提交作为输出形式,本质上是将 AI 产出纳入已被工程团队广泛接受的治理框架中,使 AI 的自主性与团队的可控性达到平衡。对于已有成熟代码审查文化的团队,这种"AI 提案、人类决策"的模式阻力最小,也最容易落地。
为什么这个模式值得关注
将"广泛目标"作为输入,是 Code Scans 与传统 AI 编程工具最大的区别。过去开发者与 AI 协作时,往往需要把大任务手动拆解成一个个小任务再交给工具执行。Code Scans 把这层拆解也交给了 AI:你描述意图,它负责规划和落地。
这种"意图驱动"的交互方式,更贴近团队负责人或架构师的实际工作视角。他们关心的往往不是单个函数怎么写,而是整个系统的健康度、一致性和长期可维护性。Code Scans 让这类高层意图有了可执行的路径。
以 PR 作为交付物的选择也很务实。它没有绕开现有的软件工程协作流程,而是嵌入其中。代码审查、CI 检查、团队讨论这些既有环节依然发挥作用,AI 的产出被纳入可控、可追溯的工程实践中,降低了盲目信任 AI 带来的风险。
潜在的应用场景
基于官方给出的信息,Code Scans 适合处理一类过去容易被搁置的"横向任务":
- 技术债清理:跨多个模块的重复代码、过时依赖、不一致的实现方式。
- 代码规范统一:将分散在各处的编码风格、命名约定、错误处理模式对齐到统一标准。
- 大范围重构:需要在多个文件中协调修改,人工执行成本高、易出错的场景。
这些任务的共同特点是范围广、单点价值低但整体价值高,正是人类工程师容易拖延、而 AI 可以持续投入的领域。
技术债(Technical Debt)这一概念由软件工程师 Ward Cunningham 提出,用来比喻因追求短期开发速度而积累下来的代码质量问题——就像借了贷款,未来需要付出更高成本来偿还。常见形态包括:缺乏测试覆盖的核心模块、随时间漂移的不一致命名约定、重复实现同一逻辑的多份代码,以及长期未升级的依赖库。这类问题的难点不在于单个修复的复杂度,而在于它散布在整个代码库中,需要系统性扫描和协调才能有效治理。这恰好对应了 AI Agent 在"广度扫描 + 批量执行"上的比较优势。
值得留意的问题
官方发布信息目前较为简略,一些关键细节尚不清晰。例如,Devin 在评估阶段的准确率如何、面对大型复杂代码库时的表现、生成 PR 的质量是否稳定、以及对私有代码库的安全与隐私保障机制等,都还需要实际使用后才能验证。
对于团队来说,AI 主动扫描并提交改动虽然提升了效率,但也可能带来 PR 数量激增、审查负担加重的问题。如何在自动化改进与人工审查之间取得平衡,将是使用这类功能时需要权衡的现实课题。
小结
Code Scans 代表了 AI 编程工具从"执行具体指令"向"理解并落地工程意图"演进的一个方向。它把调查、评估、生成 PR 三个环节串联成完整闭环,同时通过 PR 机制保留了人类的最终控制权。对于希望系统性提升代码库质量的团队而言,这是一个值得关注的新工具,但其实际效果仍有待更多真实场景的检验。
相关推荐
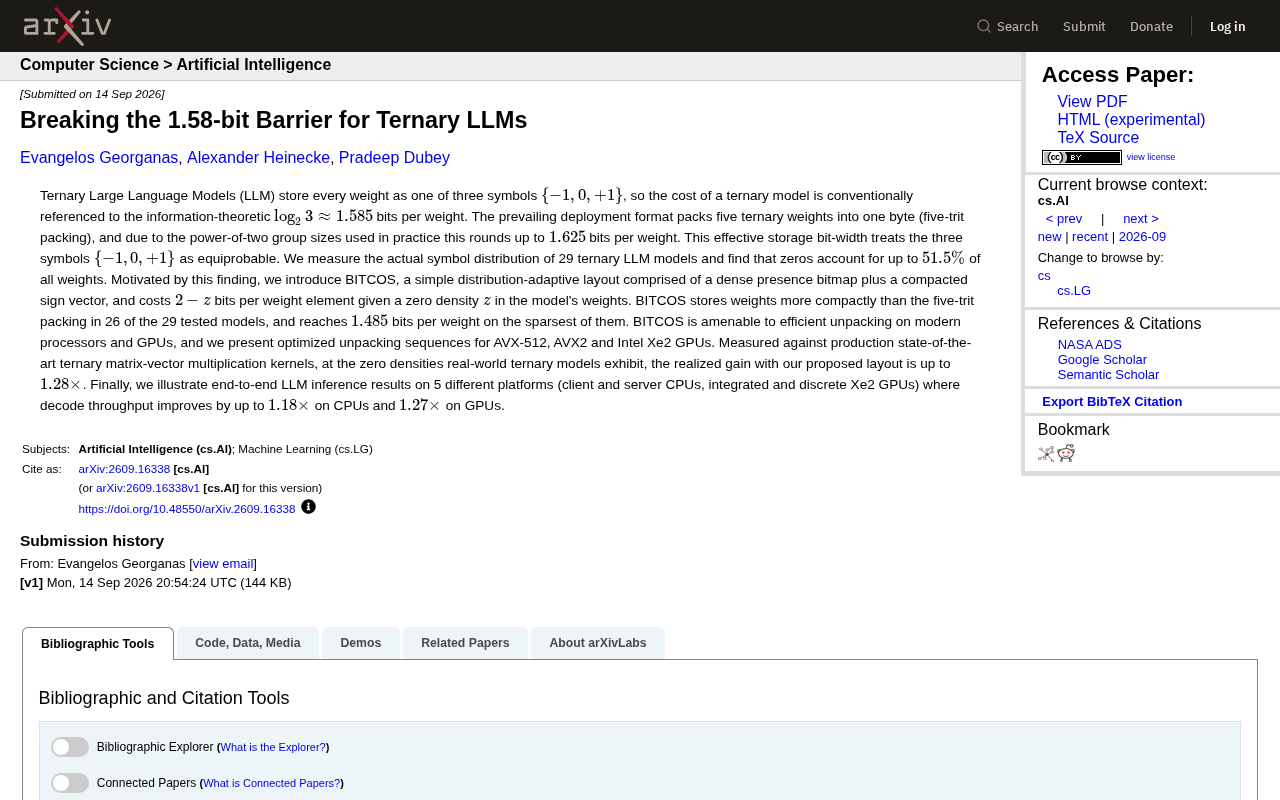
突破1.58比特极限:三元LLM如何逼近信息论边界
三元大模型(ternary LLM)的1.58-bit并非真正下限。本文解析为何利用权重稀疏分布与熵编码可以突破这一信息论壁垒,以及其对低比特量化与端侧部署的工程意义。
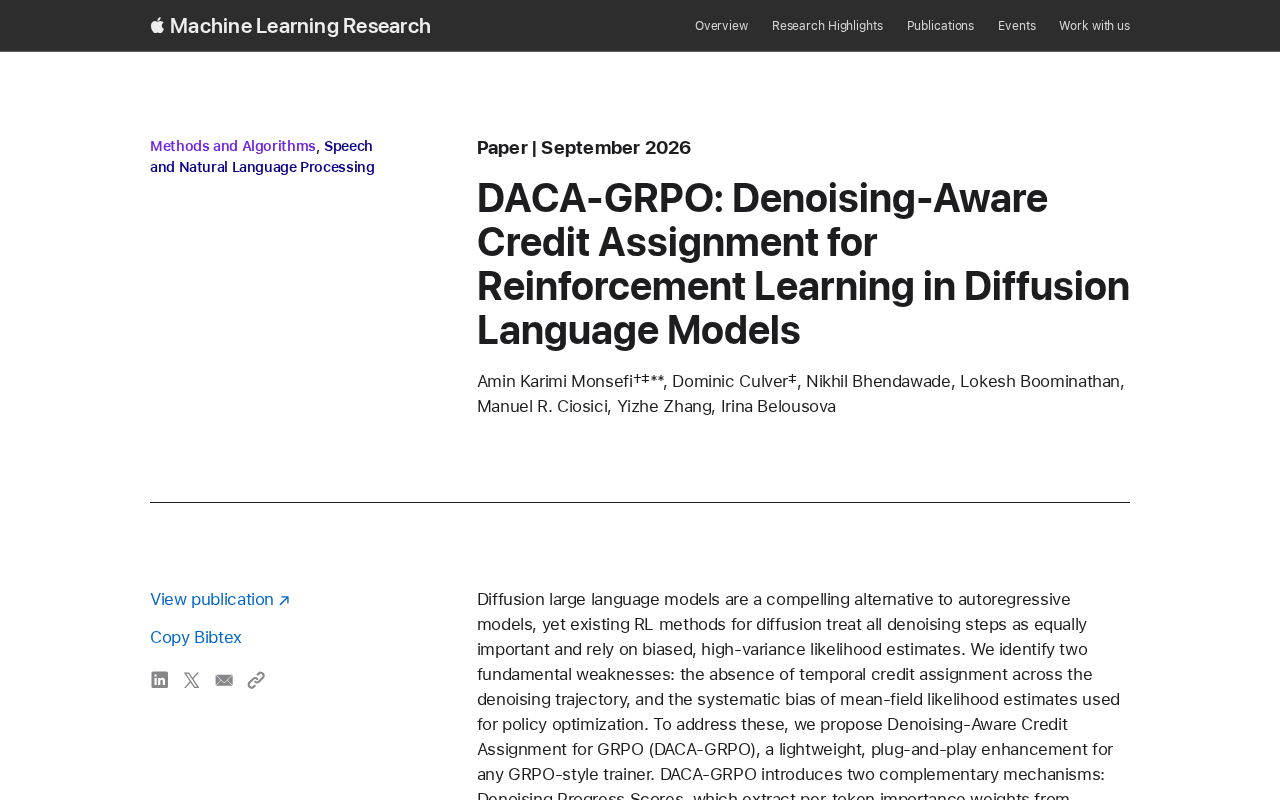
DACA-GRPO:为扩散语言模型强化学习引入去噪感知信用分配
DACA-GRPO 是一种为扩散语言模型强化学习设计的去噪感知信用分配方法,解决时序信用分配缺失与似然估计偏差两大问题,可即插即用地增强任何GRPO训练器。
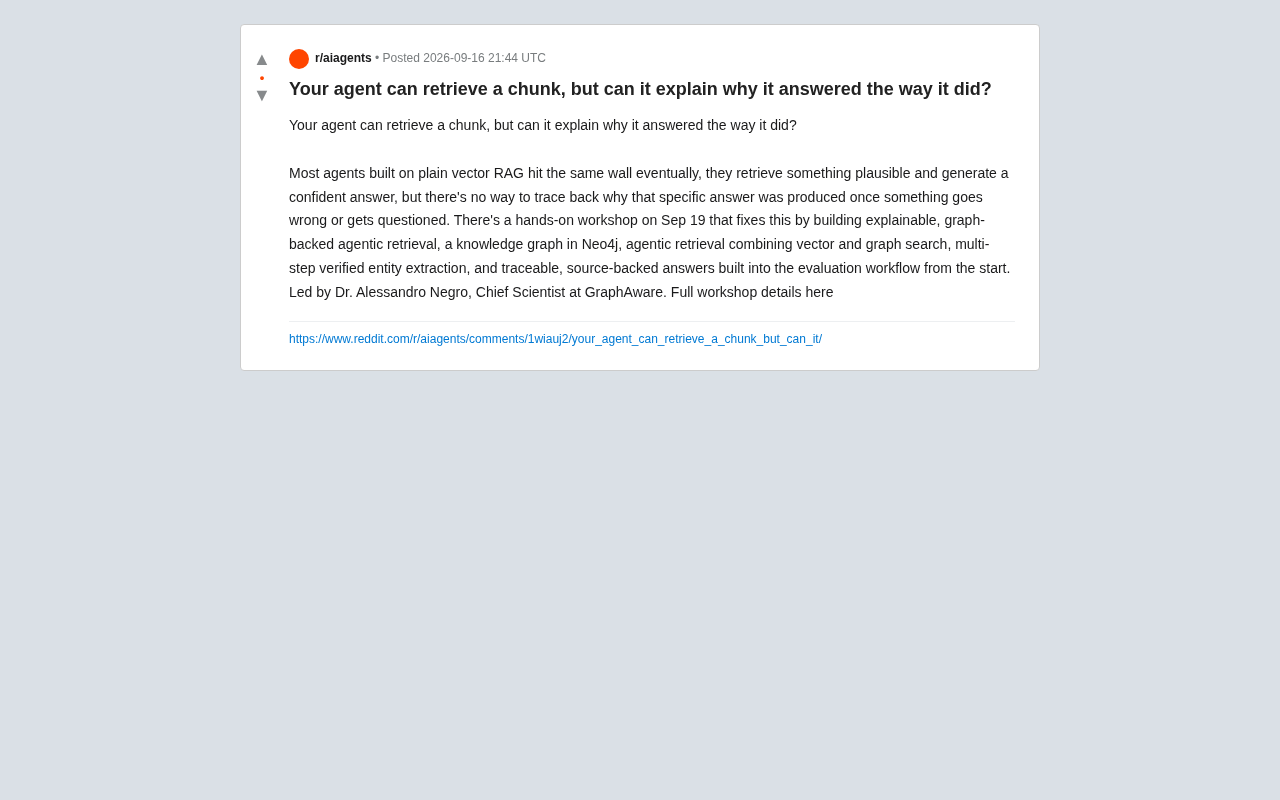
可解释的智能体检索:让RAG不只是"猜对答案"
纯向量RAG的智能体虽能检索内容却无法解释推理来源。本文探讨基于Neo4j知识图谱、向量与图混合检索、多步验证实体抽取的可解释智能体检索方案,实现可追溯、有来源支撑的AI Agent答案。