Devin记忆系统与OpenAI 300亿融资:AI行业一周关键动向

一周AI大事:OpenAI洽谈300亿融资、隐形水印应对欧盟监管、Devin推出跨会话"做梦"记忆系统。
本文梳理了AI行业一周内的多条重要进展。融资层面,OpenAI据传正洽谈高达300亿美元新一轮融资,阿联酋主权基金或为重要锚定方,折射出国家级资本争夺AI基础设施的趋势。监管层面,OpenAI推出TextGrain隐形文字水印技术,以满足欧盟AI法案对生成内容的透明度要求,但编辑和翻译会削弱水印效果,揭示出技术合规手段的内在局限。产品层面,编程助手Devin推出"做梦"记忆系统,通过跨会话重组项目知识,向可成长的长期协作伙伴演进。模型层面,Reflection发布稀疏MoE架构的Beam模型,以较低激活参数实现大容量知识储备。文章最终将这些进展归纳为一条主线:AI公司正在同步构建技术能力与商业变现体系,护城河已从模型本身延伸至分发、计费和生态系统。
AI行业的一周总能塞满大新闻。从OpenAI传闻中的300亿美元融资,到Devin那个被形容为"做梦"的记忆系统,再到为满足欧盟监管而设计的隐形文字水印——这些进展既反映了技术本身的推进,也揭示了AI公司如何围绕模型构建商业版图。本文基于TLDR AI的一期内容整理,梳理其中最值得关注的几条线索。
OpenAI的300亿美元融资与资本格局
最抓眼球的消息是OpenAI据称正在洽谈一轮规模高达300亿美元的融资。按照报道,阿拉伯联合酋长国的投资基金可能成为这笔交易的重要锚定方,几家基金据传讨论联合投入最高100亿美元。其他潜在参与方包括贝莱德(BlackRock)、Thrive Capital、Andreessen Horowitz,以及加州大学捐赠基金。
需要强调的关键词是"洽谈"。这是一轮仍在进行中的融资,参与方和金额都可能变化。但即便如此,主权财富基金与顶级风投同台入局的格局,本身就说明了资本市场对前沿大模型公司的押注逻辑:这已经不只是风险投资,而是国家级资本参与的基础设施争夺。
隐形文字水印:监管驱动的透明度工具
OpenAI计划为符合条件的ChatGPT和Codex输出添加文字水印,以满足欧盟AI法案的透明度要求。这套方法名为TextGrain,通过微调词语选择来形成检测工具可识别的模式。
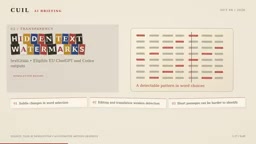
换句话说,你看到的仍是普通句子,水印藏在用词的选择之中。但这种方案有明显的局限:编辑、翻译或使用极短的片段都可能削弱信号。因此它不应被当作识别所有AI生成内容的完美手段。这也反映出一个现实——监管要求可以倒逼技术落地,但技术本身的可靠性边界依然存在,透明度工具更多是"尽力而为"而非铁证。
欧盟AI法案(EU AI Act)于2024年正式生效,是全球首部系统性规范人工智能的综合立法。该法案按风险等级对AI系统分类,其中对"通用目的AI"(GPAI)模型——即GPT、Claude等大型基础模型——要求提供透明度信息,包括训练数据摘要和技术文档。对于面向消费者的生成式AI系统,法案还明确要求告知用户内容由AI生成。TextGrain这类水印技术正是响应这一条款的工程实践路径:通过在模型输出层注入可机读的隐性标记,在不改变用户体验的前提下满足合规要求。值得注意的是,欧盟AI法案设有分阶段生效时间表,不同条款的执行截止日期从2025年延续至2027年,这意味着AI公司现在部署水印,部分也是为未来更严格的审计窗口提前布局。
Devin的"做梦"记忆系统
真正引发讨论的,是Devin新推出的记忆系统。它被设计用来跨会话保留用户偏好、纠正记录和项目知识。如果你解释了项目的运作方式,或纠正了一个反复出现的错误,这些信息可以用于指导后续工作。
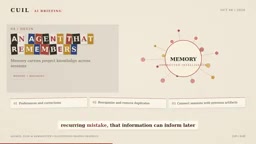
所谓"做梦"过程,是指系统会周期性地重组这些记忆、删除重复项,并将它们与过往会话和产出关联起来。尽管名字听上去很科幻,这本质上是一套信息管理机制,目标是让积累的经验对用户更有用。对于长期协作的编程助手而言,持久记忆是从"一次性工具"走向"可成长伙伴"的关键一步。
当一家公司拥有大量编程Agent
由记忆系统延伸出一个更大的问题:当一家公司同时运行许多编程Agent时会发生什么?新闻中引用了一篇以Uber为主要案例的分析,探讨所谓"AI原生软件工厂"。
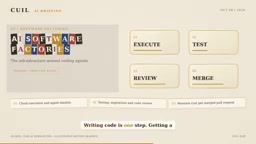
这篇分析的焦点超越了单纯的代码生成,涵盖云端执行、模型访问、Agent身份、测试、迁移和代码审查。它还提出一个非常务实的财务问题:让一个pull request被合并需要多少成本?写代码只是第一步,把一个可靠的变更推进到生产环境,需要一整套工作流支撑。这提醒我们,衡量AI编程价值的指标正在从"能不能写出代码"转向"能不能可靠地交付"。
Agent身份(Agent Identity)是"AI原生软件工厂"语境下一个容易被忽视的基础设施问题。当企业中运行着数十乃至数百个编程Agent时,每个Agent需要被授予访问代码仓库、CI/CD流水线、云资源和外部API的权限。传统IAM(身份与访问管理)体系是围绕人类用户设计的,而Agent的操作模式——高频、批量、跨系统——使得权限边界更难管控,审计日志的可解释性也更弱。Uber案例之所以值得关注,部分原因正在于:一个企业级AI工程实践的成熟度,不仅体现在Agent能生成多少代码,还体现在能否将Agent的行为纳入现有的安全合规、变更管理和责任归属体系。这也是从"AI辅助编程"升级为"AI原生研发流程"时,工程组织必须解决的治理层问题。
模型与工具层面的新进展
模型侧,Reflection推出了Beam。按新闻中的概述,Beam是一个稀疏专家混合(MoE)模型,总参数量5010亿,但对单次输入约激活230亿参数。这种架构在处理时只调用模型的选定部分,目标场景是编码、推理和Agent任务。开放权重和开发者材料计划在当月晚些时候发布,因此发布本身仍值得观察。
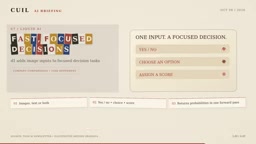
Liquid AI则在为其D1决策模型扩展视觉能力。它可以接收图像、文本或两者,然后针对诸如是非判断、多选或打分之类的问题返回概率。它不写长篇回复,而是做出聚焦的决策,公司在对比中报告了显著的速度和成本优势——当然,这些数据需要放在具体测试任务与基准的语境下理解。
面向创作者的工具是Frame Fields。它让编程Agent编写TypeScript构图,用于视觉特效、动态排版、运动图形和三维场景,然后检查帧并渲染成MP4。
这为开发者提供了另一种"用代码构建视频"的路径,把编程能力延伸到了内容生产领域。
稀疏专家混合(Sparse Mixture of Experts,简称MoE)是一种神经网络架构设计思路。与传统"稠密"模型在每次推理时激活全部参数不同,MoE模型将参数分组为多个"专家"子网络,对每个输入仅路由激活其中少数几组。这样做的核心优势是:模型的总参数量(决定其知识容量上限)可以做得很大,而单次推理实际计算量(决定速度与成本)则保持相对较小。Google的Gemini 1.5和Mixtral都采用了类似架构。Beam的5010亿总参数对应约230亿激活参数,激活比例约4.6%,意味着它试图以接近230亿稠密模型的推理成本,获得更大模型的知识储备。这一架构在编码和Agent任务中尤具吸引力,因为这类任务既要求知识广度(理解多种语言与框架),又对推理延迟敏感。
AI商业化的两条主线
最后两则消息指向更广阔的行业走向。一是对OpenAI商业市场的分析,描绘了一种可能的未来:企业通过一个共享平台购买AI应用,预算和计费都更简单。二是OpenAI正在扩展ChatGPT中的广告业务,推出新的视觉格式和额外的测量工具。
这两件事放在一起,清晰地展示出AI公司正在同步构建技术与商业——模型是产品,但真正的护城河在于围绕模型搭建的分发、计费和变现体系。从融资到水印,从记忆系统到广告格式,这一周的新闻拼出的,是一个正在快速从实验室走向商业基础设施的AI产业图景。
相关推荐

OpenAI全量推送GPT-6与Intelligent UI:ChatGPT告别纯文本
OpenAI向全部ChatGPT用户推送GPT-6模型,并上线Intelligent UI智能界面,可动态生成按钮、滑块与交互图表。本文解析双旗舰下放策略、交互革命及三大使用边界。
智能体底座(Harness)比模型本身更关键:YC深度解析Agent架构演进
YC在Harness Night分享会上提出:决定智能体能力的关键不是模型本身,而是外层的Harness底座。本文梳理从GPT-2到自改进Harness的演进,解析Prime Agent、OpenJarvis、QM三大实践及Agent架构设计要点。
用n8n搭建LinkedIn线索抓取与丰富化自动工作流
一套基于n8n的LinkedIn线索抓取与丰富化自动工作流:只需填写职位、地点、行业和公司规模,系统即可自动生成含专业邮箱和验证状态的客户名单并写入Google表格。本文解析其流程、输出字段与合规注意事项。