Devin如何重构渲染器:让超大会话秒开流畅
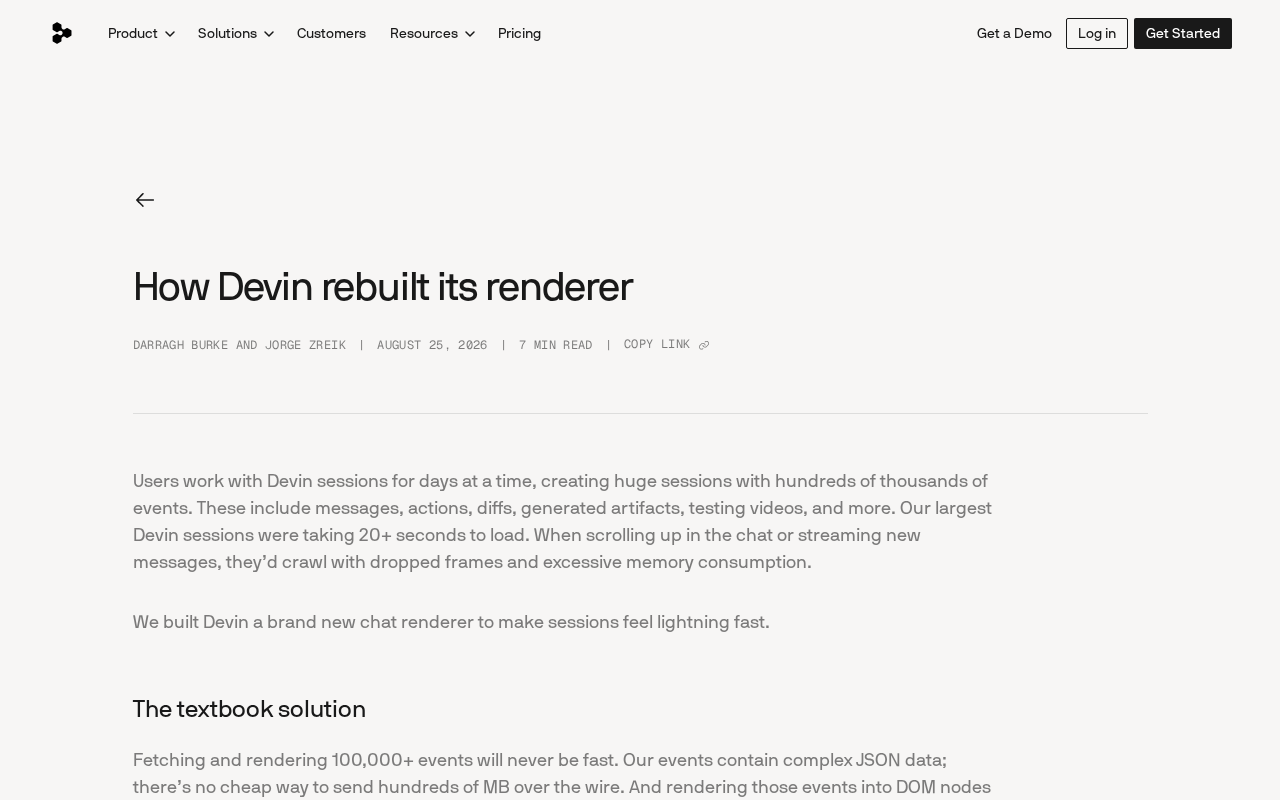
Devin用骨架屏、岛屿式加载和滚动锚定三项技术重构渲染器,将数十万事件会话的加载时间从20秒压缩至流畅可用。
AI编程助手Devin因会话事件数量庞大,曾面临加载超20秒、滚动严重卡顿的体验困境,根本原因在于传统全量渲染导致DOM节点爆炸和主线程长期阻塞。为此,团队重构聊天渲染器,组合运用三项技术:骨架轮廓提供即时结构反馈、改善感知性能;岛屿式加载让浏览器只渲染视口内容、大幅降低运行时开销;滚动锚定则确保动态注入内容时阅读位置保持稳定。这套方案并非依赖新技术,而是将Web工程领域已有的成熟手段精准适配到"数十万事件级"AI会话场景,为业界处理长上下文前端渲染挑战提供了务实的参考路径。
大型会话的性能困局
AI编程助手Devin在处理长时间、复杂任务时会积累大量交互事件。据官方披露,最庞大的Devin会话加载耗时超过20秒,而且加载完成后滚动依然卡顿明显。对于需要频繁回溯上下文的开发者来说,这样的体验是难以接受的。
问题的根源在于渲染架构。当一个会话包含数十万个事件时,传统的一次性全量渲染会让浏览器不堪重负——DOM节点爆炸式增长,主线程被长时间占用,页面既无法快速呈现,也难以响应用户的滚动操作。这类问题在长上下文的AI应用中相当普遍,随着任务复杂度上升,渲染层往往成为最先暴露的瓶颈。
三大技术手段的组合拳
Devin团队重写了聊天渲染器,采用了三项关键技术来解决加载与滚动的性能问题。
骨架轮廓(Skeleton Outlines)
骨架轮廓的核心思路是先渲染出内容的结构框架,再逐步填充真实内容。用户在打开会话的第一时间就能看到页面的整体布局,而不是面对一片空白等待。这不仅改善了感知性能,也为后续的分块加载提供了稳定的空间占位,避免内容涌入时页面剧烈跳动。
岛屿式加载(Island Loading)
岛屿式加载是一种按需渲染的策略。页面被切分为若干独立的"岛屿",只有进入或接近视口的部分才会被真正渲染和激活,视口外的内容保持轻量状态。对于包含数十万事件的会话而言,这意味着浏览器任何时刻只需处理可见范围内的少量内容,大幅降低了初始加载和运行时的开销。
岛屿架构(Islands Architecture)这一概念最早由 Etsy 工程师 Katie Sylor-Miller 提出,后经 Astro、Fresh 等前端框架广泛推广。其核心思想是将页面分解为静态部分与独立的可交互"岛屿",各岛屿独立水合(hydrate)并可延迟激活,从而避免对整个页面做一次性全量处理。在 Devin 的场景中,这一思路被应用于纯渲染侧的按需加载:会话事件列表中位于视口外的区域不会被实际渲染为完整 DOM,而是保留为低成本的占位结构,只有当用户滚动使其进入视口时才触发真正的渲染。这与虚拟列表(Virtual List / Windowing)技术有相似之处——React Virtual、TanStack Virtual 等库也采用类似逻辑——但岛屿式的粒度通常更粗,以会话片段或消息块为单位,而非逐行虚拟化,更适合内容结构复杂、高度不固定的 AI 对话场景。
滚动锚定(Scroll Anchoring)
当页面内容动态加载或高度发生变化时,用户的滚动位置很容易发生意外跳动,这是分块渲染方案常见的副作用。滚动锚定通过将视图锁定在用户当前关注的内容上,确保即便下方或上方有新内容注入,阅读位置也保持稳定,从而实现平滑连贯的滚动体验。
滚动锚定实际上有两个层面的含义。其一是浏览器原生的 CSS overflow-anchor 规范:Chrome 56 起浏览器会自动将视口内最近的 DOM 节点作为锚点,当锚点上方内容高度变化时自动补偿滚动偏移,防止阅读位置跳变。其二是应用层自行实现的锚定逻辑,通过在内容插入前后记录目标元素的 getBoundingClientRect 偏移并手动调用 scrollBy 进行修正,适用于需要精细控制或浏览器原生行为无法覆盖的场景(如双端同时注入内容)。Devin 处理的会话可能同时在顶部懒加载历史事件、在底部追加新事件,原生锚定难以兼顾两端变化,因此应用层的主动锚定管理是不可或缺的补充。这也是分块渲染方案中最容易被忽视、却最直接影响用户体感的工程细节。
为什么这些优化值得关注
这次重构的价值不止于单个产品的体验提升。它反映了AI应用在走向成熟过程中必须直面的工程现实:模型能力再强,如果承载交互的前端无法高效呈现海量输出,实际可用性就会大打折扣。
骨架屏、虚拟化/按需渲染、滚动锚定这三类技术本身在Web工程领域并不新鲜,但将它们系统性地应用到"数十万事件级"的AI会话场景,考验的是对具体数据规模和交互模式的深入理解。Devin团队用这套组合方案把20秒以上的加载时间和卡顿滚动,转变为快速加载与流畅滚动,说明性能优化的关键往往不在于发明新技术,而在于针对真实瓶颈做出精准的架构选择。
对开发者的启示
对于正在构建AI应用的团队,Devin的这次实践提供了几点可借鉴的经验:其一,长上下文场景下的渲染性能应当被视为一等问题,越早规划越能避免后期的架构重写;其二,感知性能(如骨架屏带来的即时反馈)和实际性能(如按需渲染降低的计算量)需要同时兼顾;其三,动态加载方案必须配套滚动位置管理,否则流畅度会被细节问题拖累。
随着AI助手承担越来越复杂的任务,会话数据的规模只会持续增长。Devin重建渲染器的案例,为整个行业如何在前端层面消化这种增长提供了一个务实的参考样本。
相关推荐
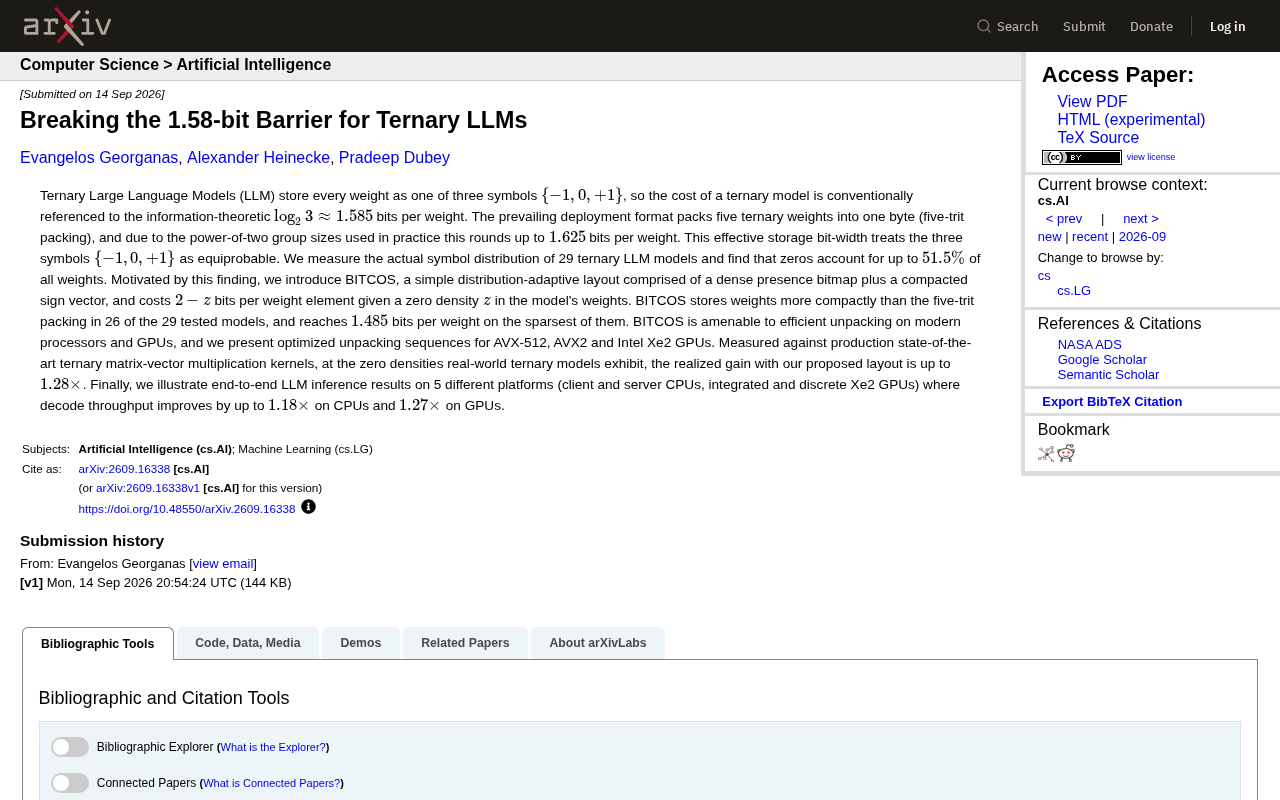
突破1.58比特极限:三元LLM如何逼近信息论边界
三元大模型(ternary LLM)的1.58-bit并非真正下限。本文解析为何利用权重稀疏分布与熵编码可以突破这一信息论壁垒,以及其对低比特量化与端侧部署的工程意义。
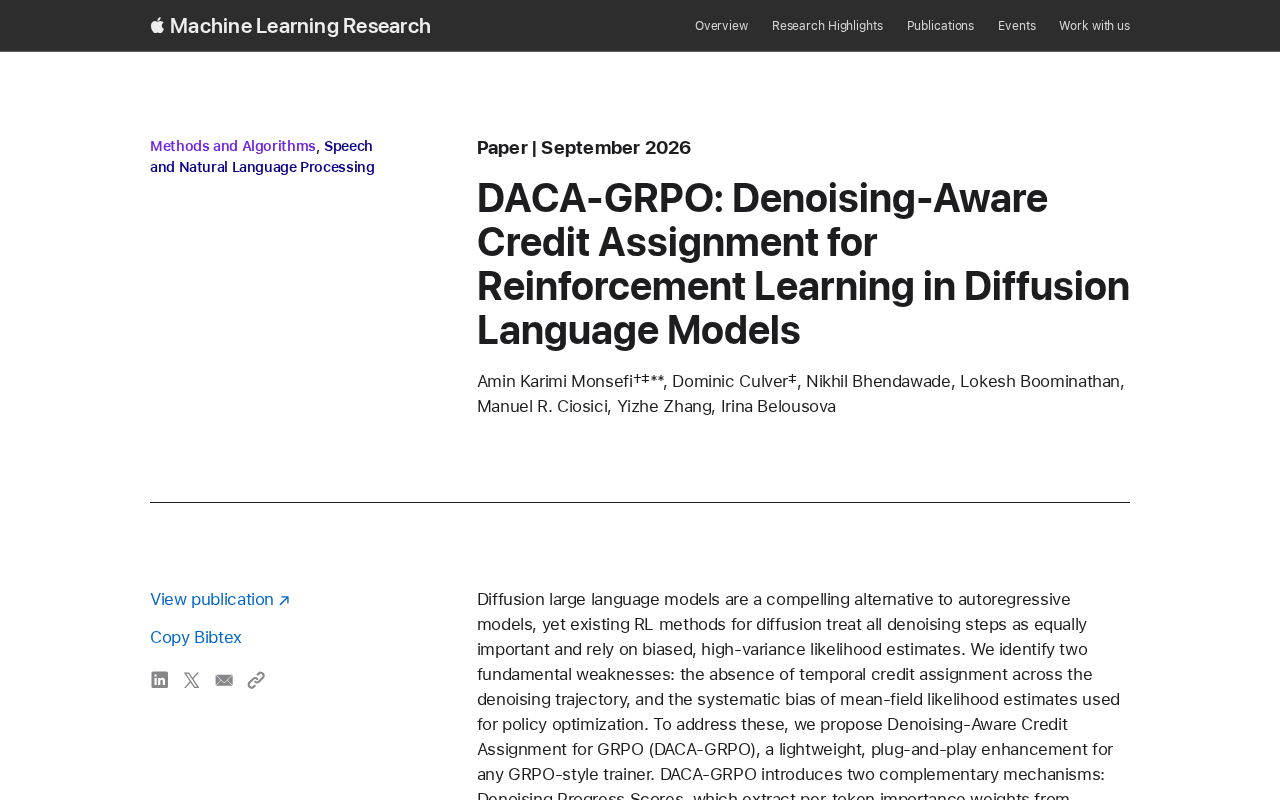
DACA-GRPO:为扩散语言模型强化学习引入去噪感知信用分配
DACA-GRPO 是一种为扩散语言模型强化学习设计的去噪感知信用分配方法,解决时序信用分配缺失与似然估计偏差两大问题,可即插即用地增强任何GRPO训练器。
可解释的智能体检索:让RAG不只是"猜对答案"
纯向量RAG的智能体虽能检索内容却无法解释推理来源。本文探讨基于Neo4j知识图谱、向量与图混合检索、多步验证实体抽取的可解释智能体检索方案,实现可追溯、有来源支撑的AI Agent答案。