低成本弃权策略:LLM工单分类如何降低误路由成本

成本感知弃权框架显示TF-IDF+逻辑回归在工单路由上成本降低38.1%,优于多个LLM配置。
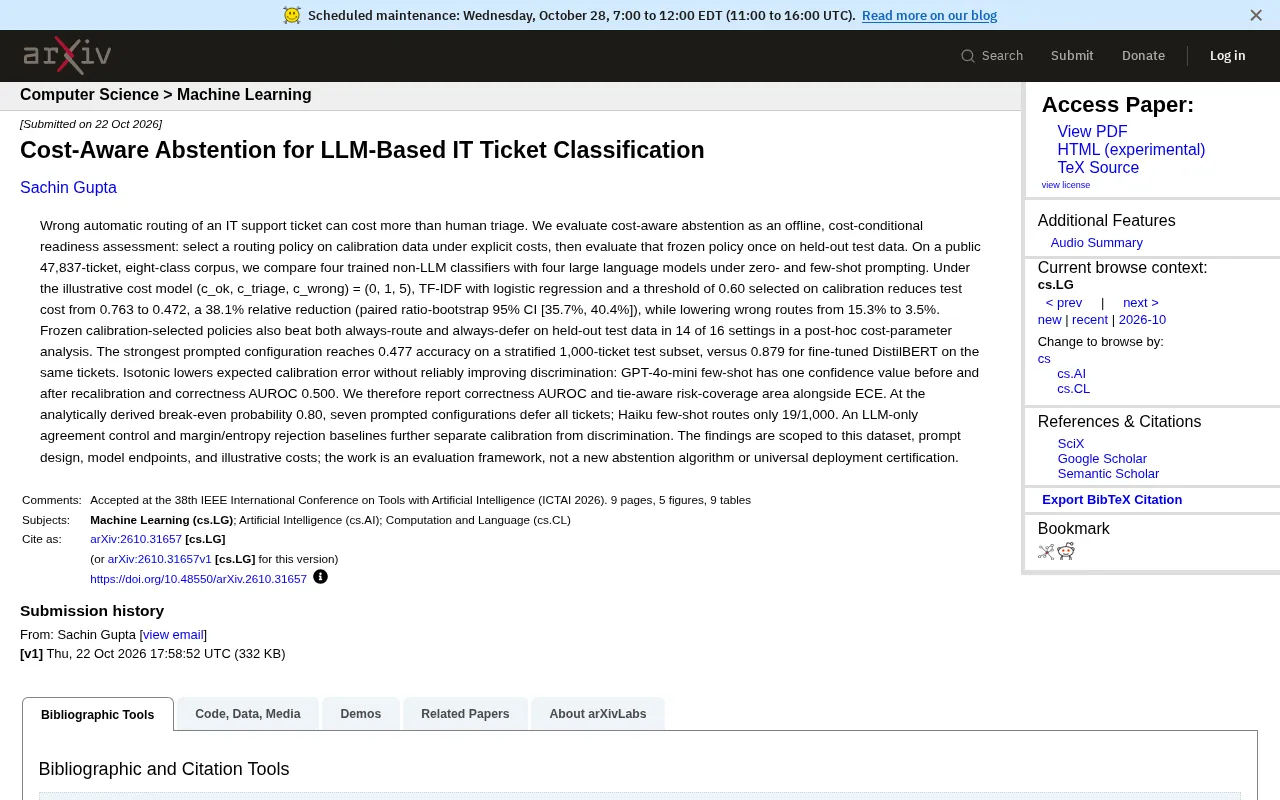
一项新研究提出成本感知弃权框架,用于离线评估IT工单分类模型在显式成本下的表现。研究在47,837条工单、八个类别的数据集上对比四种传统分类器和四种大语言模型,设定示意性成本模型(0,1,5)。核心方法是在校准集上选择弃权阈值并冻结,在测试集上一次性评估。结果显示,TF-IDF+逻辑回归在阈值0.60时将测试成本从0.763降至0.472,相对降低38.1%,错误路由率从15.3%降至3.5%,显著优于所有LLM配置。微调DistilBERT准确率达0.879,远超最强LLM提示的0.477。研究强调需同时报告正确性AUROC和风险-覆盖面积以评估不确定性质量,并指出该框架为离线评估工具,实际部署需根据组织成本结构重新校准阈值。
自动将IT支持工单路由到错误的团队,代价可能比人工分诊更高。一项新研究提出“成本感知弃权”(Cost-Aware Abstention)框架,通过在校准数据上选择路由策略并在测试集上一次性评估,来量化不同模型在显式成本下的表现。研究在47,837条工单、八个类别的公开数据集上对比了四种传统分类器和四种大语言模型,发现TF-IDF配合逻辑回归在阈值0.60时,能将测试成本从0.763降至0.472,相对降低38.1%,同时将错误路由率从15.3%降至3.5%。
为什么需要成本感知的弃权机制
在IT运维中,工单误路由意味着问题被转给错误的专家,不仅延误解决时间,还可能引发重复沟通和用户不满。研究设定了一个示意性成本模型:(c_ok, c_triage, c_wrong) = (0, 1, 5),即正确路由成本为0,人工分诊成本为1,错误路由成本为5。这一设定反映了现实中误路由的代价远高于人工介入。
传统分类器通常追求整体准确率,但高准确率并不等同于低成本。例如,一个模型可能将大量工单正确分类,但少数高风险错误却带来不成比例的成本。成本感知弃权允许模型在不确定时“弃权”,将工单转交人工分诊,从而避免代价高昂的错误。
研究的核心思路是:在校准数据上根据显式成本选择路由策略(包括弃权阈值),然后将该策略冻结,在留出测试集上评估一次。这模拟了真实部署前的离线评估场景,避免了在测试集上调参带来的乐观偏差。
弃权(Abstention) 在机器学习中又称“拒绝预测”或“选择性预测”,指模型在置信度不足时主动放弃给出分类结果,将样本转交人工处理。这一机制源于风险最小化理论:当模型预测的期望风险超过人工处理的成本时,弃权是更优选择。弃权阈值通常基于校准后的置信度或概率设定,可视为在覆盖率和准确率之间的权衡旋钮。在工单路由场景中,弃权意味着将工单转给人工分诊台,而非强制分配给某个专家队列。
实验设置:传统模型 vs 大语言模型
研究使用了四个训练好的非LLM分类器(包括TF-IDF+逻辑回归、线性SVM等)和四个大语言模型(包括GPT-4o-mini、Claude Haiku等),在零样本和少样本提示下进行比较。数据集包含47,837条工单,分为八个类别。
评估指标除了常规的准确率,还引入了成本、错误路由率、正确性AUROC和风险-覆盖面积等。特别地,研究指出等渗校准(Isotonic)能降低期望校准误差(ECE),但并不总能改善区分度。例如,GPT-4o-mini少样本配置在校准前后只有一个置信度值,正确性AUROC仅为0.500,说明该模型在区分正确与错误预测方面几乎无能力。
因此,研究建议同时报告正确性AUROC和考虑并列的风险-覆盖面积,以更全面地评估模型的不确定性质量。
正确性AUROC 衡量模型区分“预测正确”与“预测错误”的能力,取值0.5表示无区分力,1.0表示完美区分。它不依赖具体阈值,是评估不确定性质量的阈值无关指标。风险-覆盖面积(Risk-Coverage AUC) 则刻画模型在弃权不同比例样本时的错误率曲线下面积,覆盖率为被路由样本占比,风险为错误率。当多个样本具有相同置信度(并列)时,该指标需特殊处理。两者结合可避免仅看校准误差(ECE)的盲区:一个模型可能校准良好(预测概率与实际正确率匹配),但所有样本置信度相同,导致无法通过阈值有效弃权。
关键发现:传统方法反超LLM
在示意性成本模型下,TF-IDF+逻辑回归配合校准集上选择的阈值0.60,将测试成本从0.763降至0.472,相对降低38.1%(配对比率自助法95% CI [35.7%, 40.4%]),错误路由率从15.3%降至3.5%。这一结果显著优于所有测试的LLM配置。
在分层抽样的1,000条测试子集上,最强的提示配置准确率为0.477,而微调后的DistilBERT达到0.879。这表明在工单分类任务上,经过充分训练的小模型可能比大语言模型更具成本效益和准确性。
研究还进行了事后成本参数分析,发现冻结的校准选择策略在16种设置中的14种优于“总是路由”和“总是弃权”的基线。这说明成本感知弃权框架在不同成本参数下具有鲁棒性。
配对比率自助法(paired bootstrap) 是一种非参数统计方法,用于估计两个相关指标之比的置信区间。在本研究中,它通过对同一批测试样本进行有放回重采样,计算每次重采样中“弃权策略成本”与“总是路由成本”的比值,重复数千次后取2.5%和97.5%分位数作为95%置信区间。这种方法不假设成本差异服从正态分布,且保留样本间的配对关系,适合评估相对降低幅度这类比率型指标的不确定性。
弃权阈值的实际影响
在分析推导的盈亏平衡概率0.80处,七个提示配置选择弃权所有工单,而Haiku少样本仅路由19/1,000条。这意味着当模型置信度低于0.80时,弃权比冒险路由更经济。这一阈值可根据实际成本结构调整,为部署提供灵活性。
研究还比较了基于边际/熵的拒绝基线以及仅LLM一致性控制,进一步区分了校准与区分度的作用。结果表明,单纯依赖LLM的置信度或一致性可能不足以实现成本最优的弃权。
盈亏平衡概率 指模型预测正确的概率恰好使“路由”与“弃权”的期望成本相等的临界值。在成本模型(c_ok, c_triage, c_wrong)=(0,1,5)下,设模型置信度为p,路由的期望成本为(1-p)×5,弃权成本为1,令二者相等得p=0.8。当p>0.8时路由更经济,p<0.8时弃权更优。这一推导假设置信度已良好校准,因此校准质量直接影响盈亏平衡阈值的可靠性。实际部署中,成本参数变化会移动该阈值,组织需根据自身误路由代价与人工成本重新计算。
局限与部署启示
作者明确指出,研究范围限于特定数据集、提示设计、模型端点和示意性成本。该工作是一个评估框架,而非新的弃权算法或通用部署认证。实际部署时,组织需要根据自己的成本结构重新校准阈值,并考虑工单分布的变化。
对于IT运维团队,这项研究传递了一个务实信号:在工单分类这类结构化任务上,传统机器学习模型配合成本感知弃权,可能比直接调用大语言模型更经济可靠。LLM并非万能,尤其是在需要精确成本控制的场景中,轻量级模型加校准策略仍是值得优先考虑的方案。
总结
成本感知弃权为LLM工单分类提供了一种离线评估 readiness 的方法。通过显式成本模型和校准集选择策略,团队可以在部署前量化误路由风险与人工分诊成本的权衡。实验表明,TF-IDF+逻辑回归在成本指标上显著优于多个LLM配置,错误路由率大幅降低。这一框架强调校准与区分度的分离评估,为实际部署提供了可操作的指导。
相关推荐

前端转AI Agent开发:一线架构师解析职业路径与红利
一线AI架构师解析前端转AI Agent开发的行业变化与落地路径:纯前端岗位为何消失、Agent+全栈为何成为招聘主流,以及Agent开发工程师、FDE、远程接单三条转型路线和对应学习策略。

AI Agent开发课程怎么选?五条避坑指南
机械转行开发者踩坑两年总结的AI Agent开发课程筛选清单:完整交付链路、可写进简历的项目、真实开发视角、更新频率、陪跑反馈五个维度,附具体判断方法和避坑要点。

扣子(Coze)智能体搭建入门:零代码开发AI Agent实战指南
扣子(Coze)是字节跳动推出的一站式AI应用开发平台,支持零代码拖拽搭建AI智能体。本文基于B站教程梳理扣子的核心概念、三大优势、国内版与国际版差异,以及智能体与应用的区别,帮助初学者快速入门AI Agent开发。