第三方报告证实:AI递归自我改进已开始,且无减速迹象
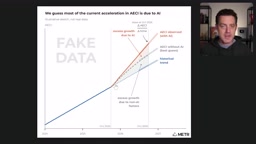
第三方评估认定Anthropic很可能已在自我改进,且未见短期瓶颈。
独立评估公司Meter获准深度访问Anthropic内部后发布报告,基于内部数据、员工访谈和产线观察得出结论:Anthropic模型能力提升速度约为历史速率的两倍,且主因是AI自身进步而非算力或人力扩张。模型改进与算力效率提升形成复合循环,Meter称未发现未来12个月内能显著阻挡加速的明确瓶颈。但报告透明度存在边界:Anthropic保留审批和删节权限,并中途取消算力分配验证。内部未发布模型被用于加速下一代研发,基准测试被迫持续加难,自主实验出现“生命迹象”。报告将开发者体感转化为可引用证据,但递归自我改进仍是强信号而非终局判决。
一份来自内部的独立评估,证实了最令人不安的猜想
几个月前,Anthropic、OpenAI等顶级AI实验室的负责人集体呼吁“放慢前沿节奏”,理由是他们担心递归自我改进(Recursive Self-Improvement,RSI)和最终可能出现的超级智能。当时他们承诺,将允许第三方评估机构以“接近员工级别”的权限访问内部系统、模型、员工乃至聊天记录。
如今,第一批独立评估结果出炉。独立评估公司Meter与Anthropic深度合作,获得了近乎完全的内部访问权限,并发布了《Anthropic与OpenAI AI研发加速的独立评估》报告。据Meter多名参与该项目的研究人员判断:截至报告发布时,Anthropic很可能已经在自我改进。
这不是科幻推演,而是基于内部数据、员工访谈和产线观察得出的结论。Meter仅派出2.5名全职等效员工,在几个月内便完成了这项评估,回答了三个核心问题:Anthropic内部能力增长速度是否加快?加速中有多少归因于AI?是否存在短期内能减缓加速的关键瓶颈?三个问题的答案都指向同一个方向:加速确实存在,主导因素是AI本身,且尚未发现明显阻碍。
递归自我改进(Recursive Self-Improvement, RSI) 是AI安全领域的核心概念,指一个AI系统具备改进自身代码、架构或训练流程的能力,且改进后的版本在改进能力上进一步增强,形成正反馈循环。理论上,这种循环可能导致智能水平在短时间内急剧跃升,超出人类的理解与掌控范围。哲学家Nick Bostrom在《超级智能》中将其描述为“智能爆炸”的关键机制:一旦AI跨过某个能力阈值,它就能以越来越快的速度设计出更强大的后继版本。当前争论的焦点在于,现有大模型是否已接近这一阈值——它们能否自主提出高价值的研究假设、设计实验并验证结果,而非仅仅执行人类指定的任务。Meter报告所称的“很可能已经在自我改进”,正是指AI在研发流程中扮演了越来越实质性的加速角色,尽管尚未达到完全自主的递归循环。
加速的证据:模型曲线出现明显拐点
Meter如何证明“加速”不是错觉?他们构建了一个反事实图表:以Anthropic内部衡量模型能力的指标AECI为纵轴,若按历史趋势线性外推,应是一条相对平缓的上升线。但实际数据在某个时间点后明显上翘,形成一个陡峭的拐点。
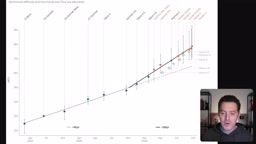
据Meter评估,Anthropic模型在定义明确的任务(尤其是AI研发流程相关任务,比如编写支撑系统的代码)上的能力提升速度,已达到此前某个历史区间的约两倍。Meter甚至表示,当前增速可能更接近历史速率的1.3倍到3倍。更关键的是,他们排除了其他解释:不是由于招聘了更多研究员,不是由于算力规模爆炸,也不是由于人类研究员的偶然突破。Meter通过多条证据链——包括员工访谈、自我报告的效率提升、代码行数、实验使用量以及领导层的定性反馈——将加速的主因锁定为AI进步本身。
员工访谈中的原话很能说明问题:“完全可以认可超过2倍的提速”“最大的效应来自模型加速,AI加速比其他所有效应加起来都大”“现在瓶颈只在想法和算力,不再受限于代码”。这些来自内部研究者的直观感受,与数据曲线相互印证。
复合循环:效率提升正在自我喂养
真正让Meter报告显得“令人紧张”的,是加速的复合性质。模型变强,就能更快发现让自身变得更强的方法;同时,模型也在学习更高效地利用有限算力。Anthropic在IPO前提交的S-1文件中披露,其算力利用效率在几个季度内从0.67倍提升到2倍,这背后是模型自身在优化推理效率。
这种复合循环在外部也有旁证。Google此前发表的Alpha Evolve论文中,AI被用于改进Google自身的硬件架构,带来了约1%的效率提升。单个百分点看似微小,但在Google的规模下,意味着数十亿美元级别的成本节约。AI帮助设计更高效的AI基础设施,基础设施再反哺更强的AI——这正是“智能爆炸”叙事的现实版本。
Meter在报告中直言:他们没有发现任何明确的瓶颈——无论是算法进步、训练算力、实验算力还是数据——会在未来12个月内显著阻挡这种复合加速。报告原文写道:“我们未发现明显的瓶颈、有限的输入会阻止进一步增长,也未发现进一步的规模扩展会出现陡峭的边际收益递减,从而阻碍这种复合加速。”换句话说,从当前状态到递归自我改进之间,暂时看不到刹车片。
S-1文件是美国证券交易委员会(SEC)规定的注册声明表格,公司在首次公开募股(IPO)前必须提交,其中需披露业务模式、风险因素、财务状况及运营指标等关键信息。由于S-1文件受证券法约束,虚假陈述可能引发法律责任,因此其中披露的数据通常被视为相对可靠的一手资料。Anthropic在S-1中披露算力利用效率从0.67倍提升至2倍,意味着其模型在相同硬件上能完成的有效计算量大幅增加,这既可能来自模型推理优化,也可能来自调度算法的改进。将这一数据置于RSI讨论中,其意义在于:算力效率的提升本身可能就是AI参与优化的结果,从而构成“AI改进AI基础设施”的复合循环证据。
访问权限的边界:Anthropic能看、能改、能删
这份报告的可信度,部分来自Meter的独立性和访问深度,但同样需要看清它的局限。Meter可以请求任何它认为相关的信息,但Anthropic拥有单方面批准或拒绝请求的权力。实践中,双方经常协商,折中到“有信息量、不极度敏感、容易分享”的数据。
更说个细节,该项目并非Anthropic此前承诺的“员工级访问”计划。Meter和Anthropic都明确表示,这个项目不涉及完整的员工级权限,也不是Anthropic在10月15日更新中描述的那个独立评估项目。换句话说,外界仍在等待真正“无限制访问”的评估落地。
项目中期还发生了一次范围变更:原本Meter要验证Anthropic的算力分配——多少用于研发、多少用于推理服务、多少用于其他用途——但Anthropic中途取消了这部分,将项目范围收窄为仅评估AI研发加速。Anthropic的解释是希望保持项目聚焦于风险评估,算力验证留待以后。这一决定难免引发联想,尤其是在Anthropic IPO进程推进的背景下。
此外,报告中涉及某些具体瓶颈的分析被Anthropic涂黑。Meter表示他们收到了“令人信服的证据”表明加速并非源于训练算力规模的膨胀,但证据细节被删节。这些信息缺口提醒读者:这是一份在受限条件下完成的独立评估,而非完全透明的审计。
内部未发布模型与基准饱和:加速的更多侧写
报告附录中透露了几个意味深长的信号。其一,Anthropic正在使用尚未公开发布的内部模型来加速自身研发,这些模型在面向外部之前,先被用于改进下一代模型。Meter认为,这种模式让“持续斜率变化”比“一次性跳变”更可信——换句话说,Mythos Preview带来的巨大提升并非某个特殊模型的偶然,而是复合加速的必然表现。
其二,Anthropic不得不持续提高内部基准的难度,因为新模型正在快速饱和现有测试。研究员们首次表示,这些模型在自主实验方面开始变得真正有用。虽然Meter谨慎地指出,AI尚未能在模型训练最关键环节做出“高度重要且完全自主”的贡献,但研究者描述了“显著的生命迹象”,暗示这类贡献可能很快出现。
这引出一个更深层的担忧:当AI开始能够提出有意义的研究方向假设,人类研究员最后的独特价值——直觉和方向感——是否也会被逐步侵蚀?Meter的报告没有给出定论,但它记录的趋势线足够清晰。
基准饱和(Benchmark Saturation) 指AI模型在某一评测基准上的得分接近或达到上限,导致该基准失去区分能力。例如,当模型在MMLU、HumanEval等测试中得分超过90%后,研究者便难以通过该测试判断新模型是否更强。基准饱和本身是AI能力快速提升的副产品,但也带来评估困境:外部观察者可能低估进步速度,因为公开指标已触顶;而内部团队则被迫不断设计更难、更贴近真实研发任务的测试。Anthropic内部基准被反复加难,正说明模型能力增长已超出原有测量工具的覆盖范围。这一现象与“持续斜率变化”的判断相互支撑——如果进步只是偶发跳变,基准饱和不会呈现系统性、持续性的特征。
这意味着什么:未来一到两年的现实推演
把这份报告放回上下文,它印证了许多开发者过去一年的体感:模型发布越来越频繁,编码能力在某个节点后出现质变,整个开发工作流被重塑。Meter用第三方身份和内部数据,把这些体感变成了可引用的证据。
但报告真正的冲击力在于它的“无瓶颈”判断。如果Meter的评估成立,那么未来一年内,我们可能看到能力进步进一步加速,而不是线性外推。员工访谈中有人表示“完全可以认可一年取得两年以上的进展,甚至四倍也不疯狂”。这种量级的提速,对安全研究、对齐工作和监管节奏都构成直接压力。
当然,保持审慎同样必要。报告承认AI在自主提出高价值研究方向方面仍有局限,算力分配的透明度被主动收回,部分分析被删节。Anthropic和OpenAI承诺的员工级第三方访问尚未真正兑现。递归自我改进的“证据”是强信号,但不是终局判决。
可以确定的是,AI研发的加速已经不再只是实验室负责人的口头预警。它出现在第三方评估的图表里,出现在内部员工的访谈里,出现在被反复调难的基准测试里。接下来的问题不再是“是否在加速”,而是“我们准备好在加速中保持理解了”。
相关推荐
 科技前沿
Textly:Mac上任意位置抓取文字和表格的效率神器
Textly是一款Mac菜单栏效率工具,支持从截图、PDF、视频和应用中框选捕获文字与表格,保持行列完整并导出CSV、Markdown、TSV,还内置即时翻译和剪贴板历史。
 科技前沿
Frameboy:World Labs Atlas 世界模型浏览器实时体验
World Labs 在 Product Hunt 发布 Frameboy,基于 Atlas 世界模型的浏览器实时演示,移动相机即可在云端 GPU 生成新视角,最高 15 fps 串流,探索 AI 生成的可漫游世界。
 科技前沿
Keypause:一键锁定Mac键盘,清洁时不再误触
Keypause是一款Mac菜单栏应用,一键锁定键盘所有按键,方便清洁时避免误触。本文介绍其功能、使用体验、潜在风险及适用场景,帮你判断是否值得尝试。