调试会话的价值去哪了?AI Agent 排障记录的留存难题

AI Agent排障过程中的推理链比修复结果更有价值,但几乎总随会话关闭而消失。
一次训练任务的OOM排障引发了一个被长期忽视的工程问题:真正有价值的东西不是最终改动的那一行配置,而是Agent排查过程中的完整推理链——它排除了哪些假设、执行了哪些命令、根据什么线索锁定根因。这些内容放进Git毫无意义,却几乎没有工具为它提供归属之地。文章梳理了三种可能的去向:附在W&B等实验追踪工具的run旁、写进PR描述,或就此消失在终端里。自动生成摘要听起来是解法,但面临知识留存与信息噪音之间的核心张力——摘要只有在足够精炼、按需触发、可检索的前提下才真正有用,否则会沦为另一堆被忽视的背景杂音。
一条配置修复背后,被丢弃的半小时
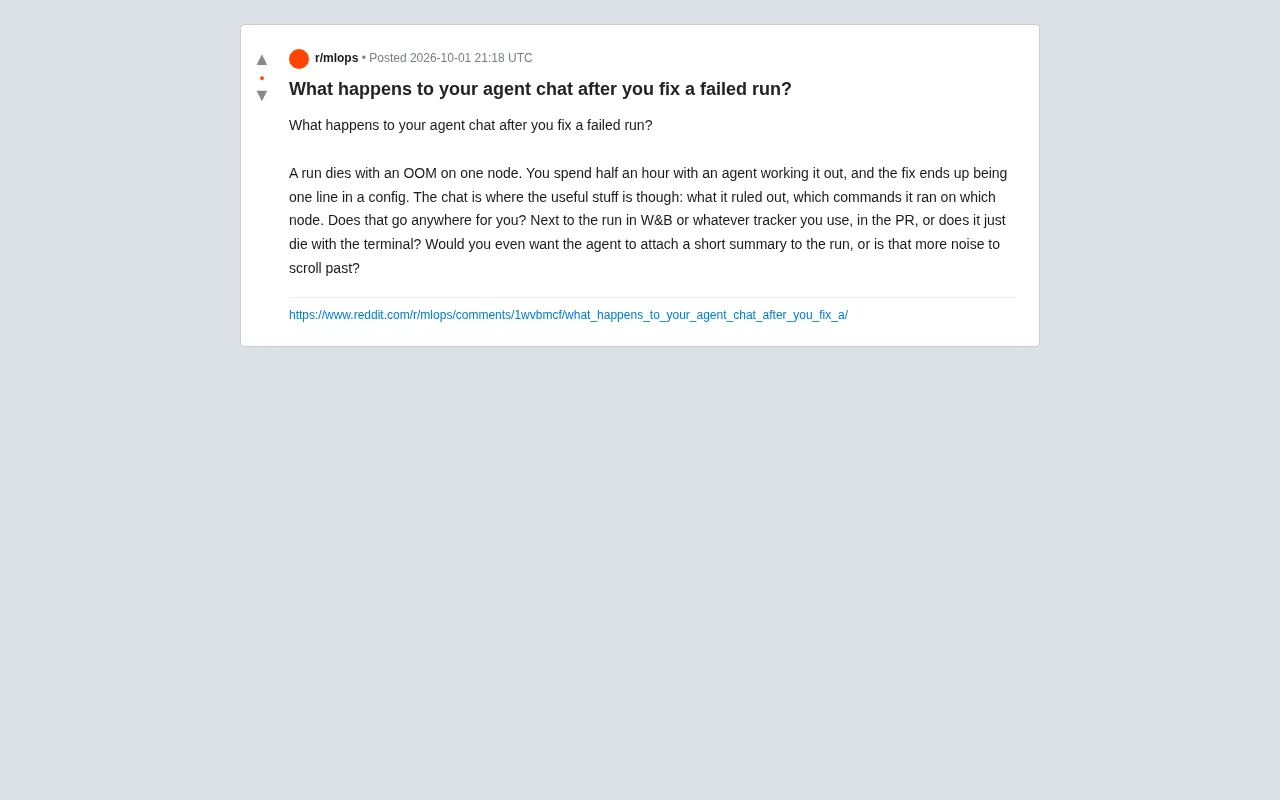
Reddit 上一个来自机器学习工程实践的讨论,戳中了很多人日常工作的痛点:一次训练任务因为某个节点的 OOM(内存溢出)崩溃了。你花了半个小时,和 AI Agent 一起排查,最终发现修复方案只是配置文件里改动的一行。
问题来了——真正有价值的东西,其实藏在那段对话里:Agent 排除了哪些可能、在哪个节点上跑了哪些命令、根据什么线索一步步锁定了根因。而这些,往往随着终端窗口的关闭,一起消失了。
对话才是资产,而不是那一行代码
这个讨论本质上提出了一个被长期忽视的观点:调试过程中的推理链,比最终的修复结果更有复用价值。
一行配置修改放进 Git 提交记录很容易,但它无法回答「为什么是这一行」。当三个月后同样的 OOM 在另一个节点重现,或者团队里另一个人遇到类似症状时,那一行 diff 几乎提供不了任何上下文。相反,如果能保留下来:
- Agent 最初怀疑的几个方向(比如 batch size、数据加载、梯度累积)
- 它在哪些节点执行了哪些诊断命令
- 哪些假设被数据证伪、被逐一排除
这些才构成了可迁移的工程知识。换句话说,排障的「思考过程」是一种隐性资产,而当前的工具链几乎没有为它提供归属之地。
这些记录,应该落到哪里?
原帖作者抛出了几个具体的去向选项,也恰好对应了实际工作流里的几个关键节点:
跟随 Run 存放在实验追踪工具里
把 Agent 的排障摘要附在对应的 run 旁边——比如 W&B(Weights & Biases)或其他 tracker。好处很直接:知识和它所解决的具体任务绑定在一起,下次查看这个 run 的失败记录时,修复的来龙去脉触手可及。
W&B(Weights & Biases)是机器学习工程中主流的实验追踪平台,用于记录每次训练任务(run)的超参数、指标曲线、系统资源占用等元数据。类似的工具还有 MLflow、Neptune、Comet ML 等。这类平台的核心价值在于将模型训练的「可复现性」从代码层延伸到实验上下文层——你不只能看到某次 run 的最终精度,还能回溯它当时的配置和环境。将 Agent 排障摘要附在对应 run 旁边,实际上是在将「为什么这个 run 失败、如何被修复」纳入同一套可查询的上下文体系,使实验记录从单纯的指标日志升级为包含工程决策的知识库。
写进 PR(Pull Request)
如果修复最终以代码变更的形式合入,把排障摘要放进 PR 描述里,能让 reviewer 和未来的维护者理解改动的真正动机。这让「一行改动」有了可审计的决策背景。
或者,它就这样消失在终端里
这是现实中最常见的结局。会话结束、窗口关闭,半小时的协作推理归零。下一次踩同样的坑,依然要从头来过。
真正的矛盾:知识留存 vs. 信息噪音
这个讨论最有价值的地方,在于它没有把答案想当然。作者紧接着提出了一个反问:
你会希望 Agent 自动给 run 附上一段简短摘要吗?还是说,那只是又一堆需要你滚动略过的噪音?
这是自动化知识沉淀绕不开的核心张力。自动生成摘要听上去很美,但如果每个 run 都挂着一段啰嗦、低信噪比的总结,它很快会变成被所有人忽视的背景杂音——就像那些没人读的自动化日志。
真正有用的实现,关键或许不在「要不要留存」,而在于:
- 摘要是否足够精炼,只保留根因、排除项和最终修复,而非复述整段对话
- 是否按需触发,比如只在失败 run 被人工修复后才生成,而不是每次都刷屏
- 是否可检索,让这段知识在未来相似症状出现时能被主动召回,而不是被动埋没
这一张力在软件工程中并不陌生。自动化注释、IDE 的智能提示、CI/CD 流水线的构建日志,都曾面临同样的困境:工具生成的信息密度越高,工程师的注意力过滤成本就越高,最终导致「警报疲劳(alert fatigue)」——人们习惯性地忽略所有自动产出的内容,即便其中偶尔夹杂真正重要的信号。信噪比管理因此成为 AI 辅助工具设计的核心工程问题,而非单纯的 UX 细节。摘要的价值不取决于它是否存在,而取决于它出现的时机、呈现的密度,以及它是否与工程师的决策动作直接关联。
给工程团队的启示
虽然这只是一个开放式提问,但它映射出 AI Agent 深度介入开发运维后一个值得认真对待的命题:当协作对象从人变成 Agent,协作过程的记录方式也需要重新设计。
过去结对编程的知识靠口头和文档传递,如今大量排障发生在人与 Agent 的私密会话中。如果没有一个承接层,这些高价值的推理过程就会系统性地流失。对于重视工程效率的团队,值得现在就思考:你们的 Agent 会话,修完 bug 之后到底去了哪里?
(本文基于 Reddit 社区的讨论整理,属单一来源,相关观点为开放式提问而非定论。)
相关推荐

Heretic 2.0 发布:从去审查到通用模型修改工具
Heretic 2.0 正式发布,新增任意秩消融(ARA)算法与插件系统,从去审查专用工具进化为可抑制废话、降低谄媚、调整情感对齐的通用模型修改平台。37k GitHub 星标,Hugging Face 衍生模型超 8500 个。
本地大模型硬件怎么选?MacBook Pro vs Mac Mini+iPad深度对比
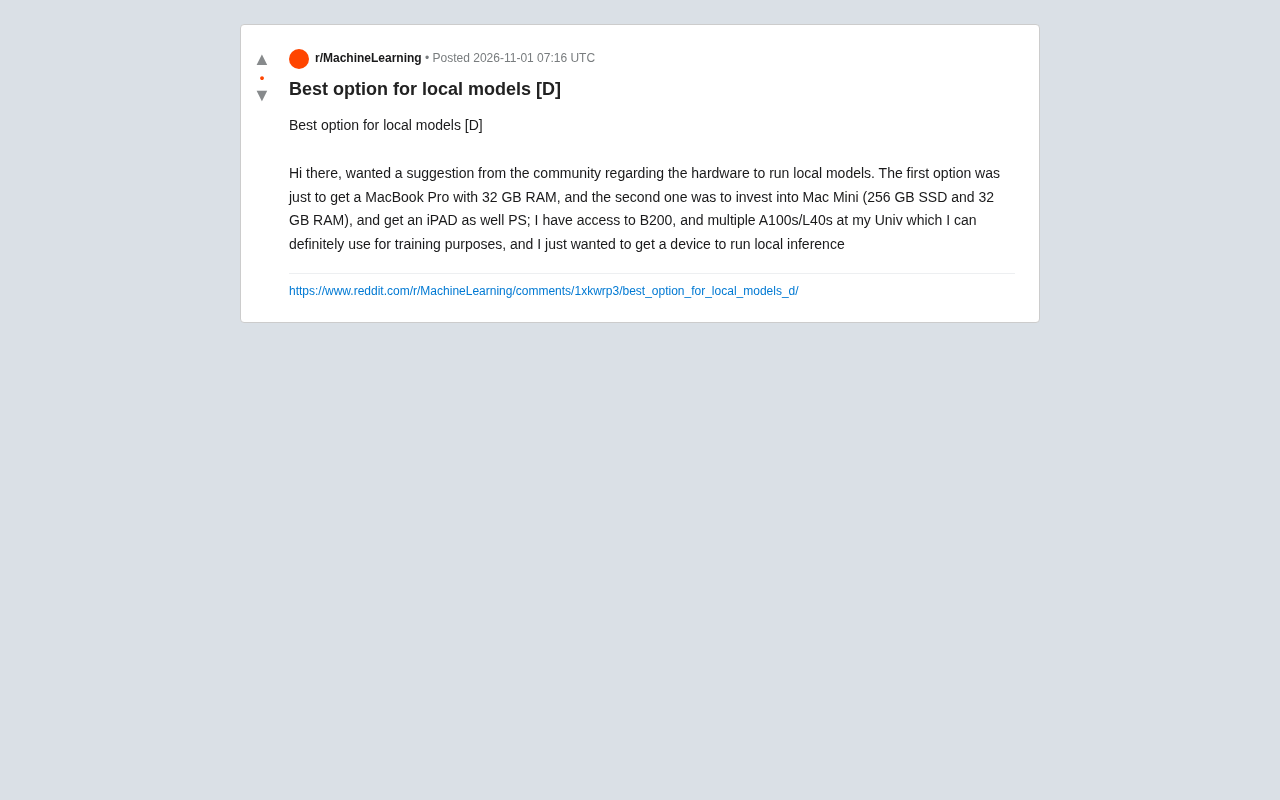
Reddit社区热议本地大模型硬件选择:32GB MacBook Pro与Mac Mini+iPad组合如何取舍?本文从便携性、性价比、内存需求等角度深度分析,帮你找到最适合本地推理的设备方案。

AI Agent失败溯源:如何定位错误决策的根因?
Reddit讨论聚焦AI Agent失败溯源难题:如何定位导致Agent做出错误决策的根因?分析LangSmith、LangFuse等可观测性工具的局限,探讨手动分析与自建分析系统的实践组合,为Agent可靠性提升提供思路。