Dify工作流入门:从部署到AI应用搭建全解析
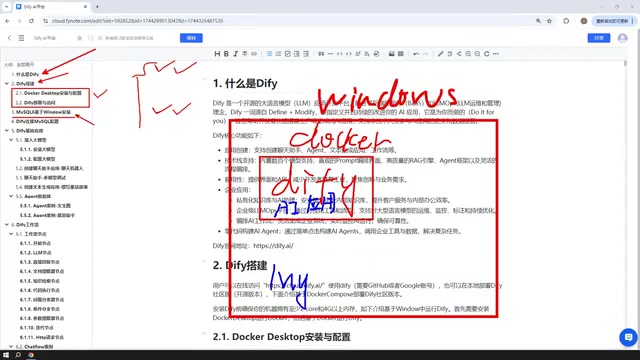
梳理 Dify 的核心功能、部署路径、模型接入与应用发布方式。
本文基于 B 站一门号称可搭建 30+ AI 应用的 Dify 教程,系统梳理了该平台的关键环节。Dify 提供聊天助手、文本生成、Agent 智能体、ChatFlow 和 WorkFlow 五类应用入口,通过可视化节点组合降低开发门槛。部署上推荐 Windows + Docker 的入门方案,MySQL 装在宿主机供容器内 Dify 访问,生产环境则建议自建服务器。模型接入主张优先使用付费 API(如 DeepSeek,成本极低),本地 Ollama 模型适合硬件充足的场景。应用可发布为公网站点、嵌入自有网站或通过 API 集成。文章认为 Dify 为快速验证 AI 想法提供了从部署、建模到发布的完整路径。
Dify 作为一款开源 AI 应用开发平台,正在成为许多开发者构建智能体、知识库和自动化流程的首选工具。B 站上有一门“保姆级”教程,宣称能带用户从零搭建 30+ AI 应用,覆盖智能体、知识库和自动化场景,并附完整源码。本文基于该教程内容,梳理 Dify 的核心功能、部署路径、模型接入策略以及应用发布方式,帮助你判断它是否适合你的项目。
Dify 是什么:一个快速构建 AI 应用的平台
Dify 可以被理解为一个 AI 应用构建平台。通过它,开发者能比较快捷地搭建企业级或个人使用的 AI 应用。教程作者指出,Dify 的核心价值在于降低 AI 应用的开发门槛——你不需要从零编写前端、后端和模型调用逻辑,而是通过可视化界面组合节点、配置模型和数据库连接,就能生成可用的应用。
从应用类型来看,Dify 官方提供五类创建入口:聊天助手、文本生成、Agent 智能体、ChatFlow 和 WorkFlow。前三种属于基础应用,后两种属于工作流范畴。教程强调,这五类应用基本覆盖了 Dify 的主要使用场景,后续课程也会围绕它们展开案例教学。
RAG(检索增强生成)是 Dify 知识库类应用的核心机制:用户将文档上传后,Dify 会先对文本分段、向量化并存入向量数据库,用户提问时系统先检索出最相关的片段,再把这些片段作为上下文交给大模型生成答案。这一流程能显著缓解模型“胡编乱造”的问题,也让回答可以引用企业私有资料。理解 RAG 的检索—拼接—生成三步,有助于在 Dify 中正确设置分段长度、召回数量和相似度阈值等参数,否则容易出现检索不到或上下文超长的情况。
部署方式:Windows + Docker 是入门首选
教程选择基于 Windows 的 Docker 来部署 Dify。这样做的好处是,Dify 运行在 Docker 容器中,但可以通过网络访问宿主机 Windows 上的 MySQL 数据库或其他环境。对于个人学习和小型团队内部使用,这种部署方式比较方便。
作者也提到另外两种选择:一是基于源码部署,适合需要深度定制的情况;二是直接使用 Dify 官方提供的在线页面。在线版功能与自部署版基本一致,但当应用需要访问本机数据库或本地环境时,可能需要内网穿透工具将本机 IP 暴露到公网。生产环境则建议自行部署到公司内部服务器,以便更好地控制数据和网络。
数据库连接:为什么要在 Windows 上装 MySQL 8
教程专门用一节讲解 MySQL 8 在 Windows 上的安装。原因在于,后续在 Dify 中构建的 AI 应用需要读取数据库数据,完成 AI 交互。将 MySQL 安装在 Windows 宿主机上,Docker 中的 Dify 可以通过网络与它通信;同样,如果 MySQL 部署在 VMware 虚拟机或 Docker 中,Dify 也能连接。关键是要让 Dify 能访问到数据库地址和端口,具体配置会在教程第四部分展开。
对于已经熟悉 MySQL 安装的读者,这一节可以跳过;但如果你是刚接触 Dify 的开发者,理解 Dify 与外部数据库的通信关系,是搭建知识库类应用的基础。
五类应用与工作流节点:ChatFlow 和 WorkFlow 的区别
Dify 的五类应用中,聊天助手、文本生成和 Agent 智能体属于基础应用。聊天助手用于对话交互,文本生成用于文章、文档、小说等内容创作,Agent 智能体则能调用工具完成多步指令,例如先爬取网页再进行分析。
工作流部分包含 ChatFlow 和 WorkFlow。教程用一句话概括区别:ChatFlow 支持与工作流进行聊天式交互,而 WorkFlow 更偏向一次性输入输出。两者在构建时都需要组合“节点”——每个节点是一个功能模块,比如模型调用、条件判断、数据处理等。教程表示会讲解常用节点,并配备十几个案例,帮助理解工作流的构建逻辑。
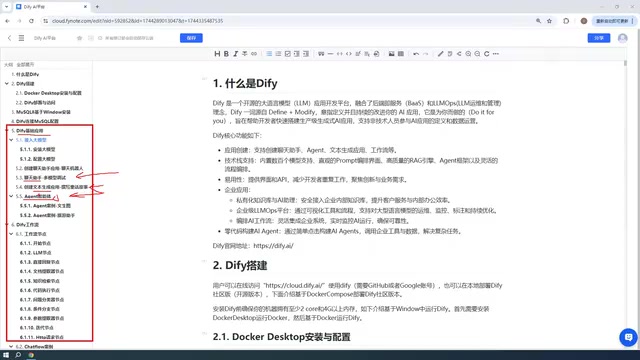
Dify 中的“节点”是工作流的最小执行单元,常见类型包括 LLM 节点(调用模型生成内容)、知识检索节点(从知识库召回片段)、条件分支节点(按变量值走不同路径)、代码节点(执行 Python/JS 片段做数据清洗)、HTTP 请求节点(调用外部接口)以及变量聚合、迭代等控制类节点。节点之间通过变量传递数据,前一个节点的输出可作为后一个节点的输入。掌握变量作用域与节点连线逻辑,是判断一个工作流能否按预期运行的关键,也是教程中大量案例反复训练的核心技能。
模型接入:付费 API 优先,本地模型量力而行
在接入大模型时,教程建议优先使用付费 API,例如 DeepSeek广告、ChatGPT,或者百度文心一言、阿里通义千问广告等提供免费 token 的国内模型。作者算了一笔账:DeepSeek 充值 10 元可以用很久,自己的账户用了不到 1 元。付费模型的效果通常比本地小模型更稳定,适合应用开发初期快速验证。
教程也提到 Dify 可以关联 Ollama 本地模型,并会配案例讲解。如果机器性能足够好,或者企业有集群部署的 Ollama,下载大参数模型(如 DeepSeek 开源的大模型)也能构建企业级应用。但作者提醒,本地小模型效果有限,不建议作为主力开发模型。
Ollama 是一个本地大模型运行工具,提供统一的命令行与 API 接口,可一键拉取并运行 Llama、Qwen、DeepSeek 等开源模型。Dify 通过配置 Ollama 的服务地址(默认 11434 端口)将其作为模型供应商接入。需要注意,本地模型的推理速度与显存、内存强相关,参数量越大对硬件要求越高;量化版本虽能降低显存占用,但精度会有所下降。因此在开发验证阶段用云端 API、在数据敏感或离线场景再切换本地模型,是较为务实的组合策略。
应用发布:从本机到公网站点
构建好的 Dify 应用不局限在 Dify 页面内使用。教程最后会讲解应用发布:可以将应用发布为公开 Web 站点,生成链接供他人访问;也可以嵌入到自己开发的网站,或通过 API 方式集成到其他系统。公网发布同样可能涉及内网穿透,需要根据实际网络环境配置。
对于想快速验证 AI 应用想法的开发者,Dify 提供了一条从部署、建模到发布的完整路径。教程的“30+ 应用”更多是案例数量的承诺,实际价值在于通过反复练习熟悉节点组合和模型配置。如果你正考虑用 Dify 搭建第一个 AI 应用,可以从 Windows + Docker 部署开始,先跑通聊天助手,再逐步尝试工作流和 Agent。
相关推荐
ICLR 2027仍在发拒稿信,学术圈苦AI水文久矣
ICLR 2027持续对低质量投稿发出desk reject,Reddit社区对此表示支持。本文分析AI生成论文泛滥下学术会议的初筛压力、评价体系激励扭曲,以及研究者该如何应对。
Anthropic印度公司早于Claude?一个名字引发的趣闻
Reddit网友发现印度存在一家早于AI公司Anthropic的同名企业,引发对品牌命名与商标保护的讨论。本文梳理这一趣闻的来龙去脉与启示。
Qwen Image 2.1本地32项实测:数数翻车,动漫风格意外能打
B站UP主Luke的DevLab用RTX 5090本地实测Qwen Image 2.1共32项:拼写与空间布局可靠,苹果计数翻车,动漫风格优于写实人体,自行车轮辐条等几何结构明显短板,画面反复出现疑似训练数据残留的紫色印记。