Dify工作流入门指南:从零搭建AI应用完整教程
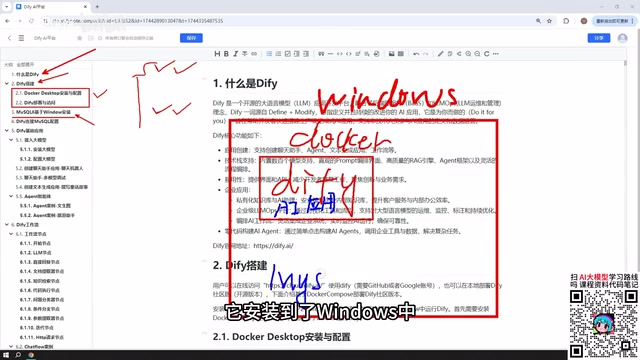
Dify低代码AI应用平台入门指南:部署、五类应用类型与模型接入全览
本文是一套以Dify为核心的AI应用开发入门教程概览。Dify是一款将大模型调用、工作流编排等能力封装为可视化模块的低代码平台,支持在线、Docker、源码三种部署方式,教程推荐在Windows上用Docker本地部署并配套安装MySQL 8以便AI应用访问数据库。平台提供五大核心应用类型:上手最简单的聊天助手与文本生成、能够调用工具完成多步骤任务的Agent智能体,以及支持持续对话的Chatflow和一次性输出的Workflow工作流。模型接入方面,教程建议优先选择DeepSeek、通义千问等价格低廉或含免费额度的云端模型,不建议入门者依赖本地小模型。构建好的应用可发布为公开Web站点、嵌入第三方网站或通过API对外调用。
Dify是什么:低代码构建AI应用的平台
Dify是一款面向AI应用开发的低代码平台,无论是企业级应用还是个人使用场景,都能借助它快速搭建。它的核心价值在于把大模型调用、工作流编排、数据交互等能力封装成可视化模块,让不具备深厚工程背景的用户也能落地AI应用。
对于初次接触的人来说,可以把Dify理解成一个「AI应用工厂」——你不需要从头写代码调用API、管理对话状态、拼接提示词,而是通过拖拽节点、配置参数来完成整个应用的构建。这也是它近期在开发者社区中热度攀升的原因。
三种部署方式:在线、Docker与源码
Dify提供了灵活的部署选择,适配不同使用场景:
- 官方在线页面:无需部署,直接使用官方托管的Dify界面,功能与本地版本基本一致。缺点是如果应用需要访问本机数据库或本地环境,需要借助内网穿透工具把本机IP暴露到公网。
- Docker部署:本教程采用的方案,基于Windows安装Docker后部署Dify。这种方式下本机的MySQL等环境可以被Dify直接访问,适合公司内部应用。
- 源码部署:适合需要深度定制的开发者。
教程作者强调,生产环境建议自己部署,尤其是需要与内部数据库、本地服务打交道的场景,本地Docker部署会更加方便可控。
为什么要配套安装MySQL 8
教程中专门用一节讲解在Windows上安装MySQL 8,原因很直接:后续在Dify中构建的AI应用往往需要访问数据库,做数据读取和AI交互。因此需要一个可用的数据库环境。
值得一提的是,MySQL的部署位置相当灵活——你可以装在Windows本机、用Docker部署,或放在VMware虚拟机上都没问题。Docker安装完成后,Dify的网络能够与Windows本机的MySQL、以及同一节点上虚拟机里的MySQL正常通信。安装完成后,还需要在Dify中完成连接MySQL的相关配置,才能让AI应用顺利读取数据库数据。
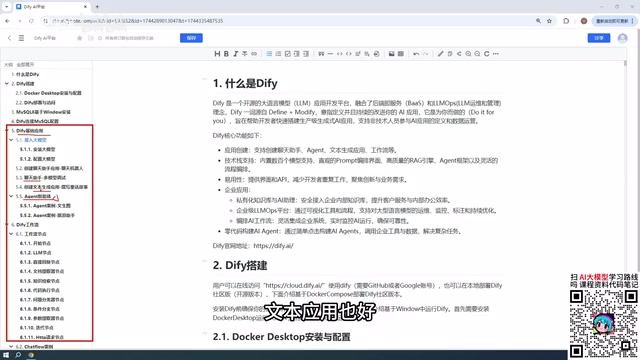
Dify的五大核心应用类型
这是整个教程的核心骨架。Dify官网提供的应用创建入口主要分为五种类型,前三种属于基础应用:
聊天助手与文本生成
聊天助手是最简单的形态,本质就是与AI大模型进行对话交互。文本生成则专注于内容产出,比如撰写文章、生成文档、创作小说、编写故事等一次性的生成任务。这两类应用上手门槛最低,适合作为入门起点。
Agent智能体
Agent智能体与前两者的关键区别在于能够调用工具。它可以系统地使用多个工具来完成用户的复杂指令。比如「先爬取网页、再对内容做分析」这样的多步骤任务,就需要Agent来编排完成。这让应用从「对话」升级到「执行任务」。
Agent(智能体)的底层逻辑源于「ReAct」(Reasoning + Acting)框架:模型先对任务进行推理,决定调用哪个工具、传入什么参数,收到工具返回结果后再继续推理,循环往复直到任务完成。这与普通对话模型「一问一答」的机制截然不同。在Dify中,Agent可以挂载的工具包括网络搜索、代码执行、数据库查询、HTTP请求等,也支持接入自定义工具。理解Agent的关键是认识到它本质上是「模型驱动的自动化流程」,模型自身负责规划步骤,而非由开发者手动写死执行顺序——这也是它比固定工作流更灵活、但稳定性相对更难把控的原因。
Chatflow与Workflow工作流
工作流是Dify的重头戏,分为两个部分:Chatflow(聊天流)和Workflow(工作流)。两者的核心差异其实很简单——Chatflow支持你与工作流进行持续对话,而Workflow只能进行一次性调用并输出结果。
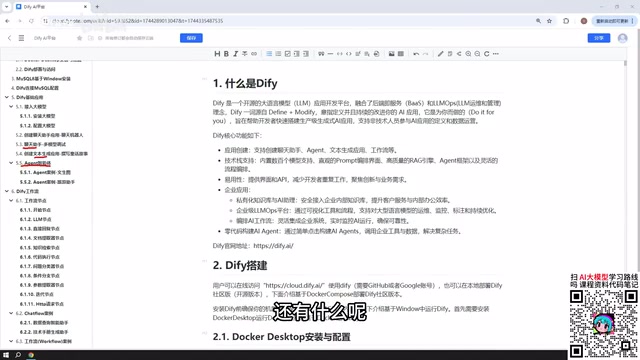
构建工作流的基本单元是节点。创建Chatflow或Workflow时,需要用一个个功能模块组合成完整的流程,每个模块就是一个节点。教程会重点讲解Dify中最常用的那些节点,这些节点几乎覆盖了官网提供的大部分能力,并且每个节点的使用都配有实操案例。
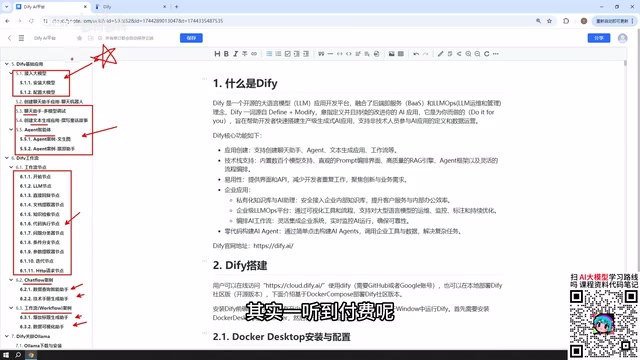
模型接入:优先选择付费云端模型
所有AI应用都需要与大模型交互,因此接入模型是绕不开的第一步。教程给出的建议很务实:优先使用付费的云端模型。
可选的模型包括:
- DeepSeek广告:需付费,但价格极低。作者透露自己充值10元,用了很久还没花到1元。
- ChatGPT:付费选项。
- 百度文心一言、阿里通义千问广告:注册后通常有百万级别的免费token,对入门学习完全够用。
关于本地模型,教程虽然会讲解Dify与本机Ollama部署模型的整合方式,但不太建议入门者使用本地小模型——因为普通机器能跑的模型参数量小,实际效果往往不理想。当然,如果你有企业级集群,能部署像DeepSeek开源的数百GB大参数模型(下载后可能超过400G),那用本地模型构建企业级应用同样可行,效果也会更好。
Token是大语言模型计量用量的基本单位,粗略来说中文约1.5个汉字对应1个token,英文约4个字符对应1个token。云端模型的计费通常按「输入token + 输出token」分开计算,输出价格一般高于输入。以DeepSeek为例,其API定价在主流模型中属于极低水平,这也是教程作者充值10元"用很久还没花到1元"的原因。百度文心一言、阿里通义千问等国内模型提供的百万免费token,折合成实际使用量大约够完成数千次完整对话,对于学习阶段验证功能来说相当充裕,无需担心费用问题。
应用发布:从本地走向公网
在Dify中构建的应用不只能在本地界面使用,平台提供了多种发布方式:
- 发布为公开Web站点:生成一个所有人都能访问的链接,发布到公网供他人使用(本地部署需配合内网穿透)。
- 嵌入网站:把应用集成到你自己开发的网站中。
- API调用:通过API或Python等方式在其他程序中调用构建好的Dify应用。
这一步让AI应用真正具备了对外服务的能力,而不仅仅停留在个人实验阶段。
内网穿透(如frp、ngrok、Cloudflare Tunnel等工具)是本地部署用户发布公开应用时绕不开的一步:本地Docker运行的Dify默认只能通过局域网IP访问,内网穿透工具会在公网服务器上开放一个固定域名或端口,把外部流量转发到你本机的对应端口,从而让外部用户可以访问你本地部署的服务。需要注意的是,这类工具会将本机服务暴露到公网,使用时应做好访问鉴权,避免数据库等敏感接口被未授权访问。
学习路径总结
综合来看,这套教程的学习脉络清晰:先搞懂Dify是什么与环境搭建(Docker + MySQL + 模型接入),再依次掌握聊天助手、文本生成、Agent、Chatflow、Workflow五类应用,最后学会应用发布。每个环节都配有实操案例,尤其工作流节点部分案例数量最多,是掌握Dify的关键所在。对于想快速入门AI应用开发的人来说,这是一条较为完整的实践路线。
相关推荐
开源分类模型对决:Qwen架构的Kev胜过Llama系Laya
海外博主实测两款开源AI分类模型:基于Llama的Laya与基于Qwen 3.5的Kev在客服工单路由任务上同台竞技,对比架构、资源占用、响应速度与语境理解准确率,Kev以26/30胜出。
Anthropic工程师弃用单体Agent:技能化AI构建的4个关键
Anthropic工程师不再为每个任务单独构建AI Agent,而是转向可复用的技能(Skills)机制。本文拆解让技能真正高效的4个关键:存复用代码、精确描述、持久化纠正、自带验证,助你用通用智能体打造自我进化系统。
绿灯却空转两个月:AI Agent流水线的"成功"陷阱
一条 AI Agent 流水线连续两个月报告成功却零产出,只因"成功"标志衡量的是运行是否完成而非是否有产出。本文剖析这个真实运维案例及其中隐藏的日志误导、退避策略误判等问题,探讨自动化系统该如何正确定义成功。