Dify入门到精通:20+企业级AI工作流实战指南

B站UP主Dify课程梳理:部署、五类应用、模型接入与发布全流程。
本文基于B站UP主的“Dify入门到精通”课程,系统梳理了Dify平台的核心使用路径。Dify作为可视化AI应用编排平台,可降低工程门槛,支持Windows Docker本地部署、源码部署和在线版三种方式,本地部署便于直接访问本机数据库。平台提供聊天助手、文本生成、Agent、Chatflow和Workflow五种应用类型,工作流是进阶重点,课程覆盖大部分节点并配案例。模型接入建议优先使用付费模型(如DeepSeek)或免费token,本机Ollama效果有限但企业级大模型可行。应用可发布为公开站点、嵌入网站或通过API调用。课程宣称一周完成20+案例,适合新手快速建立实战能力,但需注意版本时效性和口播冗余。
Dify 正在成为构建 AI 应用的热门选择,但多数教程停留在表面。一位 B 站 UP 主发布的“Dify 入门到精通”课程,宣称用一周时间手把手完成 20+ 个企业级实战项目,全程干货。本文基于该课程内容,梳理 Dify 的核心概念、部署路径与应用类型,帮你判断它是否值得投入时间。
Dify 是什么:快速构建 AI 应用的平台
课程开篇将 Dify 定义为“一个 AI 平台”,通过它能够快捷地构建 AI 应用,覆盖个人使用与企业级场景。与直接调用大模型 API 不同,Dify 提供了可视化的应用编排层,让开发者把精力放在业务逻辑而非底层集成上。
这一判断与社区共识一致:Dify 的价值在于降低 AI 应用的工程门槛。UP 主强调,课程内容围绕 Dify 的使用展开,而非深究其源码,适合希望快速上手的开发者。
可视化编排层是 Dify 区别于直接调用大模型 API 的核心机制。传统开发中,实现一个多轮对话或工具调用应用需要自行编写提示词管理、上下文维护、函数路由等逻辑;Dify 将这些能力封装为图形化节点和配置面板,开发者通过拖拽与填写即可完成应用搭建。其底层通常包含模型抽象层(统一不同厂商 API 的差异)、工作流引擎(按有向图顺序执行节点)以及运行时上下文管理(保存对话历史与变量)。这种设计类似于低代码平台,但专为 LLM 应用优化,降低了从原型到部署的工程成本。
部署选择:本地 Docker、源码还是在线版?
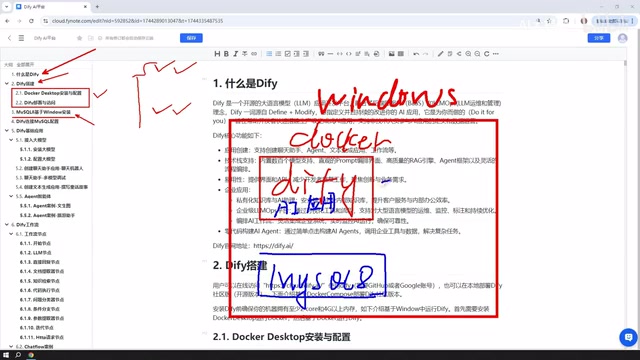
Dify 提供三种使用方式,课程重点演示了基于 Windows Docker 的本地部署。
本地 Docker 部署的优势
UP 主选择 Windows + Docker 部署 Dify,核心原因在于数据与环境的连通性。本地部署后,Dify 可以直接访问本机的 MySQL 或其他服务,无需额外的内网穿透。对于生产环境,他建议“自己部署到本机在公司内部应用”,这样更便于管控。
在线版的局限
官方在线版页面与自部署版本几乎一致,但当应用需要读取本机数据库或调用本地环境时,必须借助内网穿透工具将本机 IP 暴露到公网。这增加了配置复杂度和安全风险,因此课程选择本地部署作为教学主线。
为什么需要 Windows 安装 MySQL 8
课程专门用一节讲解 MySQL 8 在 Windows 上的安装。逻辑在于:Dify 运行在 Docker 中,而 AI 应用需要读取业务数据,把 MySQL 装在 Windows 宿主机上,Dify 容器就能通过网络与它通信。UP 主也提到,MySQL 8 可以基于 Docker 部署,或放在 VMware 虚拟机中,位置灵活,只要网络可达即可。
Docker 容器默认拥有独立的网络命名空间,容器内的 localhost 指向容器自身而非宿主机。因此,运行在 Docker 中的 Dify 若要访问安装在 Windows 上的 MySQL,不能使用 127.0.0.1,而需使用宿主机的局域网 IP(如 192.168.x.x),并确保 MySQL 配置允许远程连接、Windows 防火墙放行 3306 端口。课程选择将 MySQL 放在宿主机,正是利用 Docker 的桥接网络实现容器与外部服务的互通,这也是本地部署时连接已有业务数据库的常见做法。
五大应用类型:从聊天助手到工作流
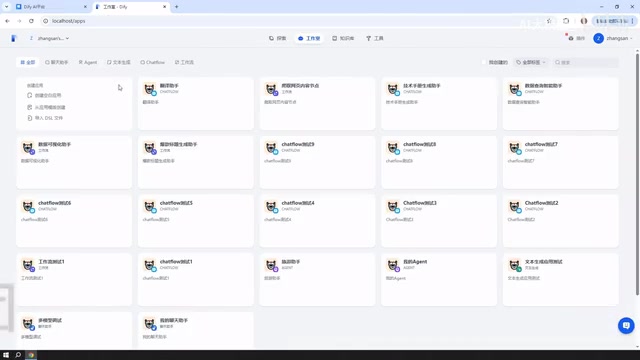
打开 Dify 创建应用时,会看到五种类型:聊天助手、文本生成、Agent、Chatflow 和 Workflow。课程对它们做了清晰区分。
基础三件套:聊天助手、文本生成、Agent
聊天助手用于多轮对话;文本生成适合撰写文章、文档或小说;Agent 智能体则能调用工具完成复杂指令,例如先爬取网页再进行分析。UP 主表示,这三类基础应用都会配备案例逐步操作。
工作流的两副面孔:Chatflow 与 Workflow
工作流是 Dify 的重点能力,分为 Chatflow(聊天流)和 Workflow(工作流)。简单理解:Chatflow 支持与工作流进行对话式交互,Workflow 则是一次性输入输出。课程后续会通过详实案例演示两者的构建与应用。
Chatflow 与 Workflow 的差异本质在于交互模式与状态管理。Chatflow 面向对话场景,保留多轮会话记忆,用户可在工作流执行过程中多次输入,适合客服、助手类应用;Workflow 面向批处理或单次任务,一次输入触发完整流程并返回结果,不保留对话状态,适合内容生成、数据处理等确定性任务。两者共享相同的节点体系,但 Chatflow 额外提供对话变量和会话历史节点,Workflow 则更强调输入输出的结构化定义。理解这一区别有助于在创建应用时选择正确的类型,避免后期重构。
工作流节点
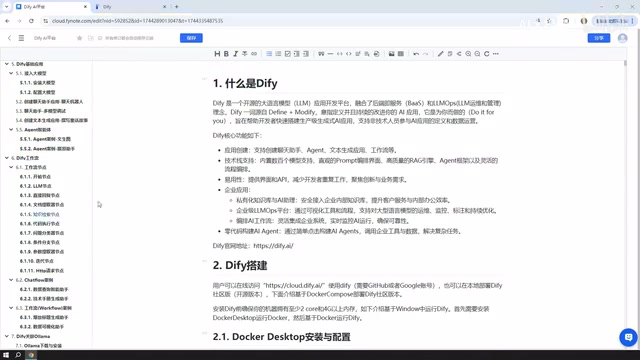
构建工作流需要一个个模块,即“节点”。课程将讲解常用节点,并几乎覆盖 Dify 官网提供的大部分节点类型,每个节点都配案例。UP 主提到,工作流节点相关案例有十几个,加上应用案例,总数超过 20 个,构成“企业级实战项目”的主体。
大模型接入:付费模型优先,本地方案谨慎
所有 AI 应用都离不开大模型。课程建议优先接入付费模型,如 DeepSeek广告、ChatGPT,或使用百度文心一言、阿里通义千问广告提供的免费 token(注册后通常有百万级别,足够学习使用)。
UP 主以 DeepSeek 为例:充值 10 元可以用很久,他的账户用了很久不到 1 元。
对于本机模型(如 Ollama),课程态度谨慎:虽然 Dify 可以整合 Ollama 部署的本地模型,但效果通常不太理想。不过,如果机器性能足够强,或企业有集群部署的大模型(如 DeepSeek 开源的大参数模型,下载体积可能超过 400G),用 Dify 构建企业级应用完全可行。
Ollama 是一个本地大模型运行工具,支持在个人电脑上拉取并运行 Llama、Qwen 等开源模型,通过本地 API 与 Dify 集成。课程对其效果持谨慎态度,主要原因在于:本地可运行的模型参数量通常较小(7B-14B),在复杂指令遵循、多步推理和工具调用上弱于云端大模型;同时,本地推理速度受限于消费级 GPU 或 CPU,难以支撑生产级并发。不过,若企业拥有 GPU 集群并部署大参数模型(如 DeepSeek 671B 等),本地化方案在数据隐私和成本控制上具备优势,此时 Dify 作为编排层仍可发挥价值。
应用发布:从本地到公开站点
构建好的应用不局限于 Dify 内部使用。课程最后会讲解发布方式:可以生成公开访问链接,发布为 Web 站点(需要内网穿透);也可以嵌入到自有网站,或通过 API(包括 Python API)调用。这为应用的实际落地提供了出口。
课程价值与适用人群
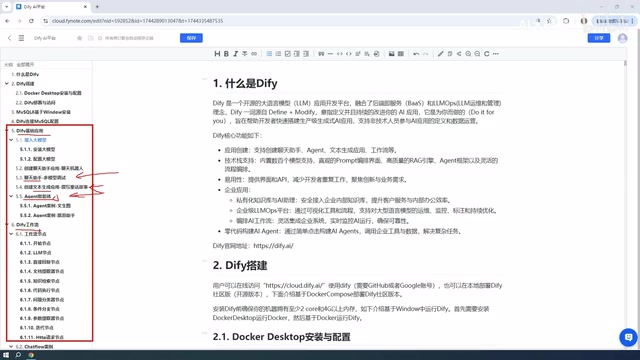
从大纲看,这门课程覆盖了 Dify 的核心使用路径:部署、数据库配置、五大应用类型、工作流节点、模型接入与发布。20+ 案例的承诺如果兑现,对新手而言是高效的入门路径。
需要留意的是,课程基于特定版本的 Dify 录制,工作流当时仍标注为测试版本,如今可能已有变化。另外,UP 主的口播内容存在重复和口语化表达,文字版学习时需自行提炼。总体而言,对于想在一周内建立 Dify 实战能力的开发者,这套教程值得参考。
相关推荐

Cursor AI编程实战:30分钟从零构建学生管理系统
B站UP主实战演示Cursor AI编程:30分钟用自然语言生成学生管理系统。详解Agent模式、Claude模型选择、提示词技巧与使用门槛,帮你判断Cursor是否值得入手。

AI编程工具20强榜单:从夯到拉的评分矩阵
B站UP主发布AI编程工具20强榜单,从夯到拉分为T0-T4五个层级,Claude Code和Codex并列T0。本文详解评分维度(能力、可靠性、耐操性、耐久性、成本、国内可用性)及工具表现,帮助开发者选择适合的AI编程助手。

Vibe Coding系统教程:零基础玩转AI编程实战
B站UP主耗时三个月打造的Vibe Coding系统教程,覆盖Codex、ClaudeCode、Cursor等AI编程工具,从基础逻辑到商业级项目实战三段式讲解,适合零基础学习者系统入门AI编程。