Dify入门教程:界面导览与Docker私有化部署完整指南

前言
Dify 是一款开源的大模型应用开发平台,越来越多的企业和开发者用它来构建生产级AI应用。从技术定位来看,Dify 属于 LLMOps(大语言模型运维) 平台范畴——这一概念脱胎于 DevOps 和 MLOps,专门解决大模型从实验室走向生产环境过程中的工程化挑战,涵盖提示词版本管理、模型切换、A/B测试、成本监控、数据飞轮等能力。Dify 将这些能力整合为统一的可视化平台,填补了「调用模型API」与「构建可靠生产应用」之间的工程鸿沟,使开发者无需从零搭建复杂的后端基础设施。
对于刚接触 Dify 的新手来说,首先需要搞清楚两个核心问题:平台的整体功能布局长什么样?如何选择适合自己的部署方式?
本文基于B站教程内容,系统梳理 Dify 的界面结构、四大核心功能模块,以及通过 Docker 完成本地私有化部署的完整流程,帮助你快速建立对 Dify 的全局认知。
两种使用方式:云端与私有化部署对比
Dify 提供了两种使用方式,适用于不同的场景和需求:
云端版本:直接访问 Dify 官网,通过邮箱或 Google 账号注册即可使用。操作简单,适合个人学习和快速体验,但免费版有应用数量限制(最多5个工作流)。
私有化部署(社区版):通过 Docker 在本地或服务器上部署 Dify,数据完全自主可控。Docker 诞生于2013年,基于 Linux 内核的 cgroups(控制组)和 namespaces(命名空间)技术实现进程级隔离。它将应用程序及其所有依赖项打包到一个称为"容器"的标准化单元中,与传统虚拟机相比,容器无需模拟完整硬件层,启动时间从分钟级缩短到秒级,镜像体积也从数GB压缩到数十MB。Docker 的分层镜像机制(Union File System)使得相同的基础层可以被多个容器共享,极大节省了磁盘空间。Docker Compose 则是 Docker 官方提供的多容器编排工具,通过声明式的 YAML 配置文件定义服务拓扑,支持一条命令完成多容器的创建、网络配置和卷挂载,是本地开发和中小规模部署的事实标准工具。Dify 的私有化部署涉及数据库、缓存、Web服务、Worker进程等多个组件,正是借助 Docker Compose 实现了一键拉起整套服务栈的便捷体验。
私有化部署不仅是技术选择,更是企业数据治理的重要手段。在金融、医疗、政务等强监管行业,数据不出内网是基本合规要求。私有化部署使企业完全掌控模型调用日志、用户对话数据和知识库内容,避免敏感信息通过第三方API泄露,同时也便于与企业现有的身份认证、审计系统集成。企业出于安全合规考虑,通常更倾向于这种方式。私有化部署没有应用数量限制,可以自由创建工作流,是企业生产环境的首选方案。
对于新手来说,建议先用云端版本熟悉界面和功能,有能力后尽早尝试社区版部署——实际企业项目几乎都采用私有化部署方案。
Dify四大核心功能模块详解
Dify 的主界面由四个核心菜单组成,各司其职,下面逐一介绍。
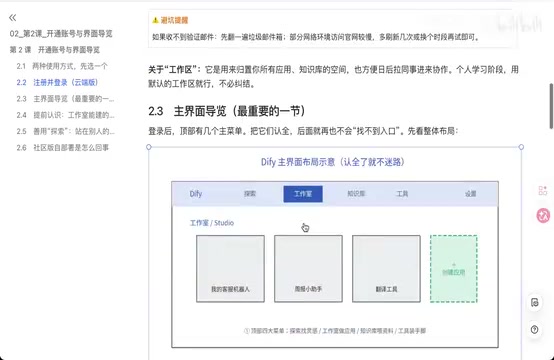
探索:官方模板与灵感来源
「探索」模块汇集了官方预制的应用模板,包括文件翻译、个性化记忆助手、聊天机器人、智能客服分流助手等。你可以直接点开模板创建使用,也可以学习别人的工作流设计思路。
这些模板背后体现了 提示词工程(Prompt Engineering) 的最佳实践积累。提示词工程是指通过精心设计输入文本的结构、角色设定、示例(Few-shot)和约束条件,引导大模型产生符合预期的输出的系统性方法。研究表明,同一个模型在不同提示词策略下的表现差异可达数十个百分点,因此研究优质模板的提示词设计,是快速提升 Dify 使用水平的高效路径。
虽然部分模板可能因插件缺失无法直接运行,但研究其工作流结构和提示词设计,对理解 Dify 的能力边界非常有帮助。
工作室:创建自己的AI应用
「工作室」是 Dify 的核心创作区域,支持创建三种类型的应用:
- 文本生成应用:适合单次输入输出的场景,类似普通的大模型调用
- 聊天助手:支持上下文记忆,可以挂载知识库,适合客服机器人等对话场景
- 工作流:通过可视化节点编排,实现复杂的多步骤AI流程
Dify 的工作流编排基于 DAG(有向无环图)结构。DAG 是计算机科学中描述任务依赖关系的经典数据结构,广泛应用于 Apache Airflow、Apache Spark、GitHub Actions 等工作流引擎中。「有向」意味着数据流有明确的方向(从上游节点流向下游节点),「无环」意味着不存在循环依赖,这一约束保证了工作流能够在有限步骤内终止执行。Dify 的工作流引擎基于 DAG 实现了节点的拓扑排序执行,支持并行分支(多个节点同时执行)和条件分支(根据运行时结果动态选择执行路径)。这种低代码/无代码的编排方式降低了AI应用开发门槛,使非程序员也能构建复杂的多步骤AI流程,同时保留了足够的灵活性供开发者进行深度定制。节点类型涵盖大模型调用、条件判断、代码执行、HTTP请求、知识库检索等,几乎可以满足所有企业级AI流程的编排需求。相比传统的线性脚本,DAG 编排使复杂业务逻辑的可视化表达成为可能,也便于局部调试和性能优化——开发者可以精确定位哪个节点是整体流程的性能瓶颈。
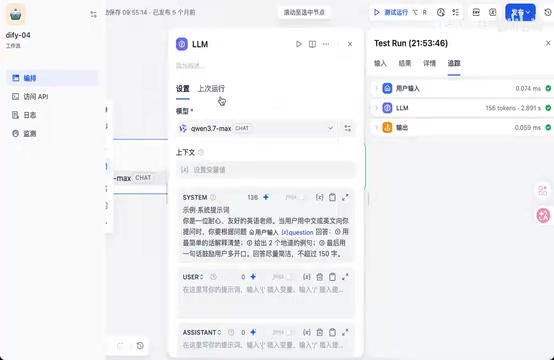
以一个简单的英语教学工作流为例:用户输入问题 → 经过大模型节点处理(系统提示词设定为"友好的英语老师")→ 输出回答。在工作流详情中,你可以看到每一步的输入输出、Token 消耗量和耗时。
这里需要理解 Token 的概念:Token 是大语言模型处理文本的基本计量单位。对于英文文本,一个 Token 大约对应4个字符或0.75个单词;对于中文文本,一个汉字通常被编码为1-2个 Token。大模型API的计费通常按输入 Token 和输出 Token 分别计价,例如 GPT-4o 的输入价格约为每百万 Token 2.5美元,输出价格约为每百万 Token 10美元。在 Dify 的工作流详情中查看 Token 消耗量,可以帮助开发者精确估算应用的运行成本,并通过优化提示词长度、减少不必要的上下文传递等方式来控制开支。
比如大模型节点耗时 2.889 秒,这时可以通过调整温度参数、优化提示词等方式来降低响应时间。温度(Temperature)是大语言模型推理时最重要的采样参数之一,取值范围通常为0到2。温度值越低,模型的输出越确定、越保守,倾向于选择概率最高的词;温度值越高,输出越随机、越有创造性,但也更容易产生不相关或不准确的内容。在实际应用中,客服问答、数据提取等需要准确性的场景通常将温度设为0-0.3;而创意写作、头脑风暴等场景则可以设为0.7-1.0。除温度外,Top-P(核采样)、频率惩罚(Frequency Penalty)等参数也会影响模型输出的多样性和质量,Dify 在模型节点中提供了这些参数的可视化调节入口。
知识库:上传和管理资料
「知识库」用于上传和管理AI应用需要引用的资料文档。它支持导入 PDF 等文件,也可以外接外部数据库。
知识库是实现 RAG(检索增强生成)的基础,让AI回答能够基于你提供的专业资料,而不仅仅依赖模型的预训练知识。RAG(Retrieval-Augmented Generation)由 Facebook AI Research 于2020年在论文《Retrieval-Augmented Generation for Knowledge-Intensive NLP Tasks》中正式提出,是当前企业级AI应用中最主流的知识增强方案之一。其核心创新在于将参数化知识(模型权重中存储的知识)与非参数化知识(外部文档库)结合,有效缓解了大模型的"幻觉"问题(即模型编造不存在的信息),同时避免了对模型进行昂贵的微调训练。
RAG 技术自提出后持续演进,形成了从朴素RAG(Naive RAG)到高级RAG(Advanced RAG)再到模块化RAG(Modular RAG)的技术代际。朴素RAG直接将检索到的文档片段拼接到提示词中,高级RAG引入了查询改写、重排序(Reranking)、混合检索等优化手段,而最新的 GraphRAG(由微软研究院于2024年提出)则将知识图谱与向量检索结合,通过实体关系网络实现跨文档的深层推理,特别适合需要综合多源信息的复杂问答场景。
RAG 的典型流程包括文档分块、向量化(Embedding)、存入向量数据库、语义检索和上下文拼接五个环节。其中,Embedding 是将文本转化为高维数值向量的过程,语义相近的文本在向量空间中距离更近。向量数据库专门用于存储和检索这些向量,通过 HNSW(分层可导航小世界图)等近似最近邻算法,能在亿级向量中实现毫秒级语义检索。Dify 的私有化部署默认集成了 Weaviate 作为向量数据库——Weaviate 是一款开源向量数据库,支持混合检索(向量检索+关键词检索),并内置了多种 Embedding 模型适配器。知识库模块正是对这一完整 RAG 流程的产品化封装,开发者无需手动处理向量化和检索的底层细节。对于需要领域专业知识的应用场景,知识库功能不可或缺。
工具:扩展AI的能力边界
「工具」模块让AI应用具备调用外部服务的能力。Dify 内置了网页抓取、代码解释器、时间查询、正则表达式等常用工具,还支持接入 MCP(Model Context Protocol)服务。
MCP(Model Context Protocol,模型上下文协议)是由 Anthropic 于2024年11月开源发布的一项标准化协议,其设计灵感来源于 LSP(Language Server Protocol)——后者通过标准化接口统一了代码编辑器与语言服务器之间的通信,彻底改变了IDE生态。MCP 采用类似思路,定义了 Resources(资源)、Tools(工具)、Prompts(提示模板)三类原语,旨在为大模型与外部工具、数据源之间建立统一的通信接口。从架构角度看,MCP 解决了 AI 工具集成的 M×N 问题——在没有统一协议的情况下,M 个 AI 平台要接入 N 个工具需要编写 M×N 套集成代码,而 MCP 将其降低为 M+N 的线性复杂度,类似于 USB 接口之于硬件设备。MCP 采用客户端-服务器架构,MCP Server 通过 stdio 或 SSE(Server-Sent Events)方式暴露工具能力,MCP Client(即AI平台)负责发现和调用这些工具,两者之间通过标准化的 JSON-RPC 协议通信。目前,包括 Dify、Claude Desktop、千问等在内的多个平台已支持 MCP 协议,OpenAI、Google DeepMind 等主要 AI 厂商也相继跟进,围绕它形成的工具生态正在快速扩展。
值得一提的是,千问等平台提供了 MCP 广场,里面有天气预报查询、高德地图、文档转 Markdown、图像语音处理等大量免费工具,可以直接添加到 Dify 中使用。
更强大的是,工作流本身也可以发布为工具。比如你搭建了一个翻译工作流,发布为工具后,就可以在其他工作流中作为节点调用,实现"一层套一层"的复杂编排。这种模块化设计思想与软件工程中的函数复用原则一脉相承——将经过验证的子流程封装为可复用单元,不仅减少了重复建设,也使整体系统更易于维护和测试。这是 Dify 工作流灵活性的重要体现。
模型配置与API接入设置
在开始创建应用之前,必须先完成模型配置。正确的新手操作动线是:先接好模型,再回工作室创建应用。
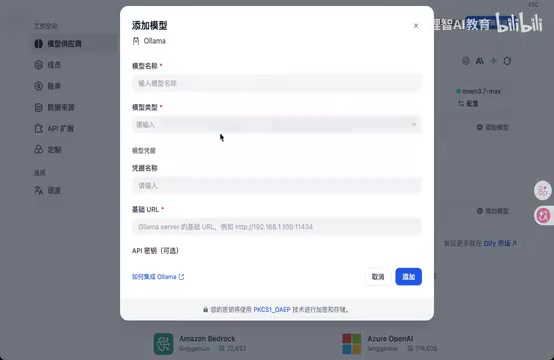
模型配置入口在右上角的「设置」中,主要涉及两个部分:
模型供应商配置:用于配置云端大模型的 API Key,比如 OpenAI、千问等。购买了哪家的 API Key,就在对应的供应商处填入即可。API Key 是访问大模型服务的身份凭证,本质上是一串随机生成的字符串,用于在每次 HTTP 请求中验证调用方身份并关联计费账户。需要注意的是,API Key 应当妥善保管,避免硬编码在代码中或提交到公开代码仓库,Dify 的设置界面对 Key 进行了加密存储,是相对安全的管理方式。
本地模型接入:如果你使用 Ollama 或 vLLM 在本地部署了模型,可以通过添加模型的方式接入 Dify。Ollama 是一款开源的本地大模型运行框架,支持在个人电脑或服务器上一键下载和运行 Llama 3、Qwen、Mistral、Gemma 等主流开源模型,封装了模型量化、GPU加速、API服务等底层复杂性,用户只需一条命令(如 ollama run llama3)即可启动模型并获得兼容 OpenAI 格式的本地API接口。
Ollama 支持多种量化精度(如 Q4_K_M、Q8_0 等)。量化(Quantization)是将神经网络权重从高精度浮点数(FP32/FP16)压缩为低精度整数(INT8/INT4)的技术——以 Llama 3 70B 模型为例,FP16 精度下需要约140GB显存,而经过 Q4_K_M 量化后仅需约40GB,降幅达70%以上。Ollama 使用的 GGUF 格式支持多种量化级别:Q2_K 压缩率最高但质量损失明显,Q8_0 几乎无损但体积较大,Q4_K_M 是在质量与体积之间取得最佳平衡的常用选择,使普通消费级显卡(如 RTX 4090 的24GB显存)也能运行数十亿参数的大模型。vLLM 则是另一款高性能推理引擎,采用 PagedAttention 技术优化显存管理——该技术借鉴操作系统虚拟内存的分页思想,将 KV Cache(键值缓存,Transformer 注意力机制的中间计算结果)分割为固定大小的页面按需分配,相比传统连续显存分配方式可将显存利用率从约30%提升至接近100%,从而在相同硬件上支持更高的并发请求量,更适合高并发的生产环境。接入时需要填写模型名称、类型、认证信息和访问 URL。这种方式特别适合企业内网环境,模型和平台都在本地运行,数据不出内网,满足金融、医疗、政务等行业的严格合规要求。
此外,设置中还包括成员管理(控制谁可以访问工作区)、日志查看(查询历史对话记录)、监控面板(查看活跃消息数等运营数据)等实用功能。
Docker本地私有化部署实战
环境要求
在开始部署之前,请确认你的机器满足以下最低配置:
- CPU ≥ 2核
- 内存 ≥ 4GB
- 已安装 Docker 和 Docker Compose
如果机器配置低于这个要求,建议先使用云端版本进行学习。
部署步骤
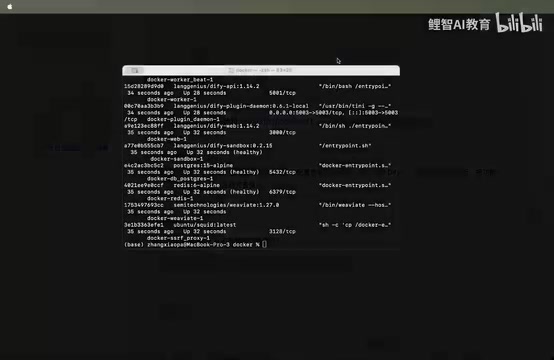
第一步:克隆Dify代码仓库
mkdir soft
cd soft
git clone https://github.com/langgenius/dify.git
Git 是目前最主流的分布式版本控制系统,git clone 命令会将远程仓库的完整历史记录和代码文件下载到本地。如果因网络原因访问 GitHub 速度较慢,可以考虑使用国内镜像源(如 Gitee 的镜像仓库)或配置代理加速。
第二步:进入Docker目录并准备配置文件
cd dify/docker
cp .env.example .env
.env 文件是 Docker Compose 的环境变量配置文件,Dify 将数据库连接信息、端口映射、密钥配置等参数都集中在这个文件中管理。通过复制 .env.example 模板来生成实际配置文件,是 Docker 项目中的标准做法,既保证了敏感信息不会被提交到代码仓库(.env 文件通常被加入 .gitignore),又方便开发者根据自身环境灵活调整参数。在生产环境中,建议修改 .env 中的默认密钥(如 SECRET_KEY、数据库密码等),避免使用示例文件中的弱密码带来安全风险。
注意:cp 命令在 Windows 下可能不可用,Windows 用户可以使用 copy 命令替代,或者直接在文件管理器中复制并重命名文件。
第三步:启动Docker服务
docker compose up -d
-d 参数表示以后台守护进程(detached)模式运行,容器启动后不会占用当前终端。首次执行时,Docker 会自动从镜像仓库拉取 Dify 所需的所有服务镜像,整个过程可能需要几分钟到十几分钟,取决于网络速度。Dify 的服务栈采用微服务架构,各组件职责明确:PostgreSQL 负责存储应用配置、用户数据和对话历史,作为关系型数据库提供 ACID 事务保证;Redis 作为高速缓存层处理会话状态和任务队列,得益于其基于内存的数据结构,读写延迟通常在微秒级别,同时 Redis 的 List 数据结构被用作消息队列,驱动 Dify 的异步 Worker 进程处理耗时任务;Weaviate 专门存储知识库的向量数据,支持近似最近邻语义检索;Nginx 则作为反向代理统一对外暴露服务端口,同时处理 SSL 终止和负载均衡。这种微服务架构使得各组件可以独立扩展和维护,例如在知识库数据量增大时可以单独扩容 Weaviate,而无需重启整个服务栈。
等待所有容器启动完成后,通过 docker ps 命令确认各服务状态为 healthy。
第四步:访问Dify管理界面
在浏览器中访问 http://localhost(默认80端口)或 http://localhost:8080,按提示设置管理员邮箱、用户名和密码即可进入系统。
常见问题:端口冲突怎么解决
如果 Docker 启动后无法正常访问,最常见的原因是默认端口被其他程序占用。端口冲突是本地开发中的高频问题,因为80端口常被本地 Web 服务器(如 Apache、IIS)占用,5432端口常被本地 PostgreSQL 实例占用。解决方法有三种:
- 找到占用端口的进程并终止(Linux/Mac 可用
lsof -i :80,Windows 可用netstat -ano | findstr :80) - 修改
.env文件中的端口配置,改为未被占用的端口 - 修改后重启 Docker 服务:
docker compose restart
应用类型选择指南
面对具体需求时,如何选择合适的应用类型?以"能记录上下文、还能挂载知识库的客服机器人"为例:
- 文本生成应用 ❌:无上下文记忆能力,不适合多轮对话
- 工作流 ⚠️:可以实现但默认不带上下文管理,需要额外配置
- 聊天助手 ✅:原生支持上下文记忆,可直接挂载知识库,最适合客服场景
这里涉及一个重要的技术概念——上下文窗口(Context Window)。大语言模型并不像人类一样拥有持久记忆,它只能"看到"当前输入窗口内的文本。聊天助手通过将历史对话记录拼接到每次请求的提示词中来模拟记忆,这意味着对话越长,消耗的 Token 越多,成本也越高。当对话长度超过模型的上下文窗口限制时,需要通过摘要压缩等策略进行处理。理解这一机制有助于在设计应用时合理规划对话轮次和成本预算。
选择应用类型的核心原则是:先理解业务流程,再决定技术方案。搭建工作流之前,必须先搞清楚业务逻辑是什么样的,然后才能合理编排各个节点。
总结与学习路径建议
Dify 的学习路径可以概括为四个阶段:认识界面 → 配置模型 → 创建应用 → 优化迭代。本文覆盖了前两个阶段的核心内容,包括四大功能模块的作用、模型配置方法以及 Docker 私有化部署的完整流程。
对于企业级AI应用开发,建议尽早熟悉私有化部署方式,并善用工具模块和 MCP 生态来扩展应用的能力边界。下一步可以尝试接入大模型,动手搭建一个聊天助手,在实践中加深对 Dify 各模块的理解。
核心要点
相关推荐

AI检测误判风波:作家被指用AI写作,谁该举证?
2026年英联邦短篇小说奖地区获奖者被Pangram检测工具判定100% AI生成,最终靠草稿自证清白。这起事件揭示了AI检测工具的误判风险与创作者面临的举证困境,以及作家协会承认没有可靠AI检测方法的现实。

Paul Ford新作引热议:Web本身已经足够
Paul Ford 文章《The Web Is More Than Enough》在 Hacker News 引发讨论,主张 Web 标准已足够承载应用开发,反对动辄引入封闭平台。本文梳理其核心论点、与当前 AI 应用潮流的张力,以及对开发者技术选型的实际含义。

斯坦福如何教授AI原生工程:CS146S课程揭秘
斯坦福CS146S课程直面AI一键生成作业的挑战,探索AI原生工程教育。Mihail Eric分享如何将AI作为工程伙伴,培养系统设计和代码审查能力,为工程教育提供新范本。