Dify入门全攻略:从0搭建AI应用的完整路线图

Dify是低代码AI应用构建平台,支持五类应用类型与本地Docker部署,助力快速搭建并发布AI应用。
Dify是一款低代码AI应用构建平台,通过可视化模块封装模型调用、工具编排等底层工程细节,让开发者无需大量编码即可搭建AI应用。平台支持官方在线、源码和本地Docker三种部署方式,其中本地Docker因可直连本机MySQL等服务而被重点推荐。Dify提供聊天助手、文本生成、Agent智能体、Chatflow和Workflow五大应用类型,涵盖从简单对话到复杂自动化流程的全场景需求。在模型接入上,教程建议优先使用DeepSeek等付费云端API,成本极低且效果优于普通硬件能跑的本地模型。构建完成的应用可发布为公开Web站点、嵌入网页或通过API调用,形成从开发到交付的完整闭环。
Dify是什么:低代码AI应用构建平台
Dify是一款面向AI应用开发的平台工具,核心价值在于让开发者无需从头写大量代码,就能快速搭建各类AI应用。无论是企业级的业务系统,还是个人使用的小工具,都可以通过它完成构建。
这款工具降低了AI应用的开发门槛。过去要把大语言模型接入实际业务,需要处理模型调用、上下文管理、工具编排等一系列繁琐工作。Dify把这些能力封装成可视化模块,用户通过拖拽和配置就能完成应用搭建。对于想快速验证AI想法、又不愿陷入底层工程细节的团队来说,这是一个高效的起点。
三种部署方式:本地Docker、源码与官方在线
Dify的部署有三条路径,各自适用不同场景。
- 官方在线版:最省事,直接打开官方页面即可使用,界面与自建版本基本一致。但它有一个明显限制——如果你的AI应用需要访问本机数据库或本地环境,就必须借助内网穿透工具,把本机IP暴露到公网。
- 源码部署:适合需要深度定制的开发者。
- 本地Docker部署:教程重点推荐的方式,基于Windows安装Docker来部署Dify。
选择本地Docker的好处很直接:本机上的MySQL、其他环境服务,Dify都能直接访问调用。在生产环境或公司内部应用场景中,自行部署到本机更方便可控。
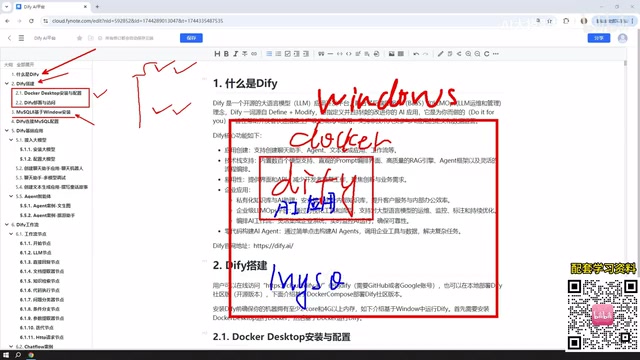
为什么要配套安装MySQL8
教程中专门留出一节讲解MySQL8在Windows上的安装,原因在于后续构建的AI应用往往需要与数据库交互。
这里的网络拓扑逻辑是这样的:Windows节点上安装Docker并部署Dify,同时在Windows上(或通过Docker、虚拟机)安装MySQL8。Dify部署完成后,其网络既能与Windows本机的MySQL8通信,也能与VMware部署的虚拟机通信。换句话说,MySQL放在哪里都不影响Dify调用——这是本地部署在数据连通性上的优势。
如果你已经熟悉MySQL8安装,这一节可以直接跳过。配置好数据库后,还需要掌握Dify连接MySQL的具体设置,这样AI应用才能正常读取数据库数据,完成有数据支撑的智能交互。
Dify的五大核心应用类型
这是整套教程的主干内容。在Dify创建应用时,可选的类型主要有五种:
聊天助手与文本生成
聊天助手是最基础的形态,本质就是与AI模型对话。文本生成则侧重一次性产出内容,比如撰写文章、生成文档、创作小说故事等。两者都属于入门级应用,概念直观,容易上手。
Agent智能体
Agent智能体与前两者的关键区别在于能调用工具。它可以系统性地使用多种工具来完成用户指令,比如先爬取网页、再对内容做分析,形成一条自动化的处理链路。这让AI不再局限于对话,而是能主动执行任务。
Agent智能体的底层运行机制通常基于「ReAct」框架(Reasoning + Acting),即模型在执行任务时会循环进行「思考→选择工具→观察结果→再思考」的过程,直到任务完成。这与普通聊天助手的单次问答有本质区别:Agent拥有自主规划能力,能把一个复杂目标分解为多个子任务,并按需调度不同工具。Dify中可接入的工具包括网页搜索、代码解释器、数据库查询、外部API等,开发者也可以自定义工具接口。值得注意的是,Agent的执行路径并非预先固定,而是由模型根据上下文动态决定,这使它更灵活,但也可能带来不确定性——在对结果要求严格可控的场景下,Workflow的固定流程往往比Agent更可靠。
Chatflow与Workflow:两种工作流
工作流是Dify中最重要的进阶能力,分为**Chatflow(聊天流)和Workflow(工作流)**两种。在当前版本中,工作流仍属测试版,但稳定性已经不错。
两者的核心差异在于交互模式:Chatflow支持与工作流进行持续对话;Workflow则是一次性执行,给出结果即结束。实际构建时,二者的使用方式和应用场景会有更细致的区别。
工作流(Workflow)这一概念源自业务流程自动化领域,核心思想是将复杂任务分解为一系列有序的步骤,并通过节点之间的数据流转来驱动执行。在AI应用场景中,工作流让开发者可以精确控制模型的输入输出、插入条件判断分支、调用外部服务,并在多个处理步骤之间传递结构化数据。Chatflow与Workflow的本质区别在于状态管理:Chatflow维护多轮对话的上下文记忆,适合需要来回确认信息的交互式场景(如客服、问答机器人);Workflow则是无状态的单次执行管道,更适合批量数据处理、报告生成、内容审核等一次性任务。理解这一区别有助于在实际项目中选择正确的应用类型。
工作流节点:搭建应用的基本模块
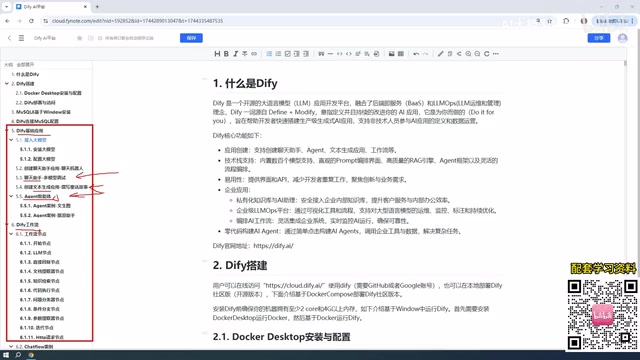
无论是Chatflow还是Workflow,都是由一个个节点组合而成的。每个节点代表一个功能模块,多个节点串联起来就构成完整的工作流程。
教程会讲解日常使用Dify时最常用的那些节点,覆盖了官方提供的大部分节点类型。每个节点的讲解都会配备实际案例——仅工作流节点部分就安排了十几个案例,再加上Chatflow、Workflow以及三类基础应用各自的案例,整套课程的实操密度相当高。这种「概念+案例」的教学方式,对理解抽象的节点编排很有帮助。
大模型接入:建议用付费API而非本地模型
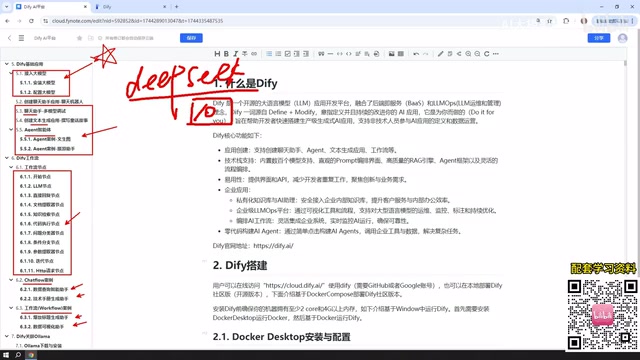
所有AI应用都要与大模型交互,因此接入模型是绕不开的第一步。教程给出的建议值得注意:优先使用付费的云端模型,而非本地部署的模型。
推荐的付费选项包括DeepSeek广告、ChatGPT等;免费途径则有百度文心一言、阿里通义千问广告,注册后通常会赠送百万级别的token,对学习练手足够用。
这里特别提到一个成本细节:付费模型并不贵。以DeepSeek为例,充值十元可以用很久——视频作者展示自己充了十元,长期使用下来还没花到一块钱。
至于本地模型,Dify同样支持整合Ollama部署的本地模型,但不作为首选推荐。原因是普通机器能跑的本地模型通常参数较小,实际效果不理想。除非你拥有高性能机器或企业级集群,能部署像DeepSeek开源的大参数模型(下载体积可达400多GB)那样的大模型,本地方案才能发挥出好效果。
Token是大语言模型计量文本长度的基本单位,并非简单等同于字符数。对于英文,1个token约对应4个字符;中文由于字符复杂,平均1个汉字约消耗1.5至2个token。云端模型通常按输入token和输出token分别计费,价格因模型规模而异。以DeepSeek为例,其API定价远低于OpenAI等国际服务,日常学习和轻量业务场景下成本几乎可以忽略不计。Ollama是一款用于在本地运行开源大语言模型的工具,支持LLaMA、Mistral、DeepSeek等多种模型,通过简单命令即可将模型下载并运行在本机。其优势是数据不出本地、无调用费用,但受限于消费级硬件的显存和算力,通常只能运行参数量较小的模型,生成质量与大型云端模型存在明显差距。
应用发布:从本地走向公网
在Dify里构建的应用,并不局限于本机使用。平台提供了多种发布方式:
- 发布为公开Web站点:生成一个所有人都能访问的链接(本地部署需配合内网穿透)。
- 嵌入到自有网站:把应用集成进你开发的网页中。
- 通过API调用:以接口方式供其他系统使用构建好的应用。
这意味着Dify不只是一个搭建工具,它完整覆盖了从开发到交付的闭环,让你搭建的AI应用能真正对外提供服务。
总结:一条清晰的Dify学习路径
整套教程的逻辑主线非常清晰:先理解Dify是什么及其特点,再完成本地Docker部署和MySQL配置,接着依次掌握聊天助手、文本生成、Agent智能体、Chatflow、Workflow五大应用类型及工作流节点,最后学会模型接入与应用发布。对于想系统入门Dify的开发者,这是一条值得参考的进阶路线图。
相关推荐

Claude Sonnet 6疑泄露,Anthropic内部模型加速惊人
Anthropic疑似泄露Sonnet 6,Meter报告称其AI研发加速1.9倍;OpenAI发布GPT-6 Cyber,GPT-6.2 Astra或将至;Google Gemini Omni 1.2 Flash登顶视频生成榜;Meta stealth模型与实时头像亮相;市场波动下Google仍投170亿美元建数据中心。

科幻小说对AI的预测有多准?
科幻小说对AI的预测有多准?本文结合Hacker News讨论,分析科幻作品在AI发展中的远见与盲区,探讨其真正价值在于启发思考而非精准预测。

SwarmEvolve:潜空间智能体集群加速进化搜索
SwarmEvolve框架让数百个低成本智能体在潜空间中集群推理,通过KV缓存共享信息,在数学发现和科学计算问题上实现快速进化搜索,中位数仅3-8分钟达到其他框架60分钟的最佳分数。