Dify一周速成:30+企业级项目实战,掌握AI应用搭建
基于 B 站课程大纲,梳理 Dify 从部署、大模型接入到工作流与应用发布的完整学习路径。
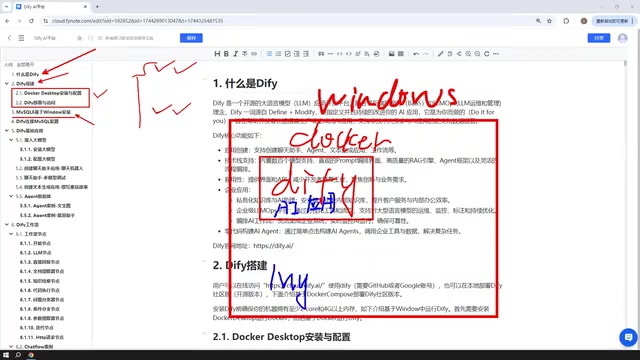
文章围绕 B 站一套主打"一周速成 + 30 多个企业级实战项目"的 Dify 课程,整理出一条从环境搭建到应用发布的完整学习路径。首先介绍 Dify 的定位与五种应用类型——聊天助手、文本生成、Agent 智能体、Chatflow 和 Workflow,前三种为基础应用,后两种属于工作流范畴。接着说明基于 Windows Docker 部署 Dify 的方案,MySQL 可放在本机、Docker 或 VMware 虚拟机中,Dify 网络均可通信。大模型接入方面建议优先使用付费 API,文心一言和通义千问提供百万级免费 token,本地小模型效果有限,大参数模型或集群部署 Ollama 才适合企业级场景。工作流部分以节点为核心,配备大量案例,最后讲解应用发布为 Web 站点、嵌入网站或 API 调用的方式。
从部署到发布,一条完整的 Dify 学习路径。工作流、智能体、知识库全部覆盖,附带大量案例实操。
Dify 是一款让 AI 应用搭建变得“快捷方便”的平台。无论你是个人开发者想做个聊天助手,还是企业团队要落地一套内部知识库系统,Dify 都提供了对应的能力。B 站上有一套围绕 Dify 展开的系列课程,主打“一周速成 + 30 多个企业级实战项目”,本文基于该课程的内容大纲,梳理出一条从环境搭建到应用发布的完整学习路径,供准备入门 Dify 的读者参考。
Dify 是什么:五种应用类型构成的能力底座
课程开篇对 Dify 的定位很明确:它是一个 AI 平台,通过这个平台可以快速构建 AI 应用,覆盖企业级和个人使用级别。进入 Dify 的创建页面后,能看到五种应用类型,这五种类型构成了 Dify 的核心能力范围。
前三种属于基础应用:聊天助手用于和 AI 模型对话;文本生成用于撰写文章、文档、小说等;Agent 智能体则比前两者更进一步——它可以调用工具来完成用户指令,比如先爬取网页再进行分析。课程在讲解这三类应用时都配备了对应案例,逐步演示操作过程。
后两种属于工作流范畴:Chatflow 和 Workflow。两者的区别可以简单理解为,Chatflow 支持与工作流进行聊天式交互,而 Workflow 更偏向一次性执行并输出结果。课程中也坦言,在没有 Dify 基础时直接讲区别意义不大,因此把详细辨析放在了后续的案例讲解中。
Agent 智能体与 Function Calling
Agent 智能体之所以能"调用工具完成任务",底层依赖的是大模型的 Function Calling(函数调用)能力——模型根据用户意图,自主决定调用哪个外部工具、传入什么参数,再把工具返回的结果纳入后续推理。Dify 中的 Agent 可以挂载内置工具或自定义 API 工具,模型在每一轮对话中判断是否需要调用,形成"思考—行动—观察"的循环。这与 Workflow 的区别在于:Workflow 的节点顺序由人预先编排,而 Agent 的执行路径由模型在运行时动态决定,灵活性更高,但可控性和可复现性相对较弱。理解这一点,有助于判断一个需求到底该用 Agent 还是该用工作流来实现。
环境搭建:Windows + Docker 部署 Dify,MySQL 放在哪都行
课程选择了基于 Windows Docker 来部署 Dify。需要说明的是,部署方式并非只有这一种——也可以基于源码部署,或者干脆不部署,直接使用官方提供的在线页面。在线页面和自建页面“非常类似,就是一样的”,区别在于:如果在线版构建的 AI 应用需要访问你本机的数据库或本机环境,就需要借助内网穿透工具把本机 IP 暴露到公网。
选择本机 Docker 部署的好处是,本机里的 MySQL 等环境 Dify 可以直接使用。课程同时给出了生产环境的建议:还是自己部署到公司内部应用比较方便。
为了让 Dify 里构建的 AI 应用能访问数据库,课程单独安排了一节 MySQL 8 在 Windows 上的安装。这个数据库也可以基于 Docker 部署,或放在 VMware 虚拟机上。Docker 安装完成后,Dify 的网络既能和 Windows 里的 MySQL 8 通信,也能和 VMware 虚拟机通信,所以 MySQL 放在哪里都是可行的。接下来还需要掌握 Dify 连接 MySQL 的配置方法,因为后续的 AI 应用要读取数据库数据、做交互式应用。
为什么需要内外网穿透
内网穿透(如 frp、ngrok、cpolar 等工具)的作用,是在本机没有公网 IP 的情况下,通过一台有公网地址的中转服务器建立隧道,把外部请求转发到你本机的某个端口。使用 Dify 官方在线版时,AI 应用运行在云端,若它需要访问你本机的 MySQL 或本机服务,就必须借助内网穿透把本机端口暴露出去,否则云端无法路由到你的局域网地址。同理,把本机部署的 Dify 应用发布为公开 Web 站点时,外部用户访问的链接也需要这条隧道才能到达你的机器。需要留意的是,穿透服务会带来额外的安全暴露面,生产环境更推荐直接部署在公司内网或具备公网入口的服务器上。
大模型接入:优先付费 API,本地模型看场景
在讲解各类应用案例之前,课程先安排了大模型接入这一步。建议是优先使用付费模型 API,比如 DeepSeek广告、ChatGPT;也有免费选项,例如百度文心一言注册后可获得免费 token,阿里通义千问广告同样提供一定额度的免费 token,课程提到这个量级“应该是百万级别的,也够用”。
关于本地模型,课程的态度比较谨慎:不建议用本机的小模型,因为“一般都比较小,使用起来效果不是太好”。不过 Dify 与 Ollama 本地部署模型的整合仍会讲解并配案例——如果机器性能非常好、下载的模型足够大,或者企业采用集群部署 Ollama 跑大参数模型,用 Dify 构建企业级应用也是可行的。课程中提到了 DeepSeek 开源的大模型,参数规模很大、下载体积达数百 G 量级,这类模型的效果通常更好。
课程讲师以自己的 DeepSeek 账户为例:充值十元钱,用了很久还不到一块钱,说明实际调用成本很低。对于担心付费门槛的初学者,这个参考值有一定说服力。
Ollama 与本地模型部署
Ollama 是一个本地大模型运行工具,提供统一的命令行与 API 接口,可以一条命令拉取并运行 Llama、Qwen、DeepSeek 等开源模型,并在本机暴露一个兼容 OpenAI 格式的接口。Dify 通过配置这个接口地址即可把 Ollama 作为模型供应商接入。本地部署的核心约束是显存与内存:模型参数量越大,所需资源越多,量化版本(如 4-bit 量化)可以在效果略有损失的前提下大幅降低资源占用。这也解释了课程为何不建议用本机小模型——参数规模不足时,指令遵循和推理能力都会明显下降,而企业级效果通常需要大参数模型配合多卡或集群部署。
工作流与节点:案例驱动的进阶部分
工作流是 Dify 中更重要的应用形态。课程介绍,Chatflow 和 Workflow 都依赖“节点”来构建——每个模块就是一个节点,多个节点串联组成完整流程。课程会讲解常见的、使用频率最高的节点,这些节点“几乎包含了 Dify 官网提供的大部分节点”,且每个节点都配有详细案例。据课程描述,仅工作流节点部分就配备了十几个案例,加上 Chatflow 和 Workflow 的案例,整体案例数量相当可观,这也是标题中“30+ 实战项目”的主要来源。
需要留意的是,课程录制时工作流在 Dify 中还是测试版本,讲师判断“现在应该也比较稳定了”。如果你在实际操作中发现界面或功能有出入,属于正常的版本演进。
应用发布:不止于本机页面
构建好的应用并非只能在 Dify 页面内使用。课程最后一部分讲解应用发布,Dify 支持把应用发布为公开的 Web 站点,生成一个大家都能访问的链接,让应用走出本机部署环境——这同样需要内外网穿透的支持。此外,构建好的 Dify 应用还可以嵌入到自己开发的网站中,或通过 API 方式调用。
学习路径小结
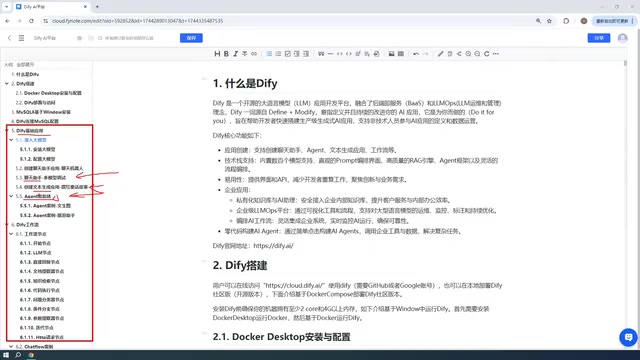
把这套课程的内容串起来,可以得到一条清晰的学习顺序:先理解 Dify 的五种应用类型,再完成 Windows Docker 部署与 MySQL 8 安装、配置 Dify 连接数据库,然后接入大模型 API(或按需整合 Ollama 本地模型),接着进入聊天助手、文本生成、Agent 智能体的基础案例,再深入到 Chatflow/Workflow 与各类节点,最后学习应用发布与集成。对于零基础读者,这条路径的每一步都有案例支撑,适合按部就班推进。
需要提醒的是,本文整理自课程的内容介绍,涉及的具体操作细节与版本表现,建议以实际操作为准。
相关推荐
达芬奇如何证明太阳是热的?一段被忽视的科学史
达芬奇如何用凹面镜实验推翻亚里士多德的冷太阳理论?本文梳理这段被忽视的科学史,揭示科学思维在十五世纪的萌芽,以及达芬奇对太阳发热和生命本质的冷峻观察。
SharpLogic:用k-CNF为LangGraph路由图做形式化查错
SharpLogic开源项目将LangGraph风格的多智能体路由与重试图映射为k-CNF,用Rust内核统计死锁与失败路径(#F计数),提供Python AgentGuard钩子与CLI,在发布前做形式化门禁检查。本文分析其原理、与评测的互补关系及社区关注的建模成本问题。
PPO训练Franka机械臂抓取放置:一个强化学习入门项目
一个用PPO算法在PyBullet中训练Franka Panda机械臂完成抓取放置任务的强化学习项目,涵盖技术栈选型、任务设计难点与未来文本/语音指令交互计划,适合入门者参考。