冻结权重下的Agent自我改进:失败轨迹的价值与边界

冻结权重下用失败轨迹优化Agent笔记,增益有限且大半来自搜索本身。
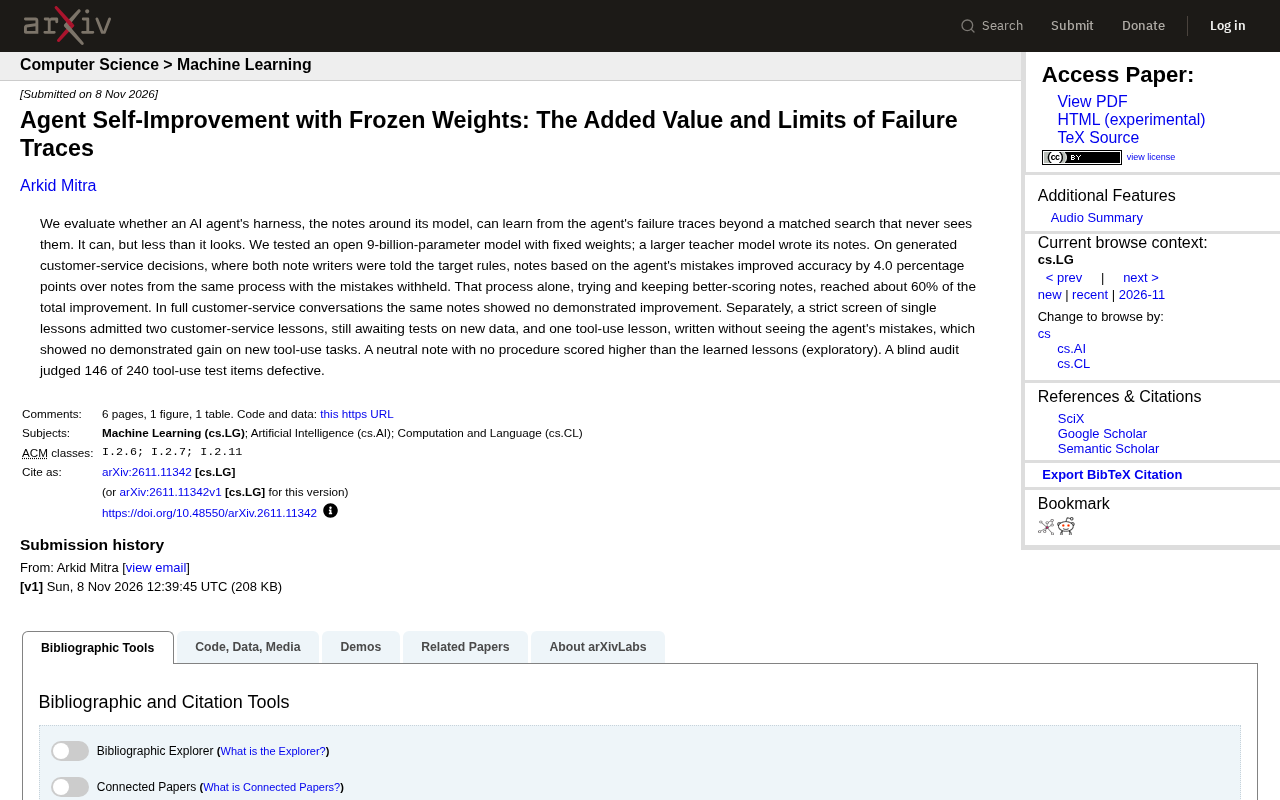
该研究探讨不更新模型参数、仅优化外部harness能否提升AI Agent表现。团队用90亿参数开源模型作执行者、更大教师模型撰写操作笔记,在客服决策任务上比较基于失败轨迹与隐去错误的笔记。结果显示失败轨迹带来4.0个百分点提升,但约60%可归因于搜索与筛选过程本身。在完整多轮对话场景中,同样的笔记未表现出可证明的改进。严格筛选下仅少数单条经验通过且尚未验证,一条中性笔记得分反而高于具体经验。盲审还发现240条工具使用测试项中146条有缺陷,评估质量堪忧。研究提示失败信号价值有限、搜索机制与评估可靠性才是关键。
AI Agent的自我改进是否一定要更新模型参数?一项最新研究给出了不同的思路:保持模型权重冻结,仅通过优化模型外部的“操作笔记”(harness)来提升Agent表现。研究团队测试了一个90亿参数的开源模型,由更大的教师模型为其撰写笔记,并重点考察了失败轨迹能否带来额外增益。结论是:有用,但远没有看起来那么多。
实验设计:冻结权重,只改笔记
研究的核心设定是“冻结权重”(Frozen Weights)——Agent的模型参数完全固定,不进行任何微调。改进的唯一途径是调整harness,即围绕模型的提示、规则和操作说明。这种设计的价值在于低成本、可解释,且避免了微调带来的灾难性遗忘和部署复杂性。
实验中,一个90亿参数的开源模型作为执行Agent,一个更大的教师模型负责撰写笔记。研究者在生成的客服决策任务上比较了两种笔记:一种基于Agent的失败轨迹撰写,另一种在撰写时隐去这些错误。两种情况下,笔记撰写者都被告知了目标规则。
冻结权重(Frozen Weights) 是迁移学习和轻量级适配中的常见策略:保持预训练模型参数不变,只在其外部添加可训练或可调整的组件。与全量微调相比,冻结权重的优势在于计算成本低、不会破坏原模型已学到的知识(避免灾难性遗忘),且部署时只需切换外部配置即可复用同一模型副本。但代价是模型内部表征无法针对新任务调整,所有改进必须通过输入侧(提示、规则、工具接口)来表达。近年来,以提示工程、检索增强和外部记忆为代表的“非参数化适配”方法,正是这一思路的延伸。
Harness 一词在Agent语境中指包裹在基础模型外部的全部控制层,包括系统提示、工具调用规范、决策规则、输出格式约束以及重试与回退逻辑。它决定了模型能力如何被组织成可执行的行为序列。与模型权重不同,harness是纯文本或代码层面的配置,修改后立即生效、可逐条审计,因而天然具备可解释性和低成本迭代的特点。本文所谓“优化harness”,本质上是在不触碰模型参数的前提下,通过教师模型生成的操作笔记来重写这层控制逻辑。
失败轨迹带来4个百分点提升,但大部分来自搜索本身
结果显示,基于失败轨迹的笔记将决策准确率提升了4.0个百分点(相比隐去错误的对照组)。这个数字看似积极,但研究者进一步拆解后发现:仅仅通过“尝试并保留得分更高的笔记”这一搜索过程本身,就贡献了总提升的约60%。换句话说,失败轨迹的“净增值”只有不到一半。
这一发现值得警惕。许多Agent改进方案在报告效果时,可能将搜索过程的收益与失败信号的价值混为一谈。研究的控制实验设计恰好分离了这两者,揭示了失败轨迹的边际贡献远小于表面数字。
失败轨迹(failure trajectories) 指Agent在执行任务时产生错误或低质量结果的完整交互记录,包括输入、中间推理步骤、工具调用和最终输出。将其作为学习信号的做法源自“从错误中学习”的思路:相比成功案例,失败案例往往能更直接地暴露模型的系统性偏差。然而,失败轨迹也携带大量与错误无关的噪声,且需要额外的标注或判定机制来确认“何为失败”。
搜索过程的收益分离 是本实验方法论上的关键。当研究者在多份候选笔记中挑选表现最佳者时,即便候选笔记完全随机,只要进行足够多次尝试并保留高分者,也会观察到准确率上升——这就是所谓的“选择偏差”或“赢家诅咒”。要区分“失败信号的价值”与“搜索本身的价值”,必须设置一个不接触失败轨迹、但经历同样搜索与筛选流程的对照组。本文正是通过这种控制设计,发现约60%的提升可归因于搜索机制,而非失败轨迹所携带的额外信息。这一拆分对任何报告“自我改进”效果的方案都具有警示意义。
完整对话场景下,增益消失
更关键的是,在完整的客服对话场景中,同样的笔记没有表现出可证明的改进。决策任务和完整对话之间的差异可能在于:多轮交互引入了更多噪声和状态依赖,单步决策的改进难以直接迁移到长程对话中。
这提示了一个现实问题:实验室中的单点任务提升,未必能转化为真实业务场景的收益。Agent的自我改进研究需要更贴近端到端的评估方式。
严格筛选下的“单条经验”:少数幸存,尚未验证
研究还设置了一个严格的单条经验筛选流程。在客服领域,有两条经验通过了筛选,但仍待在新数据上测试;在工具使用领域,有一条经验在未看到Agent错误的情况下写成,且在新任务上没有表现出可证明的增益。
一个有趣的探索性发现是:一条不包含任何操作流程的中性笔记,得分反而高于学习到的经验。这可能暗示,在冻结权重的设定下,过度具体的经验可能引入过拟合或误导,而简洁的中性指导保留了更大的灵活性。
盲审揭示评估噪声:240条测试项中146条有缺陷
研究最后进行了一次盲审,结果令人震惊:在240条工具使用测试项中,有146条被判定为有缺陷。这意味着评估集本身的质量存在严重问题,近六成测试项不可靠。这一发现对Agent评估方法论提出了根本性质疑——如果测试项本身有缺陷,那么基于这些测试得出的“改进”或“无改进”结论都可能失真。
这也解释了为何部分实验结果显得矛盾:在噪声较大的评估下,真实信号容易被掩盖。研究团队坦诚地标注了这些局限,而非掩盖问题,这种态度值得肯定。
盲审(blind review) 在此指评估者在不了解测试项来源、预期答案或实验分组的情况下,独立判断每条测试项是否有效。其目的是排除评估者偏见对结论的污染。当盲审发现近六成测试项存在缺陷(如答案歧义、前提错误、与目标规则冲突)时,意味着评估集本身的信度不足。在测量学中,这对应“构念效度”问题:测试项并未真正测量它声称测量的能力。
评估噪声对实验结论的影响是非对称的:它既可能掩盖真实的小幅改进,也可能因偶然的高分而被误读为有效。在样本量有限、效应量本就不大的Agent研究中,这种噪声足以让“有提升”与“无提升”的结论发生翻转。因此,报告增益时应同时披露评估集的缺陷率与人工审核比例,否则数字的可复现性无从谈起。
对Agent自我改进实践的启示
综合来看,这项研究传递了几个务实的信息。失败轨迹作为学习信号确有价值,但在冻结权重设定下,其独立贡献有限,且高度依赖任务形态。搜索过程本身就能带来大部分收益,工程实践中应优先保证搜索和筛选机制的有效性。
其次,评估质量是Agent研究的生命线。盲审中近六成测试项有缺陷的结果提醒我们,在追求“自我改进”之前,先确保“可靠评估”。否则,所有增益数字都可能是空中楼阁。
最后,中性笔记优于具体经验的探索性发现,或许指向一个反直觉的方向:在权重冻结时,少即是多。过于具体的操作经验可能限制了模型的泛化能力,而保留一定抽象性的指导反而更稳健。这些结论仍需更多数据验证,但为后续研究提供了有价值的假设。
相关推荐

Aircad:浏览器里的专业制图与3D建模新选择
Aircad在Hacker News展示浏览器端专业制图与3D建模能力,探索无需安装的CAD工作流。本文分析其定位、潜在优势与早期项目的不确定性。

AI做新闻,受众为何不买账?
AI正成为信息入口,但受众仍抵触AI生产新闻。本文分析信任赤字根源、信息入口与内容生产的边界,以及对媒体机构AI化的现实启示。

律所如何用AI重塑法律业务?Gilbert + Tobin的实践
澳大利亚律所Gilbert + Tobin合伙人兼CEO Sam Nickless谈律所如何用AI重新思考法律业务模式,从效率工具走向业务逻辑重构,以及CEO层级介入AI战略的意义。